Por que reiniciar seu gateway paga duas vezes pelo mesmo cache
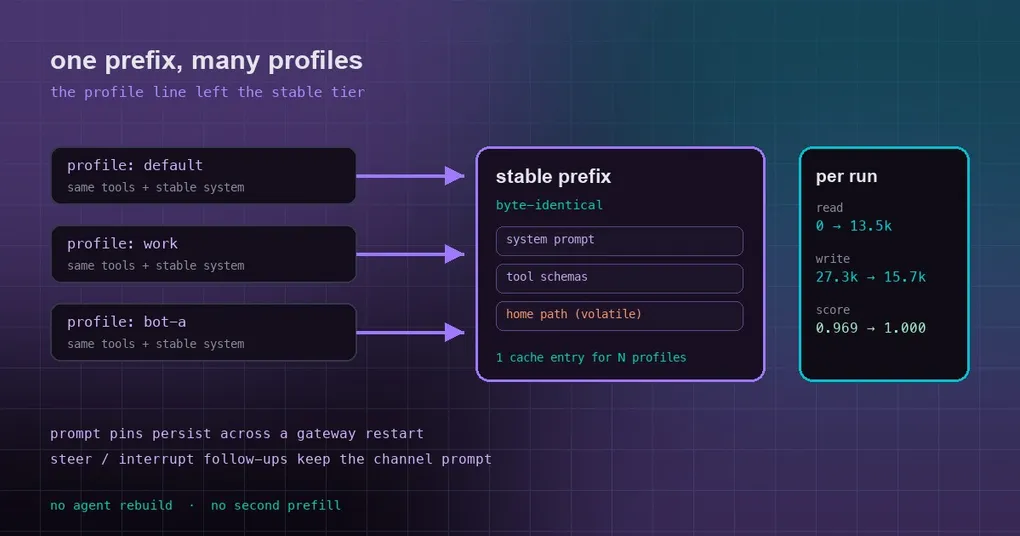
Um gateway, três profiles: o seu, um para um fluxo de trabalho de time, um bot em um grupo. Você faz uma pergunta ao bot no grupo, abre sua própria sessão um segundo depois e pergunta a mesma coisa — e as duas são cobradas como primeiros contatos. As linhas de cache write na fatura não parecem nada demais, mas a primeira mensagem depois de cada restart do gateway é lenta de um jeito que sugere que o modelo nunca viu seu system prompt.
A regra é simples: o provider só reutiliza um prefixo idêntico byte a byte. Mude um caractere nele e tudo o que vem depois é recalculado. O Hermes já divide seu system prompt em camadas stable, context e volatile exatamente por isso. Três correções mescladas em 2026-09-28 perseguiam um mesmo modo de falha: algo tinha se mudado para a camada stable que não deveria estar lá, ou algo que deveria ter sido herdado não foi.
1. Uma linha na camada stable que diferia por profile
No agent/system_prompt.py, o system prompt é montado como blocos stable, context e volatile. Os schemas de tool e o system prompt estável ficam em stable — esses bytes têm de permanecer idênticos custe o que custar, senão nada do histórico de conversa atrás deles pode ser reutilizado.
O problema era a linha Active Hermes profile: .... O trabalho dela é justamente dizer ao modelo quais diretórios ele lê e escreve, então o texto dela contém o home path do profile. E ela estava na camada stable — o que significava que cada profile diferente, cada máquina diferente, cada sessão com um home diferente produzia um prefixo estável diferente. Um gateway multiplexado servindo N profiles pagava N escritas de cache em vez de compartilhar uma única entrada.
Essa linha agora vem na camada volatile, depois do resto do conteúdo volatile. O resultado é um prefixo stable idêntico byte a byte entre profiles e homes. O novo teste no repositório diz isso sem rodeios: test_stable_tier_is_identical_across_homes.
A mudança em produção são cinco linhas adicionadas e duas removidas. O benchmark que veio no mesmo PR mostra quanto isso vale: 16 tarefas (9 padrão, 7 difíceis), 2 modelos × 2 repetições, toda requisição roteada pelo mesmo endpoint de inferência, e um grader oculto determinístico por tarefa.
| Configuração (n=32 cada) | Score | Tokens/run | $/run | Requests/run |
|---|---|---|---|---|
| reference CLI agent A, opus-5.5 | 1.000 | 146k | 0.158 | 5.4 |
| Hermes before, opus-5.5 | 0.969 | 155k | 0.245 | 6.8 |
| Hermes after, opus-5.5 | 1.000 | 152k | 0.173 | 6.1 |
| reference CLI agent B, gpt-5.6-terra | 0.995 | 145k | 0.123 | 9.4 |
| Hermes before, gpt-5.6-terra | 0.968 | 121k | 0.110 | 7.5 |
| Hermes after, gpt-5.6-terra | 1.000 | 115k | 0.108 | 7.1 |
Só o lado do cache: antes, a primeira requisição de uma execução com Opus lia 0 tokens em cache e gravava cerca de 20k. Depois, ela lê 13,5k, e as escritas de cache por execução caem de 27,3k para 15,7k.
Uma ressalva honesta para você não esperar demais: uma instalação de profile único com um home fixo já reutilizava esse prefixo entre sessões, então você não vai sentir isso ali. O ganho está em hosts multi-profile e multiplexados, e em benchmarks como o acima, em que cada execução recebe um home novo.
2. Depois de um restart, o primeiro evento interno virava o prompt A → B → A
A segunda correção é sobre o primeiro suspiro depois de um restart.
A primeira coisa que chega depois de um restart do gateway normalmente não é uma mensagem humana, mas um evento interno — um wake de kanban, uma delegação que terminou, um resume de inicialização. Esses turnos antes renderizavam um system prompt, e o próximo turno humano renderizava o original de novo: A → B → A. O custo era um cache miss de prompt mais um rebuild do agente e um re-prefill completo da conversa.
Turnos internos agora reutilizam os bytes do system prompt do último turno humano. Mecanicamente, é um snapshot de pin:
- a entrada de roteamento (state.db
gateway_routingmais um espelho emsessions.json) o armazena; - ele é gravado antes de o agente rodar em cada turno humano e lido de volta no primeiro turno interno depois de um restart;
- as leituras e as gravações são cercadas pelo session id;
/resumee o handoff da CLI limpam o pin — uma sessão trocada não pode herdar bytes antigos.
Tem um detalhe de privacidade que merece ser destacado por si só: o pin registra sob qual política de privacy.redact_pii ele foi renderizado, e bytes renderizados sob uma política diferente nunca são reutilizados. Caso contrário, um único restart poderia enviar, na forma não redigida, conteúdo que deveria ter sido redigido. Isso cobre eventos internos depois de um restart e, como o mesmo bypass também existia ali, eventos internos dentro de um mesmo processo.
3. A meia frase que um /steer deixa para trás derrubava o channel prompt
A terceira acontece depois que você corrige uma execução com /steer, ou interrompe uma geração.
O texto que você acrescentou — ou a própria interrupção — muitas vezes se torna o próximo turno. Esse turno antes começava com channel_prompt = None, o que removia do system prompt a linha de identidade do grupo do Telegram, seus channel_prompts em YAML e a identidade do Slack. O prompt mudava, então o agente em cache era reconstruído e a conversa inteira passava por re-prefill. Aí sua próxima mensagem humana desfazia tudo e você pagava duas vezes pela mesma coisa.
A correção efetiva é uma atribuição: quando não há evento pendente, o follow-up herda o channel prompt do turno que ele segue (_run_agent_queued_followup em gateway/run_turn.py). Follow-ups disparados por evento não mudam — eles continuam resolvendo o próprio prompt.
O que isso significa para você
- Hosts multi-profile: N profiles agora compartilham uma única entrada de cache de prefixo estável em vez de escrever N delas. Não há nada para configurar; basta atualizar que você tem isso.
- A primeira mensagem depois de um restart: não é mais um cold start. Ela bate no cache em que deveria bater.
- Depois de uma interrupção em um grupo: acabou o “consertou uma frase, recalculou a conversa inteira” na fatura.
Para ver as camadas e os tamanhos delas você mesmo, rode hermes prompt-size — ele imprime um detalhamento em bytes do system prompt mais os schemas de tool. A configuração multi-profile em si está no nosso guia de multiplexação e profiles; se você está ajustando roteamento, o guia da lane de modelo auxiliar explica quais chamadas gravam entradas de cache próprias. As três correções precisam do código novo, então rode hermes update (o passo a passo de upgrade). E como é a mesma semana: veja como o MoA evita quebrar esse cache — o guia de Mixture of Agents.