Pourquoi redémarrer votre gateway vous fait payer deux fois le même cache
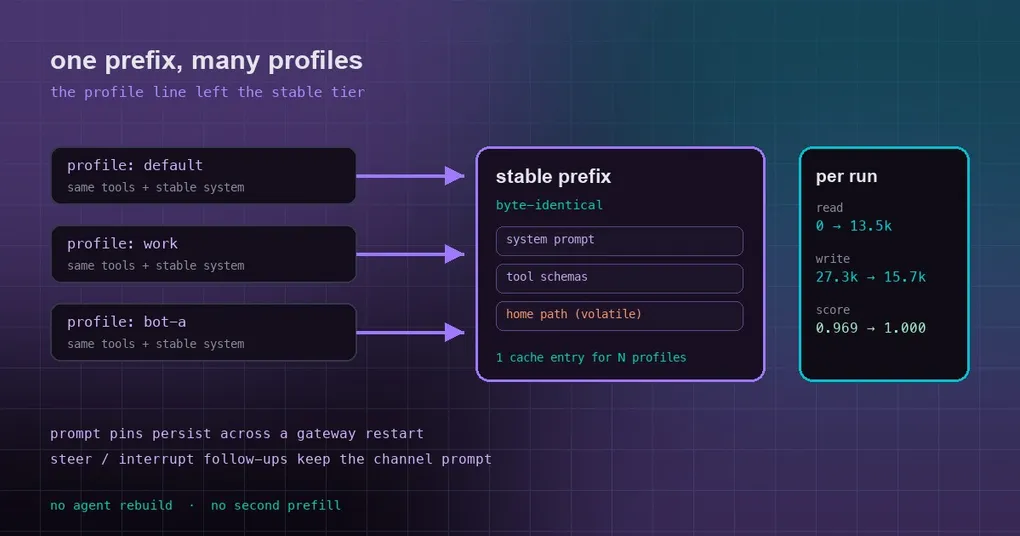
Un gateway, trois profiles : le vôtre, un pour un workflow d’équipe, un bot dans un groupe de discussion. Vous posez une question au bot dans le groupe, vous ouvrez votre propre session une seconde plus tard et vous demandez la même chose, et les deux sont facturés comme des premiers contacts. Les lignes cache write de la facture n’ont rien d’étonnant, et pourtant le premier message après chaque redémarrage du gateway est lent d’une manière qui laisse penser que le modèle n’a jamais vu votre system prompt.
La règle est simple : le provider ne réutilise qu’un préfixe identique octet pour octet. Changez un seul caractère et tout ce qui suit est recalculé. C’est exactement pour cette raison qu’Hermes découpe son system prompt en paliers stable, context et volatile. Trois correctifs fusionnés le 2026-09-28 couraient après un même mode de défaillance : quelque chose avait migré dans le palier stable alors qu’il n’y avait rien à y faire, ou quelque chose qui aurait dû être hérité ne l’était pas.
1. Une ligne du palier stable qui différait selon le profile
Dans agent/system_prompt.py, le system prompt est assemblé en blocs stable, context et volatile. Les schémas d’outils et le system prompt stable vivent dans stable — ces octets doivent rester identiques quoi qu’il arrive, sinon aucun de l’historique de conversation qui les suit ne peut être réutilisé.
Le problème venait de la ligne Active Hermes profile: .... Son unique rôle est de dire au modèle quels répertoires il lit et écrit, donc son texte contient le home path du profile. Elle se trouvait dans le palier stable — ce qui signifie que chaque profile différent, chaque machine différente, chaque session avec un home différent produisait un préfixe stable différent. Un gateway multiplexé servant N profiles payait N écritures de cache au lieu de partager une seule entrée.
Cette ligne voyage maintenant dans le palier volatile, après le reste du contenu volatile. Le résultat est un préfixe stable identique octet pour octet d’un profile et d’un home à l’autre. Le nouveau test du dépôt le dit sans détour : test_stable_tier_is_identical_across_homes.
Le changement en production, ce sont cinq lignes ajoutées et deux supprimées. Le benchmark livré avec la même PR montre ce que cela vaut : 16 tâches (9 standard, 7 difficiles), 2 modèles × 2 répétitions, chaque requête routée vers le même endpoint d’inférence, et un grader caché déterministe par tâche.
| Configuration (n=32 each) | Score | Tokens/run | $/run | Requests/run |
|---|---|---|---|---|
| reference CLI agent A, opus-5.5 | 1.000 | 146k | 0.158 | 5.4 |
| Hermes before, opus-5.5 | 0.969 | 155k | 0.245 | 6.8 |
| Hermes after, opus-5.5 | 1.000 | 152k | 0.173 | 6.1 |
| reference CLI agent B, gpt-5.6-terra | 0.995 | 145k | 0.123 | 9.4 |
| Hermes before, gpt-5.6-terra | 0.968 | 121k | 0.110 | 7.5 |
| Hermes after, gpt-5.6-terra | 1.000 | 115k | 0.108 | 7.1 |
Côté cache uniquement : avant, la première requête d’un run Opus lisait 0 token en cache et en écrivait environ 20k. Après, elle en lit 13,5k, et les écritures de cache par run passent de 27,3k à 15,7k.
Une mise en garde honnête, pour que vous n’en attendiez pas trop : une installation mono-profile avec un home fixe réutilisait déjà ce préfixe d’une session à l’autre, vous ne sentirez donc pas la différence là-bas. Le gain concerne les hôtes multi-profile et multiplexés, et les benchmarks comme celui ci-dessus où chaque run repart d’un home neuf.
2. Après un redémarrage, le premier événement interne faisait basculer le prompt A → B → A
Le deuxième correctif concerne le premier souffle après un redémarrage.
La première chose qui arrive après un redémarrage du gateway n’est généralement pas un message humain mais un événement interne — un réveil kanban, une délégation qui se termine, une reprise au démarrage. Ces tours-là rendaient un system prompt, puis le tour humain suivant rendait de nouveau l’original : A → B → A. Le coût, c’était un cache miss de prompt plus une reconstruction de l’agent, et un re-prefill complet de la conversation.
Les tours internes réutilisent désormais les octets du system prompt du dernier tour humain. Mécaniquement, c’est un instantané épinglé :
- l’entrée de routage (la table
gateway_routingde state.db plus un miroirsessions.json) le stocke ; - il est écrit avant l’exécution de l’agent à chaque tour humain, et relu au premier tour interne après un redémarrage ;
- les lectures et les écritures sont encadrées sur l’id de session ;
/resumeet le handoff vers le CLI effacent l’épinglage — une session changée ne doit pas hériter d’anciens octets.
Un détail de confidentialité mérite d’être signalé à part : l’épinglage enregistre sous quelle politique privacy.redact_pii il a été rendu, et les octets rendus sous une autre politique ne sont jamais réutilisés. Sinon, un simple redémarrage pourrait envoyer sous forme non expurgée du contenu qui aurait dû l’être. Cela couvre les événements internes après un redémarrage et, comme le même contournement existait là aussi, les événements internes au sein d’un même processus.
3. La demi-phrase laissée par un /steer faisait tomber le channel prompt
Le troisième se produit après que vous avez corrigé un run avec /steer, ou interrompu une génération.
Le texte que vous avez ajouté — ou l’interruption elle-même — devient souvent le tour suivant. Ce tour démarrait avec channel_prompt = None, ce qui retirait du system prompt la ligne d’identité du groupe Telegram, vos channel_prompts YAML et l’identité Slack. Le prompt changeait, donc l’agent en cache était reconstruit et toute la conversation re-préremplie. Puis votre message humain suivant rebasculait l’ensemble et vous payiez deux fois la même chose.
Le correctif effectif tient en une affectation : quand aucun événement n’est en attente, le follow-up hérite du channel prompt du tour qu’il suit (_run_agent_queued_followup dans gateway/run_turn.py). Les follow-ups adossés à un événement ne changent pas — ils résolvent toujours leur propre prompt.
Ce que cela change pour vous
- Hôtes multi-profile : N profiles partagent désormais une seule entrée de cache pour le préfixe stable au lieu d’en écrire N. Il n’y a rien à configurer : mettez à jour, et c’est en place.
- Le premier message après un redémarrage : plus un cold start. Il atteint le cache qu’il aurait dû atteindre.
- Après une interruption dans un groupe de discussion : fini le « une phrase corrigée, toute la conversation recalculée » sur la facture.
Pour voir les paliers et leurs tailles vous-même, lancez hermes prompt-size — il affiche une répartition en octets du system prompt et des schémas d’outils. La configuration multi-profile elle-même est traitée dans notre guide du multiplexage et des profiles ; si vous ajustez le routage, le guide des lanes de modèles auxiliaires explique quels appels écrivent leurs propres entrées de cache. Les trois correctifs exigent le nouveau code, donc lancez hermes update (le guide pas à pas de la mise à niveau). Et puisque c’est la même semaine : voici comment MoA évite de casser ce cache — le guide Mixture of Agents.