Mixture of Agents expliqué : payer deux fois, obtenir une meilleure réponse
Certaines tâches sont pénibles non pas parce qu’elles sont difficiles à coder, mais parce qu’elles sont difficiles à penser. Réécrire l’architecture d’un ordonnanceur qui tourne depuis trois ans et que personne n’ose toucher. Reconstituer la chronologie d’un incident à partir d’un log de 45 Mo. Vous posez trois fois la même question et obtenez trois réponses, chacune légèrement fausse d’une manière différente — ensemble, elles seraient justes.
Mixture of Agents (MoA) transforme « demandez à trois modèles » en pipeline : plusieurs modèles de référence analysent d’abord le problème, et un aggregator lit leurs conseils et fait le vrai travail. Cet article va de son fonctionnement à qui paie la facture, et se termine par un changement récent facile à mal interpréter.
1. MoA en une phrase
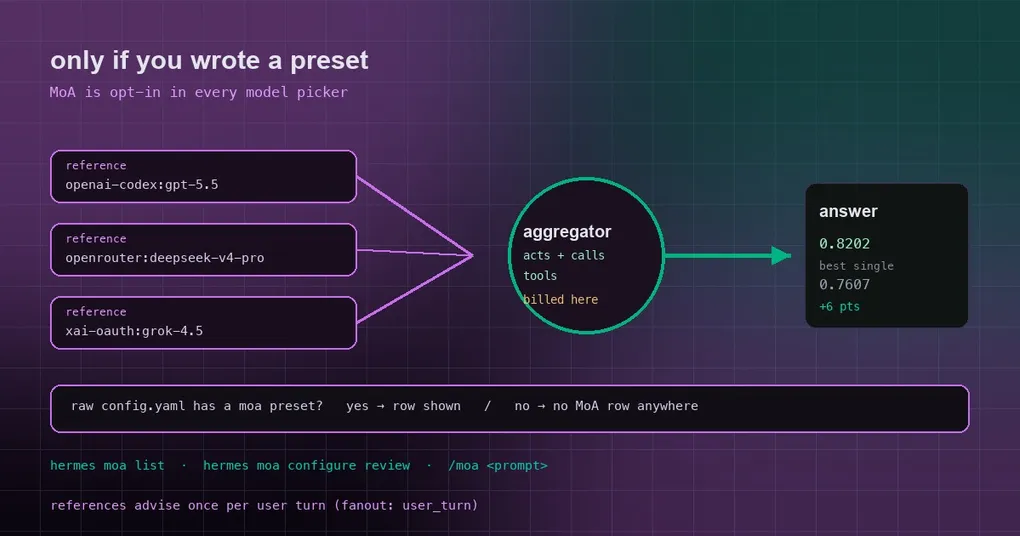
MoA n’est ni un outil ni un interrupteur — c’est un provider de modèle virtuel. Chaque preset nommé que vous configurez apparaît comme un modèle sélectionnable sous le provider moa, donc vous pouvez le choisir partout où vous choisissez un modèle : CLI, TUI, gateway, dashboard, application desktop. Structurellement, il se situe au même niveau que anthropic ou openrouter.
Une fois un preset sélectionné :
- Les modèles de référence passent en premier. Ils ne reçoivent que le texte user et assistant de la conversation — pas le system prompt de Hermes, ni la transcription des tool calls — ce qui garde ces appels bon marché et évite les rejets des providers stricts.
- L’aggregator est le modèle acteur. Il est appelé avec le schéma d’outils Hermes normal, il écrit la réponse que vous voyez, et il émet des tool calls que Hermes exécute comme d’habitude.
- À l’itération de modèle suivante, tout le processus MoA repart sur la conversation mise à jour, résultats d’outils compris.
Voilà le modèle mental : l’aggregator est le protagoniste, les références sont des conseillers consultés une fois par tour.
2. Le configurer
Trois chemins possibles, choisissez celui qui convient :
- Dashboard → Models → Model Settings → Mixture of Agents
- Desktop app → Settings → Model → Mixture of Agents
- En ligne de commande :
hermes moa configure [preset-name]
Ou écrivez directement config.yaml. Voici le preset par défaut documenté :
moa:
  default_preset: default
  presets:
    default:
      reference_models:
        - provider: openai-codex
          model: gpt-5.5
        - provider: openrouter
          model: deepseek/deepseek-v4-pro
      aggregator:
        provider: openrouter
        model: anthropic/claude-opus-4.8
      enabled: true
La config stocke des paires provider/modèle explicites, ce qui vous permet de mélanger les fournisseurs et d’utiliser deux modèles du même fournisseur. Deux champs de température facultatifs (reference_temperature, aggregator_temperature) ne sont simplement pas envoyés s’ils sont omis, ce qui laisse chaque modèle utiliser la valeur par défaut de son provider — le même comportement qu’un agent mono-modèle.
Gérer les presets depuis un terminal :
hermes moa list                 # affiche les slots actuels
hermes moa configure review     # crée ou met à jour un preset nommé review
hermes moa delete review        # supprime un preset
Trois façons de l’utiliser concrètement :
/model review --provider moa        # bascule cette session sur le preset review
/moa design a migration plan for this flaky test cluster    # one shot, puis retour à votre modèle précédent
/moa est délibérément un raccourci one-shot : il bascule temporairement sur le preset par défaut, envoie votre prompt, puis restaure le modèle sur lequel vous étiez. Il ne modifie jamais votre sélection de modèle, donc un prompt normal ne peut pas vous faire basculer accidentellement sur MoA. Un /moa tout seul, sans prompt, affiche simplement l’usage.
3. Qui est facturé
C’est la partie que les gens ratent : c’est l’aggregator qui paie tout le run. Il exécute chaque étape de la boucle d’outils, donc presque tout le coût d’un preset atterrit chez le provider de l’aggregator ; les références conseillent une fois par tour utilisateur à la cadence par défaut.
Le piège classique : votre modèle principal tourne sur un provider par abonnement, et l’aggregator du preset se trouve sur un autre. Ce tour est facturé chez le provider de l’aggregator, pas sur votre abonnement. Pour éviter la surprise, hermes moa list et hermes moa configure affichent une ligne supplémentaire chaque fois que le provider de l’aggregator diffère de model.provider, et l’éditeur desktop ainsi que /model marquent le slot aggregator comme le modèle acteur, celui qui est facturé.
La fréquence d’exécution des conseillers, c’est le réglage fanout, et il fait varier le coût directement :
fanout: user_turn(la valeur par défaut) — les conseillers tournent une fois, sur le premier message de chaque tour utilisateur, et l’aggregator acteur traverse seul le reste de la boucle d’outils. Le moins cher par construction : le coût des conseillers ne se multiplie pas avec les tool calls.fanout: per_iteration— les conseillers repartent à chaque itération d’outils, leurs conseils suivent donc toujours les derniers résultats, au prix d’une latence et d’une dépense de conseillers multipliées par le nombre de tool calls d’un tour.fanout: every_n:3— le juste milieu : les conseillers tournent à la première itération de chaque tour utilisateur, puis toutes les trois itérations d’outils (n’importe quel N de 2 ou plus convient). Les itérations intermédiaires réutilisent les derniers conseils, donc l’aggregator a encore un avis à chaque étape — simplement rafraîchi tous les N pas. Le compteur repart à zéro à chaque nouveau message utilisateur.
Les valeurs mal formées retombent sur user_turn. À noter que la valeur par défaut a elle-même changé : avant juillet 2026, c’était per_iteration. Les presets qui veulent un conseil à chaque pas le définissent explicitement.
4. Le changement actuel : pas de preset, pas de ligne MoA
Voici le correctif de comportement récent (PR #126509, issue #63353) qu’il est facile de lire comme « MoA a été désactivé ».
La ligne du sélecteur de modèle était construite à partir de la config fusionnée, et la config par défaut contient un squelette de preset MoA synthétisé. Donc même si vous n’aviez jamais écrit de bloc moa:, votre liste de modèles affichait une ligne de provider MoA avec un preset default synthétisé — ce qui donnait l’impression que MoA était actif par défaut.
La ligne est désormais conditionnée par _raw_config_has_enabled_moa_preset(), qui lit votre config.yaml brut sans fusionner les valeurs par défaut : la ligne n’apparaît que si vous avez activé vous-même un preset (ou si vous portez une ancienne config MoA à plat). L’inventaire du CLI et le sélecteur interactif du gateway partagent un même constructeur de ligne, donc les deux surfaces ont été corrigées d’un coup.
En pratique : si vous n’avez jamais configuré MoA, votre liste /model est plus courte et plus propre. Si vous l’avez fait, rien ne change — vos presets apparaissent toujours exactement là où ils étaient.
5. Les détails à connaître
- Le prompt cache survit. Sélectionner un preset MoA est une sélection de modèle normale : cela ne réécrit pas le contexte passé, n’échange pas les toolsets et ne reconstruit pas le system prompt en pleine conversation. La sortie des références est ajoutée comme son propre message terminal plutôt que fusionnée dans le vôtre, si bien que le préfixe en cache reste intact. Les templates qui imposent une alternance stricte user/assistant (templates Jinja de llama.cpp et vLLM, certaines routes OpenRouter) rejettent cela avec un 400 ; Hermes relance cette seule requête en fusionnant les deux messages user adjacents, mémorise la préférence de ce destinataire pour le reste de la session, et laisse tous les autres destinataires sur la forme stable pour le cache.
- Les limites de sortie appartiennent au provider. Les plafonds de tokens de sortie au niveau du preset et par slot ne sont plus pris en charge ; ce sont les valeurs par défaut du provider qui s’appliquent.
- Filtre de confidentialité :
moa.privacy_filterest désactivé par défaut.displayn’expurge que les surfaces visibles par l’utilisateur (les blocs de référence dans l’UI et les enregistrements écrits parsave_traces) ;fullexpurge aussi le texte des conseillers injecté dans le prompt de l’aggregator. Les formes d’identifiants — préfixes de clés API, JWT, clés privées, chaînes de connexion DB — sont prises en charge par le mécanisme central d’expurgation des secrets de Hermes. - Profondeur de raisonnement par slot : les slots de référence comme d’aggregator peuvent définir
reasoning_effort(none,minimal,low,medium,high,xhigh,max,ultra), ce qui permet à un modèle de jouer le conseiller rapide et à un autre le penseur profond. - Un interrupteur par preset :
enabled: falsedésactive le fan-out des références de ce preset, donc l’aggregator agit seul, exactement comme si vous l’aviez sélectionné comme modèle ordinaire. - Limites : un aggregator ne peut pas être un autre preset MoA (les arbres récursifs sont bloqués) ; l’échec d’identifiant d’un seul modèle de référence n’interrompt pas le tour — l’échec est inclus dans le contexte des références et le run continue ; MoA n’est plus listé sous
hermes tools, et il n’y a pas de toolsetmoaà activer. - Il peut servir de fallback : un preset fonctionne comme entrée
fallback_providers(par exemple{provider: moa, model: <preset>}). Quand le modèle principal échoue, Hermes active le preset lui-même — références et aggregator, avecmoa://localcomme endpoint virtuel.
6. Le bench officiel : environ six points au-dessus de son meilleur composant
Sur HermesBench, un preset à deux modèles (gpt-5.5 en référence, claude-opus-4.8 en aggregator) :
| Configuration | HermesBench score |
|---|---|
| Opus aggregator (opus-4.8 + gpt-5.5 reference) — MoA | 0.8202 |
anthropic/claude-opus-4.8 alone |
0.7607 |
openai/gpt-5.5 alone |
0.7412 |
Il ne fait donc pas une moyenne : il dépasse son composant le plus fort d’environ six points, ce qui justifie d’acheter une seconde perspective sur les tâches difficiles.
7. Quand ne pas l’utiliser
MoA augmente le nombre d’appels de modèle — une itération peut signifier plusieurs appels de référence plus l’appel de l’aggregator. Pour les tâches du quotidien, les conversions de format et les simples lookups, un modèle unique est plus rapide et moins cher. Il justifie son coût sur les travaux où une seule hypothèse erronée signifie refaire une demi-journée de travail : conception d’architecture, post-mortems d’incident, plans de migration, revue d’un refactor complexe.
Si vous ajustez le routage des modèles, combinez ceci avec notre guide des lanes de modèles auxiliaires (quels appels passent par la lane auxiliaire) et le guide des model overrides ; pour la reprise automatique quand le modèle principal échoue, le guide des fallbacks à trois couches couvre la chaîne. Et pour comprendre pourquoi MoA ne dérange pas le cache de préfixe, voyez l’article sur le partage de cache. Détails de commande : référence hermes moa.