Mixture of Agents, explicado: paga el doble y obtén una respuesta mejor
Hay trabajos que resultan molestos no porque sean difíciles de programar, sino porque son difíciles de pensar. Reescribir la arquitectura de un scheduler que lleva tres años funcionando y que nadie se atreve a tocar. Reconstruir la cronología de un incidente a partir de un log de 45 MB. Preguntas lo mismo tres veces y recibes tres respuestas, cada una un poco equivocada de una forma distinta; juntas estarían bien.
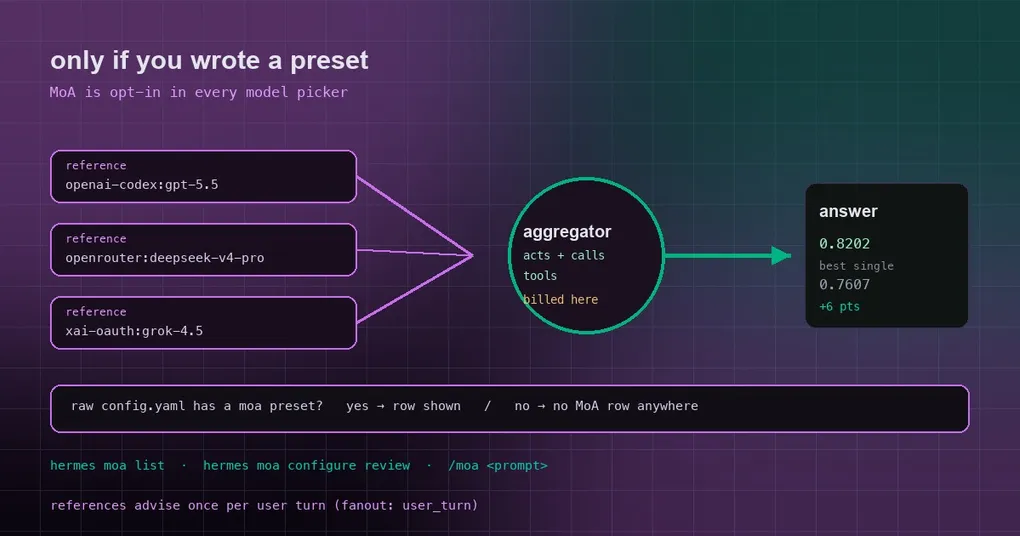
Mixture of Agents (MoA) convierte «pregunta a tres modelos» en un pipeline: varios reference models analizan primero el problema y un aggregator lee sus consejos y hace el trabajo real. Este artículo va desde cómo se ejecuta hasta quién paga por ello, y termina con un cambio reciente fácil de malinterpretar.
1. MoA en una frase
MoA no es una tool ni un interruptor: es un provider de modelos virtual. Cada preset con nombre que configures aparece como un modelo seleccionable bajo el provider moa, así que puedes elegirlo allí donde elijas un modelo: CLI, TUI, gateway, dashboard, app de escritorio. Estructuralmente está al mismo nivel que anthropic o openrouter.
Una vez seleccionado un preset:
- Los reference models se ejecutan primero. Reciben solo el texto de usuario y asistente de la conversación —ni el system prompt de Hermes ni la transcripción de llamadas a tools—, lo que mantiene esas llamadas baratas y evita rechazos de providers estrictos.
- El aggregator es el modelo que actúa. Se le llama con el esquema de tools normal de Hermes, escribe la respuesta que ves y emite llamadas a tools, que Hermes ejecuta como siempre.
- En la siguiente iteración del modelo, todo el proceso de MoA vuelve a ejecutarse sobre la conversación actualizada, resultados de tools incluidos.
Ese es el modelo mental: el aggregator es el protagonista y los references son asesores a los que se consulta una vez por turno.
2. Cómo configurarlo
Tres rutas; elige la que mejor te encaje:
- Dashboard → Models → Model Settings → Mixture of Agents
- App de escritorio → Settings → Model → Mixture of Agents
- Línea de comandos:
hermes moa configure [preset-name]
O escribe config.yaml directamente. Este es el preset por defecto documentado:
moa:
  default_preset: default
  presets:
    default:
      reference_models:
        - provider: openai-codex
          model: gpt-5.5
        - provider: openrouter
          model: deepseek/deepseek-v4-pro
      aggregator:
        provider: openrouter
        model: anthropic/claude-opus-4.8
      enabled: true
La configuración guarda pares explícitos de provider/modelo, así que puedes mezclar proveedores y usar dos modelos del mismo proveedor. Dos campos opcionales de temperatura (reference_temperature, aggregator_temperature) simplemente no se envían cuando se omiten, dejando que cada modelo use el valor por defecto de su provider: el mismo comportamiento que un agente de un solo modelo.
Gestionar presets desde una terminal:
hermes moa list                 # muestra los slots actuales
hermes moa configure review     # crea o actualiza un preset llamado review
hermes moa delete review        # elimina un preset
Tres formas de usarlo de verdad:
/model review --provider moa        # cambia esta sesión al preset review
/moa design a migration plan for this flaky test cluster    # one shot, then back to your previous model
/moa es deliberadamente conveniencia de un solo uso: cambia temporalmente al preset por defecto, envía tu prompt y restaura el modelo en el que estuvieras. Nunca modifica tu selección de modelo, así que un prompt normal no puede llevarte a MoA por accidente. Un /moa a secas, sin prompt, solo imprime el uso.
3. A quién se le factura
Esta es la parte que la gente se salta: el aggregator paga toda la ejecución. Ejecuta cada paso del bucle de tools, así que casi todo el coste de un preset recae en el provider del aggregator; los references aconsejan una vez por turno de usuario con la cadencia por defecto.
La trampa clásica: tu modelo principal va con un provider de suscripción y el aggregator del preset está en otro distinto. Ese turno se factura al provider del aggregator, no a tu suscripción. Para evitar la sorpresa, hermes moa list y hermes moa configure imprimen una línea extra siempre que el provider del aggregator difiera de model.provider, y el editor de escritorio y /model marcan el slot del aggregator como el modelo que actúa y que se factura.
La frecuencia con la que se ejecutan los asesores es el ajuste fanout, y escala el coste directamente:
fanout: user_turn(el valor por defecto): los asesores se ejecutan una vez, con el primer mensaje de cada turno de usuario, y el aggregator que actúa continúa el resto del bucle de tools solo. Lo más barato por construcción: el coste de los asesores no se multiplica con las llamadas a tools.fanout: per_iteration: los asesores se vuelven a ejecutar en cada iteración de tools, así que su consejo siempre sigue los últimos resultados, a cambio de multiplicar la latencia y el gasto de los asesores por el número de llamadas a tools de un turno.fanout: every_n:3: el punto intermedio: los asesores se ejecutan en la primera iteración de cada turno de usuario y luego cada tres iteraciones de tools (vale cualquier N de 2 o más). Las iteraciones intermedias reutilizan la última orientación de los asesores, así que el aggregator sigue teniendo consejo en cada paso; solo se refresca cada N pasos. El contador se reinicia con cada mensaje nuevo del usuario.
Los valores malformados vuelven a user_turn. Ojo: el propio valor por defecto cambió; antes de julio de 2026 era per_iteration. Los presets que quieren asesoramiento en cada paso lo ponen explícitamente.
4. El cambio actual: sin preset, sin fila de MoA
Esta es la corrección reciente de comportamiento (PR #126509, issue #63353) que es fácil leer como «MoA estaba desactivado».
La fila del selector de modelos se construía a partir de la config fusionada, y la config por defecto lleva un esqueleto sintetizado de preset MoA. Así que, aunque nunca hubieras escrito un bloque moa:, tu lista de modelos mostraba una fila de provider MoA con un preset default sintetizado, lo que hacía parecer que MoA venía activado por defecto.
La fila ahora está condicionada por _raw_config_has_enabled_moa_preset(), que lee tu config.yaml sin fusionar los valores por defecto: la fila solo aparece si has activado tú mismo un preset (o si arrastras una config MoA plana heredada). El inventario del CLI y el selector interactivo del gateway comparten un único constructor de filas, así que las dos superficies se arreglaron a la vez.
En la práctica: si nunca configuraste MoA, tu lista de /model es más corta y más limpia. Si lo hiciste, no cambia nada: tus presets siguen apareciendo exactamente donde aparecían.
5. Detalles que conviene saber
- La cache de prompt sobrevive. Seleccionar un preset MoA es una selección de modelo normal: no reescribe el contexto pasado, no cambia toolsets ni reconstruye el system prompt a mitad de conversación. La salida de los references se añade como su propio mensaje final en lugar de fusionarse con el tuyo, así que el prefijo cacheado queda intacto. Las plantillas que exigen estricta alternancia usuario/asistente (plantillas Jinja de llama.cpp y vLLM, algunas rutas de OpenRouter) rechazan eso con un 400; Hermes reintenta esa petición concreta fusionando los dos mensajes de usuario adyacentes, recuerda la preferencia de ese destino para el resto de la sesión y deja todos los demás destinos con la forma estable para la cache.
- Los límites de salida son del provider. Ya no se admiten límites de tokens de salida a nivel de preset ni por slot; se aplican los valores por defecto del provider.
- Filtro de privacidad:
moa.privacy_filterestá desactivado por defecto.displayredacta solo las superficies visibles para el usuario (los bloques de references en la UI y los registros que escribesave_traces);fullredacta además el texto de los asesores inyectado en el prompt del aggregator. Las formas de credencial —prefijos de API key, JWT, claves privadas, cadenas de conexión de bases de datos— las gestiona el redactor central de secretos de Hermes. - Profundidad de razonamiento por slot: tanto los slots de references como el del aggregator pueden fijar
reasoning_effort(none,minimal,low,medium,high,xhigh,max,ultra), así que un modelo puede actuar como asesor rápido y otro como pensador profundo. - Un interruptor de apagado por preset:
enabled: falsedesactiva el fan-out de references de ese preset, así que el aggregator actúa solo exactamente como si lo hubieras seleccionado como un modelo normal. - Límites: un aggregator no puede ser otro preset MoA (los árboles recursivos están bloqueados); el fallo de credencial de un solo reference model no aborta el turno, el fallo se incluye en el contexto de references y la ejecución continúa; MoA ya no aparece en
hermes toolsy no hay ningún toolsetmoaque activar. - Puede ser un fallback: un preset funciona como entrada de
fallback_providers(por ejemplo{provider: moa, model: <preset>}). Cuando el primario falla, Hermes activa el propio preset —references y aggregator— conmoa://localcomo endpoint virtual.
6. El bench oficial: unos seis puntos por encima de su mejor componente
En HermesBench, un preset de dos modelos (gpt-5.5 como reference y claude-opus-4.8 como aggregator):
| Configuration | HermesBench score |
|---|---|
| Opus aggregator (opus-4.8 + gpt-5.5 reference) — MoA | 0.8202 |
anthropic/claude-opus-4.8 alone |
0.7607 |
openai/gpt-5.5 alone |
0.7412 |
Así que no es un promedio: supera a su componente más fuerte en unos seis puntos, que es el argumento a favor de comprar una segunda perspectiva en las tareas difíciles.
7. Cuándo no usarlo
MoA aumenta el número de llamadas a modelos: una iteración puede significar varias llamadas a references más la llamada al aggregator. Para tareas del día a día, conversiones de formato y búsquedas simples, un solo modelo es más rápido y más barato. Se gana su coste en los trabajos donde una suposición equivocada significa rehacer media jornada de trabajo: diseño de arquitectura, post-mortems de incidentes, planes de migración, revisión de un refactor complejo.
Si estás ajustando el enrutado de modelos, combina esto con nuestra guía del carril de modelos auxiliares (qué llamadas pasan por el carril auxiliar) y la guía de overrides de modelo; para la toma de control automática cuando falla el modelo primario, la guía de fallback en tres capas cubre la cadena. Y para entender por qué MoA no perturba la cache de prefijo, mira el artículo sobre el reparto de cache. Detalles de comandos: referencia de hermes moa.