Mixture of Agents 完全指南:多付一份钱,换来更靠谱的答案
手上有一种活特别烦人:不是难在写代码,而是难在“得想清楚”。比如一个跑了三年、谁都不敢动的任务调度器要重写架构;比如一段线上事故的时间线要从 45MB 日志里还原。你把同一个问题问三遍,三个模型给出的答案都差一点——各自缺一块,合起来才对。
Mixture of Agents(MoA)就是把“问三个模型”这件事做成了流水线:几个参考模型先各自分析,一个聚合模型读着它们的意见来动手干活。这篇从“它到底怎么跑”讲到“钱算在谁头上”,最后解释新版本里那个容易被误解的变化。
一、一句话理解 MoA
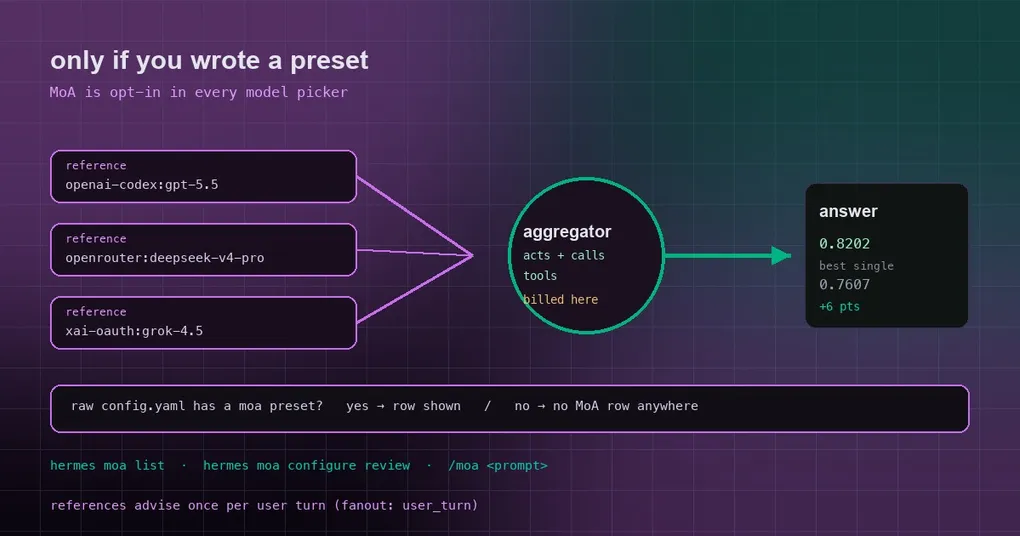
MoA 在 Hermes 里不是工具、也不是开关,而是一个虚拟模型提供者:你配置的每个具名预设,都会以“moa 提供者下的一个可选模型”的身份出现。所以你可以在任何能选模型的地方选它——CLI、TUI、网关、Dashboard、Desktop,方法论上它和 anthropic、openrouter 是同一层级的东西。
选中一个预设之后:
- 参考模型先跑。它们只拿到对话里的用户 / 助手文本,不拿 Hermes 的系统提示,也不拿工具调用记录——所以这些调用又便宜又不会被严格的服务端拒绝。
- 聚合模型是“出面干活的那个”。它带着正常的 Hermes 工具 schema 被调用,写出你看到的回答、发起工具调用;工具由 Hermes 正常执行。
- 下一次模型迭代时,整个 MoA 流程在更新后的对话(含工具结果)上再跑一遍。
理解这一点就够了:聚合模型是主角,参考模型是每轮咨询一次的顾问。
二、怎么配
三条路,挑顺手的:
- Dashboard → Models → Model Settings → Mixture of Agents
- Desktop 应用 → Settings → Model → Mixture of Agents
- 命令行:
hermes moa configure [预设名]
也可以直接写 config.yaml。下面是官方文档里的默认预设结构:
moa:
  default_preset: default
  presets:
    default:
      reference_models:
        - provider: openai-codex
          model: gpt-5.5
        - provider: openrouter
          model: deepseek/deepseek-v4-pro
      aggregator:
        provider: openrouter
        model: anthropic/claude-opus-4.8
enabled: true配置里写的是显式的 provider / model 对,所以你可以跨厂商混合,也可以同一个厂商放两个模型。两个可选的温度字段(reference_temperature、aggregator_temperature)不写就不发温度参数,让各模型走自己 provider 的默认值——和单模型时的行为一致。
终端里管理预设:
hermes moa list                 # 看当前各槽位
hermes moa configure review     # 新建或更新名为 review 的预设
hermes moa delete review        # 删掉一个预设
选它来干活有三种方式:
/model review --provider moa    # 本会话切到 review 预设
/moa 帮我设计这个调度器的迁移方案   # 只这一次:走默认预设,之后再切回你原来的模型
/moa 是一次性的便利糖:它临时切到默认预设、发一条消息、然后恢复你之前的模型。它不会顺手改掉你的模型选择——这是刻意的设计,免得一句普通提问把会话模型换掉。不带参数直接敲 /moa 只会打印用法。
三、钱算在谁头上
这是最容易被忽略的一点:聚合模型为整轮运行付费。它跑工具循环的每一步,所以一个预设几乎全部的成本都落在聚合模型的 provider 上;参考模型按默认节奏只在你每次发消息时咨询一次。
有个很常见的坑:你的主模型跑在某个订阅制 provider 上,预设里的聚合模型却在别家——那么这轮运行记在聚合模型那边,不记在你的订阅里。为了避免误判,hermes moa list 和 hermes moa configure 在聚合 provider 与 model.provider 不一致时会额外打印一行提示,Desktop 编辑器和 /model 也会把聚合槽位标成“出面且计费”的那个。
顾问多久出场一次,由 fanout 决定,它直接决定成本倍率:
fanout: user_turn(默认)—— 顾问在每轮用户消息的第一条上跑一次,之后聚合模型自己走完整个工具循环。这是最便宜的档位:顾问成本不会随工具调用次数翻倍。fanout: per_iteration—— 每个工具迭代都重跑顾问,意见永远最新,代价是顾问的延迟和花费乘以本轮工具调用数。fanout: every_n:3—— 折中:每轮用户消息的第一个迭代跑一次,之后每 3 个工具迭代刷新一次(任意 N 大于等于 2 都行)。中间迭代复用上一次的顾问意见,所以每一步都有意见可用,只是每 N 步才刷新一次。计数器在新用户消息时重置。
写错的值会回落到 user_turn。顺带一提:2026 年 7 月之前默认是 per_iteration,现在是 user_turn——想恢复逐步咨询,显式写上 fanout: per_iteration。
四、最新变化:没写过预设?模型列表里不会有 MoA
这里说的是一处容易引起困惑的行为修正(PR #126509,修的是 issue #63353)。
问题出在模型选择器构建行的时候:它读取的是合并过默认配置的配置对象,而默认配置里带着一套 MoA 预设骨架。结果就是——哪怕你从来没有写过 moa: 这一段,模型列表里也会出现一个 MoA 提供者行,还带一个合成的 default 预设。你没配过,列表里却有它,很容易让人以为 MoA 默认开着。
现在这一行由 _raw_config_has_enabled_moa_preset() 把关:它直接读原始 config.yaml,不做默认值合并,只有你自己配置文件里真的启用了某个预设(或者是旧的扁平 MoA 配置)时,这一行才会出现。CLI 的模型清单和网关的交互式选择器共用同一个行构造器,所以这次修复在两个界面上同时生效。
对你的实际影响:没配过 MoA 的人,/model 列表变短了、更干净;配过的人完全无感,预设照旧出现。
五、几个值得知道的细节
- 缓存不会被破坏。 选中 MoA 预设只是换了个模型选择,不会改写历史上下文、不会换工具集、也不会中途重建系统提示。参考模型的输出是作为自己的一条尾部消息追加的,而不是塞进你那条消息里——所以已经被缓存的前缀一字未动。遇到强制 user / assistant 严格交替的模板(llama.cpp、vLLM 的 Jinja 模板、部分 OpenRouter 路由)会返回 400,Hermes 会自行把两条相邻 user 消息合并后重试一次,并记住这个目标端点的偏好。
- 输出上限交给 provider。 预设级和槽位级的输出 token 上限已经不再支持,改用各 provider 自己的默认值。
- 隐私过滤:
moa.privacy_filter默认关闭;设成display只对用户可见界面(UI 里的参考块、save_traces写下的记录)做脱敏;设成full则连注入给聚合模型的顾问文本也一起脱敏。凭据形态(API key 前缀、JWT、私钥、数据库连接串)由 Hermes 的中央脱敏器负责。 - 逐槽位推理深度:参考模型和聚合模型都可以单独设
reasoning_effort(none、minimal、low、medium、high、xhigh、max、ultra),所以你可以让同一个模型既当“快速顾问”又当“深思的执行者”。 - 每个预设有自己的开关:
enabled: false表示这个预设的参考分发放关闭,聚合模型单独工作,效果和直接把它当普通模型用一样。 - 几条限制:聚合模型不能再是另一个 MoA 预设(禁止递归);某个参考模型凭据失效不会中断整轮,Hermes 会把失败写进参考上下文继续;MoA 不再列在
hermes tools下,没有moa工具集需要启用。 - 能当兜底:预设可以写进
fallback_providers(例如{provider: moa, model: 预设名})。主模型失败时,Hermes 会以虚拟端点moa://local激活这个预设,和手动选它一样。
六、官方基准:比最强组件高约 6 个点
HermesBench 上,一个两模型预设(gpt-5.5 当参考、claude-opus-4.8 当聚合)的成绩:
| 配置 | HermesBench 得分 |
|---|---|
| Opus 聚合(opus-4.8 + gpt-5.5 参考)—— MoA | 0.8202 |
anthropic/claude-opus-4.8 单跑 |
0.7607 |
openai/gpt-5.5 单跑 |
0.7412 |
也就是说它不只是取平均,而是比它最强的那个组件还高了约 6 个点——多一个视角确实能抬高质量。
七、什么时候不该用
MoA 的代价是模型调用次数变多(一次迭代可能是“若干参考调用 + 一次聚合调用”)。所以:日常小任务、格式转换、简单查询,单模型更快也更便宜。它真正值钱的地方是那些“想错一步要重做半天”的活——架构设计、故障复盘、迁移方案、复杂重构的评审。
如果你在调模型路由,可以配合看我们的辅助模型通道指南(哪类调用会走辅助模型)和模型覆盖配置指南;需要主模型失败时自动接管,三层 fallback 指南讲了兜底链的写法。MoA 如何做到不打断 prompt 缓存,我们在缓存共享那篇里从另一个角度讲了一遍。命令细节见 hermes moa 命令参考。