Mixture of Agents, erklärt: zweimal zahlen, bessere Antwort bekommen
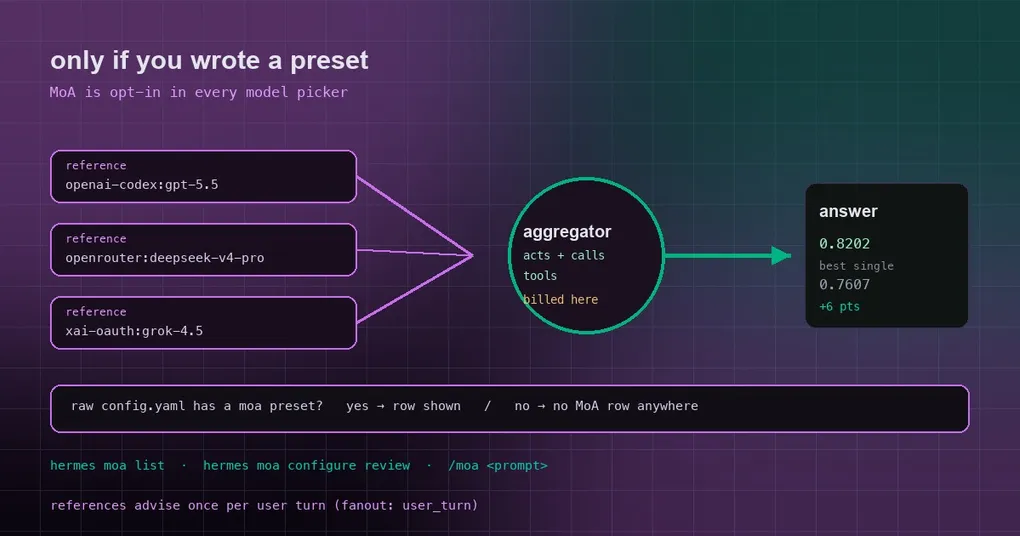
Manche Aufgaben sind nicht deshalb lästig, weil sie schwer zu programmieren wären, sondern weil sie schwer zu durchdenken sind. Die Architektur eines Schedulers neu schreiben, der seit drei Jahren läuft und den niemand anzufassen wagt. Eine Incident-Timeline aus einem 45 MB großen Log rekonstruieren. Du stellst dieselbe Frage dreimal und bekommst drei Antworten, die jede auf eine andere Weise leicht falsch ist — zusammen wären sie richtig.
Mixture of Agents (MoA) macht aus „frag drei Modelle“ eine Pipeline: Mehrere Reference Models analysieren zuerst das Problem, und ein Aggregator liest ihren Rat und erledigt die eigentliche Arbeit. Dieser Beitrag geht davon aus, wie es läuft, bis dahin, wer es bezahlt, und endet mit einer aktuellen Änderung, die leicht falsch zu lesen ist.
1. MoA in einem Satz
MoA ist kein Tool und kein Schalter — es ist ein virtueller Model-Provider. Jedes benannte Preset, das du konfigurierst, erscheint als wählbares Modell unter dem Provider moa, du kannst es also überall auswählen, wo du ein Modell auswählst: CLI, TUI, Gateway, Dashboard, Desktop-App. Strukturell sitzt es auf derselben Ebene wie anthropic oder openrouter.
Sobald ein Preset ausgewählt ist:
- Die Reference Models laufen zuerst. Sie bekommen nur den User- und Assistant-Text der Konversation — nicht den Hermes-System-Prompt und nicht das Tool-Call-Transkript —, was diese Calls günstig hält und Ablehnungen durch strikte Provider vermeidet.
- Der Aggregator ist das handelnde Modell. Er wird mit dem normalen Hermes-Tool-Schema aufgerufen, schreibt die Antwort, die du siehst, und gibt Tool-Calls aus, die Hermes wie üblich ausführt.
- Bei der nächsten Modell-Iteration läuft der ganze MoA-Prozess erneut über die aktualisierte Konversation, Tool-Ergebnisse inklusive.
Das ist das mentale Modell: der Aggregator ist der Protagonist, die References sind Berater, die pro Turn einmal konsultiert werden.
2. Konfiguration
Drei Wege, nimm den, der passt:
- Dashboard → Models → Model Settings → Mixture of Agents
- Desktop-App → Settings → Model → Mixture of Agents
- Kommandozeile:
hermes moa configure [preset-name]
Oder schreibe config.yaml direkt. Dies ist das dokumentierte Default-Preset:
moa:
  default_preset: default
  presets:
    default:
      reference_models:
        - provider: openai-codex
          model: gpt-5.5
        - provider: openrouter
          model: deepseek/deepseek-v4-pro
      aggregator:
        provider: openrouter
        model: anthropic/claude-opus-4.8
      enabled: true
Die Konfiguration speichert explizite Provider/Model-Paare, du kannst also Anbieter mischen und zwei Modelle desselben Anbieters verwenden. Zwei optionale Temperatur-Felder (reference_temperature, aggregator_temperature) werden bei Auslassung einfach nicht gesendet, sodass jedes Modell den Provider-Default verwendet — dasselbe Verhalten wie bei einem Single-Model-Agent.
Presets aus dem Terminal verwalten:
hermes moa list                 # zeigt die aktuellen Slots
hermes moa configure review     # erstellt oder aktualisiert ein Preset namens review
hermes moa delete review        # löscht ein Preset
Drei Wege, eines tatsächlich zu verwenden:
/model review --provider moa        # schaltet diese Session auf das Preset review um
/moa design a migration plan for this flaky test cluster    # one shot, dann zurück zu deinem vorherigen Modell
/moa ist bewusst One-Shot-Bequemlichkeit: Es wechselt vorübergehend auf das Default-Preset, sendet deinen Prompt und stellt das Modell wieder her, auf dem du warst. Es ändert nie deine Modellauswahl, ein normaler Prompt kann dich also nicht versehentlich auf MoA schieben. Ein blankes /moa ohne Prompt gibt nur die Usage aus.
3. Wer abgerechnet wird
Das ist der Teil, den Leute übersehen: der Aggregator bezahlt den ganzen Lauf. Er durchläuft jeden Schritt der Tool-Schleife, also landet fast der gesamte Kostenanteil eines Presets beim Provider des Aggregators; die References beraten bei der Default-Kadenz einmal pro User-Turn.
Die klassische Falle: Dein Hauptmodell läuft auf einem Subscription-Provider, und der Aggregator des Presets sitzt auf einem anderen. Dieser Turn wird beim Provider des Aggregators abgerechnet, nicht bei deinem Abo. Um die Überraschung zu verhindern, geben hermes moa list und hermes moa configure eine zusätzliche Zeile aus, wann immer der Provider des Aggregators von model.provider abweicht, und der Desktop-Editor und /model markieren den Aggregator-Slot als das handelnde, abgerechnete Modell.
Wie oft die Berater laufen, steuert die Einstellung fanout, und sie skaliert die Kosten direkt:
fanout: user_turn(der Default) — die Berater laufen einmal, bei der ersten Nachricht jedes User-Turns, und der handelnde Aggregator arbeitet den Rest der Tool-Schleife allein durch. Konstruktionsbedingt am günstigsten: Die Berater-Kosten multiplizieren sich nicht mit Tool-Calls.fanout: per_iteration— die Berater laufen bei jeder Tool-Iteration erneut, ihr Rat folgt also immer den neuesten Ergebnissen, um den Preis, dass sich Latenz und Ausgaben der Berater mit der Zahl der Tool-Calls in einem Turn multiplizieren.fanout: every_n:3— der Mittelweg: Die Berater laufen bei der ersten Iteration jedes User-Turns und danach bei jeder dritten Tool-Iteration (jedes N ab 2 funktioniert). Dazwischen liegende Iterationen verwenden die letzte Berater-Empfehlung erneut, der Aggregator hat also bei jedem Schritt Rat — er wird nur alle N Schritte aufgefrischt. Der Zähler wird bei jeder neuen User-Nachricht zurückgesetzt.
Fehlerhafte Werte fallen auf user_turn zurück. Beachte, dass sich der Default selbst geändert hat: Vor Juli 2026 war es per_iteration. Presets, die Beratung pro Schritt wollen, setzen es explizit.
4. Die aktuelle Änderung: kein Preset, keine MoA-Zeile
Das ist der aktuelle Verhaltensfix (PR #126509, Issue #63353), der leicht als „MoA wurde abgeschaltet“ missverstanden wird.
Die Model-Picker-Zeile wurde aus der gemergten Konfiguration gebaut, und die Default-Konfiguration trägt ein synthetisiertes MoA-Preset-Skelett. Selbst wenn du nie einen moa:-Block geschrieben hattest, zeigte deine Modellliste also eine MoA-Provider-Zeile mit einem synthetisierten default-Preset — was aussah, als wäre MoA standardmäßig an.
Die Zeile ist jetzt durch _raw_config_has_enabled_moa_preset() gegated, die deine rohe config.yaml ohne Zusammenführen von Defaults liest: Die Zeile erscheint nur, wenn du selbst ein Preset aktiviert hast (oder eine alte flache MoA-Konfiguration mitbringst). Das CLI-Inventar und der interaktive Picker des Gateways teilen einen Row-Builder, also wurden beide Oberflächen auf einmal gefixt.
Praktisch heißt das: Hast du MoA nie konfiguriert, ist deine /model-Liste kürzer und aufgeräumter. Hast du es, ändert sich nichts — deine Presets tauchen weiterhin genau dort auf, wo sie es taten.
5. Details, die man kennen sollte
- Der Prompt-Cache überlebt. Ein MoA-Preset auszuwählen ist eine normale Modellauswahl: Sie schreibt keinen vergangenen Kontext um, tauscht keine Toolsets aus und baut den System-Prompt nicht mitten im Gespräch neu. Reference-Output wird als eigene nachgestellte Nachricht angehängt statt in deine hineingemergt, sodass das gecachte Prefix unberührt bleibt. Templates, die strikte User/Assistant-Alternation erzwingen (llama.cpp- und vLLM-Jinja-Templates, einige OpenRouter-Routen), lehnen das mit einem 400 ab; Hermes wiederholt diese eine Anfrage mit zusammengeführten zwei benachbarten User-Nachrichten, merkt sich die Präferenz des Ziels für den Rest der Session und lässt jedes andere Ziel auf der cache-stabilen Form.
- Output-Limits gehören dem Provider. Output-Token-Caps auf Preset- und Slot-Ebene werden nicht mehr unterstützt; es gelten die Provider-Defaults.
- Privacy-Filter:
moa.privacy_filterist standardmäßig aus.displayredigiert nur benutzersichtbare Oberflächen (die Reference-Blöcke in der UI und die Records, diesave_tracesschreibt);fullredigiert zusätzlich den in den Aggregator-Prompt injizierten Berater-Text. Credential-Formen — API-Key-Prefixe, JWTs, Private Keys, DB-Connection-Strings — behandelt der zentrale Secret-Redactor von Hermes. - Reasoning-Tiefe pro Slot: Sowohl Reference- als auch Aggregator-Slots können
reasoning_effortsetzen (none,minimal,low,medium,high,xhigh,max,ultra), ein Modell kann also als schneller Berater und ein anderes als tiefer Denker auftreten. - Ein Aus-Schalter pro Preset:
enabled: falsedeaktiviert den Reference-Fanout dieses Presets, sodass der Aggregator allein handelt, genau als hättest du ihn als normales Modell ausgewählt. - Limits: Ein Aggregator kann kein weiteres MoA-Preset sein (rekursive Bäume sind blockiert); ein Credential-Fehler eines einzelnen Reference-Modells bricht den Turn nicht ab — der Fehler wird in den Reference-Kontext aufgenommen und der Lauf geht weiter; MoA wird nicht mehr unter
hermes toolsaufgeführt, und es gibt keinmoa-Toolset zum Aktivieren. - Es kann ein Fallback sein: Ein Preset funktioniert als
fallback_providers-Eintrag (zum Beispiel{provider: moa, model: <preset>}). Scheitert das Primärmodell, aktiviert Hermes das Preset selbst — References und Aggregator, mitmoa://localals virtuellem Endpoint.
6. Der offizielle Bench: rund sechs Punkte über seiner besten Komponente
Auf HermesBench, ein Preset mit zwei Modellen (gpt-5.5 als Reference, claude-opus-4.8 als Aggregator):
| Konfiguration | HermesBench-Score |
|---|---|
| Opus-Aggregator (opus-4.8 + gpt-5.5 als Reference) — MoA | 0,8202 |
anthropic/claude-opus-4.8 allein |
0,7607 |
openai/gpt-5.5 allein |
0,7412 |
Es mittelt also nicht: Es schlägt seine stärkste Komponente um rund sechs Punkte, was das Argument dafür ist, für harte Aufgaben eine zweite Perspektive einzukaufen.
7. Wann du es nicht verwenden solltest
MoA erhöht die Zahl der Modell-Calls — eine Iteration kann mehrere Reference-Calls plus den Aggregator-Call bedeuten. Für Alltagsaufgaben, Formatkonvertierungen und einfache Lookups ist ein einzelnes Modell schneller und günstiger. Seinen Preis verdient es bei den Jobs, bei denen eine falsche Annahme einen halben Arbeitstag Neuarbeit bedeutet: Architektur-Design, Incident-Post-mortems, Migrationspläne, Review eines komplexen Refactorings.
Wenn du am Model-Routing schraubst, kombiniere das mit unserem Guide zur Auxiliary-Model-Lane (welche Calls über die Auxiliary-Lane gehen) und dem Model-Overrides-Guide; für die automatische Übernahme, wenn das Primärmodell scheitert, deckt der Drei-Schichten-Fallback-Guide die Kette ab. Und warum MoA den Prefix-Cache nicht stört, steht im Cache-Sharing-Beitrag. Befehlsdetails: hermes moa Referenz.