Das zweite Modell, das du nie konfiguriert hast: Hermes' Lane für Hilfsaufrufe
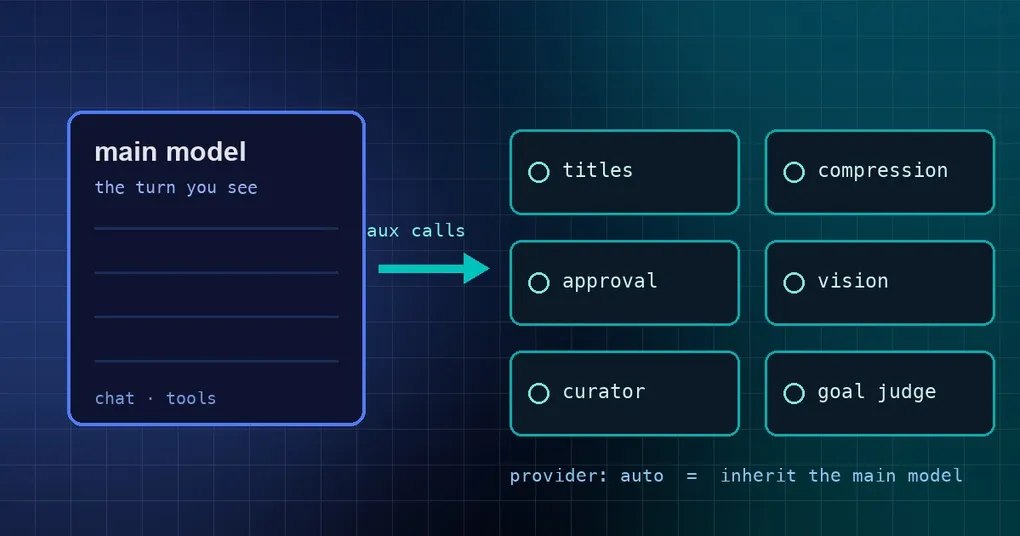
An einem Montagmorgen öffnest du deine Session-Liste, und das wichtige Gespräch von gestern heißt {"title": "Fix the CI... — ein abgeschnittenes JSON-Fragment. Ein andermal stellst du das Hauptmodell auf ein billiges, schnelles um, und die Kommando-Freigabe wird seltsam: harmlose Befehle werden blockiert, offensichtlich gefährliche gehen durch. Jemand anders, der llama.cpp lokal laufen lässt, klagt, dass „eine Kompression mehrere Minuten dauert“. Diese drei Symptome wirken unabhängig, doch ihre Wurzel ist oft dieselbe unsichtbare Lane: Hilfsaufgaben (auxiliary tasks).
Die Aufruf-Lane, die du täglich benutzt und nie konfiguriert hast
Dein Hauptmodell macht nicht alles selbst. Neben dem Gespräch, das du siehst, feuert Hermes einen Strom kleiner Hintergrundanfragen ab:
- Benennen jeder neuen Session;
- Zusammenfassen, wenn das Kontextfenster vollläuft;
- Klassifizieren, ob ein Befehl anhalten und dich fragen soll;
- ein Vision-Modell bitten, ein Bild zu beschreiben, wenn dein Hauptmodell nur Text kann;
- Skills-Suche, Umschreiben von Memory-Queries, Kanban-Aufgabenzerlegung, der
/goal-Zufriedenheits-Judge, Mail-Scoring und der Selbst-Review am Turn-Ende, der Memory speichert oder einen Skill patcht.
Diese Aufgaben haben im Code Namen. Auf main gibt es 13 eingebaute:
| Task key | Anzeigename | Was sie tut |
|---|---|---|
vision |
Vision | Bild-/Screenshot-Analyse (der Beschreiber für reine Text-Hauptmodelle) |
compression |
Compression | Kontext-Zusammenfassung |
approval |
Approval | Klassifizierer für die intelligente Kommando-Freigabe |
mcp |
MCP | Reasoning über MCP-Tools |
title_generation |
Title generation | Session-Titel |
review |
Review | der Reviewer-Subagent von /review |
memory_query_rewrite |
Memory query rewrite | schreibt Memory-Retrieval-Queries um |
tts_audio_tags |
TTS audio tags | Einfügen von Gemini-TTS-Tags |
skills_hub |
Skills hub | Skills-Suche und -Installation |
triage_specifier |
Triage specifier | erweitert eine Kanban-Triage-Notiz zu einer Spec |
kanban_decomposer |
Kanban decomposer | zerlegt eine Aufgabe in einen Graphen von Kindaufgaben |
profile_describer |
Profile describer | automatische Profilbeschreibungen |
curator |
Curator | Review-Durchlauf zur Skill-Nutzung |
Dazu kommen goal_judge (/goal-Zufriedenheit), monitor (Scoring wichtiger Mails), background_review (der Selbstverbesserungs-Fork nach dem Turn) und die beiden MoA-Slots moa_reference / moa_aggregator. Sie erben standardmäßig dein Hauptmodell, weshalb du vielleicht monatelang „ein Modell macht alles“ gefahren hast, ohne zu bemerken, dass diese Lane existiert — bis sie bricht.
Die Konfigurationsform: ein Schlüssel entscheidet, auf welchem Modell eine Aufgabe läuft
Jede Aufgabe hat dieselbe Blockform:
auxiliary:
  # globale Schalter
  transient_retries: 2          # Wiederholungen beim selben Provider bei einem transienten Aussetzer, begrenzt auf 0..6
  free_only: false              # true = Hintergrundverkehr nutzt nie eine BEZAHLTE OpenRouter-Lane
  openrouter_model: ""          # überschreibt das OpenRouter-Modell der Auto-Kette
  stream_only_base_urls: []     # Endpunkte, die nicht-streamenden Chat ablehnen (HTTP 400)

  # ein Block pro Aufgabe, gleiche Form
  title_generation:
    enabled: true               # false = überhaupt keine Titel
    model_upgrade_enabled: true # false = den sofort abgeleiteten Titel behalten, nie ein Modell aufrufen
    provider: auto              # auto = das Hauptmodell erben
    model: ""                   # leer = dem Provider folgen
    prefer_fast_model: false    # true = die schnelle Stufe des Providers nutzen
    language: ""                # Sprache für die Titel
    timeout: 30
  approval:
    provider: auto
    model: ""                   # hier empfiehlt sich ein schnelles, günstiges Modell
    timeout: 30
  curator:
    timeout: 600                # der Skill-Review kann auf einem Reasoning-Modell Minuten dauern
Drei leicht zu machende Fehler:
provider: autobedeutet „das Hauptmodell erben“ — es ist kein echter Provider-Name. Um ein bestimmtes günstiges Modell festzulegen, setzeproviderundmodelbeide.- Die Timeouts sind nicht willkürlich gewählt: die Freigabe-Klassifizierung liegt standardmäßig bei 30 s (sie muss schnell sein),
kanban_decomposerbekommt 180 s,curator600 s. Kompression mit einem lokalen Modell ist der klassische Fall, in dem 120 s nicht reichen — die übliche Quelle für „die Kompression ist lokal so langsam“. background_reviewhat ein zusätzlichesmax_input_tokens: 600000, das den Gesamtinput begrenzt, den der Selbst-Review erneut abspielt. Leite ihn auf ein anderes Modell um, und er spielt statt des vollständigen Gesprächs einen kompakten Auszug ab — grob 3–5× günstiger.
Der einfachste Ort für solche Änderungen ist der unterste Eintrag im Modell-Menü:
hermes model          # im Menü „Configure auxiliary models...“ wählen
hermes config get auxiliary.title_generation   # die effektiven Werte ansehen
Plugins können ebenfalls eigene Hilfsaufgaben registrieren, und sie erscheinen im selben Menü. Führe hermes config get <key> aus, bevor du irgendetwas konfigurierst — diese Schlüssel sind noch in Bewegung: in der v0.21.0-CLI dieser Maschine hat title_generation kein Feld model_upgrade_enabled, während main es bereits hat.
Die Charge vom 17. September: zehn Gesichter des stillen Fehlers
Am 17. September 2026 ist eine ganze Gruppe von Fixes für diese Lane gemergt worden. Was sie eint: ein Fehler wirft nie einen Fehler, er erzeugt nur ein seltsames Symptom.
| Was du siehst | Die eigentliche Ursache | PR |
|---|---|---|
| Ein Titel, der manchmal ein JSON-Fragment ist | die Titelgenerierung las reasoning_content als Prosa oder speicherte abgeschnittenes JSON |
#113960 |
| Titel werden nie fertig, Wiederholungen stapeln sich | kein Erholungspfad nach gestapelten Parameter-Ablehnungen | #113958 |
| Das Ausschalten des Modell-Upgrades lässt Titel leer | der sofort abgeleitete Titel sollte überleben, aber ein Modellaufruf überschrieb ihn | #113955 |
| Ein toter Endpunkt blockiert den Hintergrundverkehr ewig | Auto-Titel sollten nach einem Timeout-Fenster aufgeben und den Endpunkt nennen, der nicht geantwortet hat | #113968 |
| Nachdem das Hauptmodell sein Kontingent erreicht hat, stockt die ganze Lane | der Durchlauf über fallback_providers übersprang keinen quotenbegrenzten Kandidaten |
#113965 |
| DeepSeek gibt bei strukturierter Ausgabe 400 zurück und der Fallback stirbt mit | ein 400 darf keine Fallback-Kandidaten töten und keinen aussichtslosen ersten Request kosten | #113966 |
| Alles im Hintergrund scheitert, sobald xAIs OAuth-Token abläuft | Hilfsaufrufe sollten sich erholen, nicht scheitern | #113964 |
| Ein Custom-Provider gibt still ein 401 zurück | key_cmd ist ein Callable, und fünf Auflösungszweige riefen entweder .strip() darauf auf oder schickten sein repr als Bearer-Token |
#114333 |
Eine lokale ollama-base_url wirkt nie |
diese Lane löste die lokale Adresse nie auf und rief den Server nie wirklich auf | #113961 |
Das /goal-Judging scheitert mit einem undurchsichtigen Judge-Fehler |
es sollte sagen, dass die Nous-Authentifizierung fehlgeschlagen ist | #113963 |
Die lehrreichste davon: ein Custom-Provider, der key_cmd nutzt, um bei Bedarf ein Token zu prägen (der einzig richtige Ansatz, wenn Credentials ablaufen). Die Haupt-Runtime reichte das zurückgegebene Callable immer unangetastet durch, während fünf Zweige des Hilfs-Clients einen String erwarteten — also stürzten sie entweder ab oder schickten <CommandTokenSource object at 0x…> als Bearer-Token an den Server. Das zweite Ergebnis ist schlimmer: es gibt keinen Fehler, es gibt nur still ein 401.
Warum solche Bugs so schwer aufzuspüren sind
Weil sie auf einem „auxiliary“-Pfad leben, der bewusst degradieren soll: ein fehlgeschlagener Titel darf deinen Chat nicht kaputtmachen, ein langsamer Freigabe-Klassifizierer soll auf eine Rückfrage zurückfallen, eine fehlgeschlagene Kompression braucht ein Sicherheitsnetz. Sauber zu degradieren ist richtiges Design, und der Preis dafür ist, dass Fehler verschluckt werden. Du siehst Symptome — seltsame Titel, nutzlose Freigaben, langsame Kompression — statt einer Fehlermeldung.
Daraus folgt eine sehr praktische Empfehlung: lege für jede Hilfsaufgabe ein schnelles, günstiges Modell fest (besonders für approval und title_generation). Wenn du dann das Hauptmodell wechselst, eines herabstufst oder vorübergehend keinen Zugriff darauf hast, bleibt das Hintergrundverhalten stabil — und beim Debuggen erkennst du sofort, ob „mein Hauptmodell hat sich geändert“ oder „die Hintergrund-Lane hat sich unter mir geändert“ gilt.
Release-Status
Jeder Fix oben ist am 17. September 2026 in main gemergt worden. Das neueste getaggte Release, v0.21.3 (Tag v2026.9.14, 14. September), enthält sie nicht. Prüfe, was du hast:
hermes --version
hermes config get auxiliary.title_generation
Wenn dich einer dieser Punkte gerade aktiv ärgert — JSON-Fragment-Titel und das stille 401 bei Custom-Providern sind die beiden schlimmsten —, führe hermes update aus und warte auf das nächste Tag, oder tracke in der Zwischenzeit main lokal.
Weiterlesen: um zu verhindern, dass Hilfsaufrufe Geld verbrennen, fang mit der Konfiguration des Reasoning-Aufwands an; häufige Kompression gehört zur selben Problemfamilie und wird in Kompression und der schlanke Schwanz behandelt; Timeouts und Port-Details, wenn ein lokales Modell deine Hilfsaufgaben fährt, stehen im lokalen llama.cpp-Leitfaden; und das Onboarding neuer Provider behandelt, worauf du achten musst, wenn du Hilfsaufgaben an einen neuen Anbieter hängst.
Zusammenfassung
- Hermes hat eine Hintergrund-Aufruf-Lane (auxiliary) mit 13 eingebauten Aufgaben plus MoA- und Selbst-Review-Slots, die standardmäßig alle das Hauptmodell erben.
- Jede Aufgabe hat denselben Konfigurationsblock:
provider/model/base_url/api_key/timeout/extra_body/reasoning_effort;provider: autobedeutet „dem Hauptmodell folgen“. - Um Geld zu sparen und berechenbar zu bleiben: lege günstige Modelle auf häufige kleine Aufgaben (
approval,title_generation) und erhöhe den Timeout fürcompression, wenn ein lokales Modell sie übernimmt. - Die Charge vom 17. September behebt zehn stille Fehler (JSON-Fragment-Titel, ein hängender Quota-Fallback, das stille 401 bei Custom-Providern und mehr) und ist noch in keinem getaggten Release.