El segundo modelo que nunca configuraste: el carril de llamadas auxiliares de Hermes
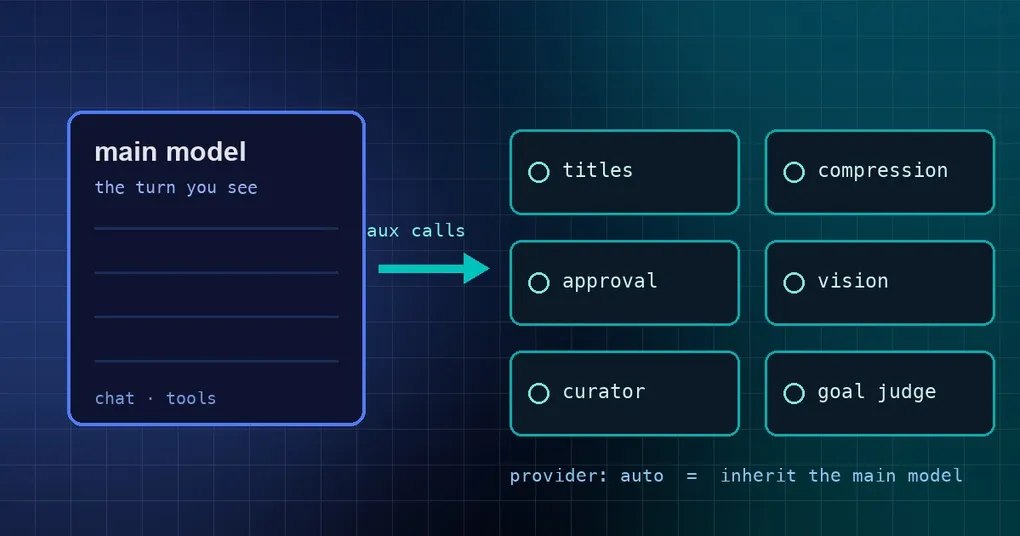
Un lunes por la mañana abres tu lista de sesiones y la conversación importante de ayer se titula {"title": "Fix the CI... — un fragmento de JSON truncado. Otra vez cambias el modelo principal a uno barato y rápido y la aprobación de comandos se vuelve rara: comandos inofensivos quedan bloqueados y otros obviamente peligrosos pasan sin problema. Alguien que ejecuta llama.cpp en local se queja de que «una compresión tarda varios minutos». Estos tres síntomas parecen no tener relación, pero su raíz suele ser el mismo carril invisible: las tareas auxiliares.
El carril de llamadas que usas cada día y nunca has configurado
Tu modelo principal no lo hace todo por sí solo. Además de la conversación que ves, Hermes dispara un chorro de pequeñas peticiones en segundo plano:
- poner nombre a cada sesión nueva;
- resumir cuando la ventana de contexto se llena;
- clasificar si un comando debe detenerse y preguntarte;
- pedir a un modelo de visión que describa una imagen cuando tu modelo principal es solo de texto;
- búsqueda de skills, reescritura de consultas de memoria, descomposición de tareas de kanban, el juez de satisfacción de
/goal, la puntuación de correo y la autorrevisión al final del turno que guarda memoria o parchea una skill.
Estas tareas tienen nombre en el código. A fecha de main hay 13 integradas:
| Clave de tarea | Nombre visible | Qué hace |
|---|---|---|
vision |
Vision | análisis de imágenes y capturas (el descriptor cuando el modelo principal es solo de texto) |
compression |
Compression | resumen del contexto |
approval |
Approval | clasificador inteligente de aprobación de comandos |
mcp |
MCP | razonamiento sobre herramientas MCP |
title_generation |
Title generation | títulos de sesión |
review |
Review | el subagente revisor de /review |
memory_query_rewrite |
Memory query rewrite | reescribe las consultas de recuperación de memoria |
tts_audio_tags |
TTS audio tags | inserción de etiquetas de Gemini TTS |
skills_hub |
Skills hub | búsqueda e instalación de skills |
triage_specifier |
Triage specifier | expande una nota de Triage de kanban a una especificación |
kanban_decomposer |
Kanban decomposer | descompone una tarea en un grafo de subtareas |
profile_describer |
Profile describer | descripciones automáticas de profile |
curator |
Curator | pasada de revisión del uso de skills |
También existen goal_judge (satisfacción de /goal), monitor (puntuación de correo importante), background_review (el fork de automejora posterior al turno) y las dos ranuras de MoA moa_reference / moa_aggregator. Por defecto heredan tu modelo principal, que es la razón por la que puedes haber estado ejecutando «un solo modelo haciendo todo» durante meses sin darte cuenta de que este carril existe, hasta que se rompe.
La forma de la configuración: una clave decide en qué modelo se ejecuta cada tarea
Todas las tareas usan el mismo bloque:
auxiliary:
  # ajustes globales
  transient_retries: 2          # reintentos con el mismo provider ante un fallo transitorio, acotado 0..6
  free_only: false              # true = el tráfico de fondo nunca usa un carril OpenRouter DE PAGO
  openrouter_model: ""          # sobrescribe el modelo OpenRouter de la cadena automática
  stream_only_base_urls: []     # endpoints que rechazan chat sin streaming (HTTP 400)

  # un bloque por tarea, con la misma forma
  title_generation:
    enabled: true               # false = ningún título en absoluto
    model_upgrade_enabled: true # false = conservar el título derivado instantáneo, nunca llamar a un modelo
    provider: auto              # auto = heredar el modelo principal
    model: ""                   # vacío = seguir al provider
    prefer_fast_model: false    # true = usar el nivel rápido del provider
    language: ""                # idioma de los títulos
    timeout: 30
  approval:
    provider: auto
    model: ""                   # aquí se recomienda un modelo rápido y barato
    timeout: 30
  curator:
    timeout: 600                # la revisión de skills puede tardar minutos con un modelo de razonamiento
Tres errores fáciles:
provider: autosignifica «heredar el modelo principal»: no es el nombre de un provider real. Para fijar un modelo barato concreto, define a la vezproviderymodel.- Los timeouts no son arbitrarios: la clasificación de aprobaciones usa 30 s por defecto (tiene que ser rápida),
kanban_decomposertiene 180 s ycurator600 s. Comprimir con un modelo local es el caso clásico en el que 120 s no bastan: el origen habitual de «la compresión es lentísima en local». background_reviewtiene unmax_input_tokens: 600000extra que limita la entrada total que reproduce la autorrevisión. Enrútalo a otro modelo y reproducirá un resumen compacto en lugar de la conversación completa, unas 3–5 veces más barato.
El sitio más fácil para cambiar esto es la última entrada del menú de modelos:
hermes model          # elige "Configure auxiliary models..." en el menú
hermes config get auxiliary.title_generation   # consulta los valores efectivos
Los plugins también pueden registrar sus propias tareas auxiliares, y aparecen en el mismo menú. Ejecuta hermes config get <key> antes de configurar nada: estas claves todavía se mueven. En la CLI v0.21.0 de esta máquina, title_generation no tiene campo model_upgrade_enabled, mientras que main ya lo tiene.
El lote del 17 de septiembre: diez caras del fallo silencioso
El 17 de septiembre de 2026 se fusionó todo un grupo de arreglos para este carril. Lo que comparten: el fallo nunca lanza un error, solo produce un síntoma extraño.
| Qué ves | La causa real | PR |
|---|---|---|
| Un título que a veces es un fragmento de JSON | la generación de títulos leía reasoning_content como prosa, o guardaba JSON truncado |
#113960 |
| Los títulos nunca se completan y los reintentos se acumulan | no hay ruta de recuperación tras rechazos de parámetros apilados | #113958 |
| Desactivar la mejora de modelo deja los títulos vacíos | el título derivado instantáneo debería sobrevivir, pero una llamada al modelo lo sobrescribía | #113955 |
| Un endpoint muerto bloquea el tráfico de fondo durante una eternidad | los títulos automáticos deberían rendirse tras una ventana de timeout y nombrar el endpoint que expiró | #113968 |
| Después de que el modelo principal agote su cuota, todo el carril se atasca | el recorrido de fallback_providers no se saltaba un candidato limitado por cuota |
#113965 |
| DeepSeek devuelve 400 en salida estructurada y el fallback muere con él | un 400 no debe matar a los candidatos de fallback ni costar una primera petición condenada | #113966 |
| Todo lo de fondo falla en cuanto expira el token OAuth de xAI | las llamadas auxiliares deberían recuperarse, no fallar | #113964 |
| Un provider personalizado devuelve un 401 silencioso | key_cmd es un callable, y cinco ramas de resolución le aplicaban .strip() o enviaban su repr como token bearer |
#114333 |
Un base_url de ollama local nunca surte efecto |
ese carril nunca resolvía la dirección local ni llamaba de verdad al servidor | #113961 |
El juicio de /goal falla con un error de juez opaco |
debería decir que falló la autenticación de Nous | #113963 |
La más instructiva: un provider personalizado que usa key_cmd para acuñar un token bajo demanda (el único enfoque correcto cuando las credenciales expiran). El runtime principal siempre pasaba el callable devuelto sin tocarlo, mientras que cinco ramas del cliente auxiliar asumían una cadena; así que o reventaban, o enviaban <CommandTokenSource object at 0x…> al servidor como token bearer. El segundo desenlace es peor: no da error, simplemente devuelve un 401 en silencio.
Por qué los bugs como estos son tan difíciles de localizar
Porque viven en una ruta «auxiliar» que está diseñada para degradarse: un título fallido no debe romper tu chat, un clasificador de aprobaciones lento debería caer a un prompt y una compresión fallida necesita una red de seguridad. Degradarse con elegancia es un diseño correcto, y el precio es que los fallos se tragan. Ves síntomas —títulos raros, aprobaciones poco útiles, compresiones lentas— en lugar de un mensaje de error.
Lo que lleva a una recomendación muy práctica: fija un modelo rápido y barato para cada tarea auxiliar (sobre todo approval y title_generation). Así, cuando cambies de modelo principal, degradas uno o pierdes el acceso a otro durante un tiempo, el comportamiento de fondo se mantiene estable; y mientras depuras sabrás al instante si lo que cambió fue «mi modelo principal» o «el carril de fondo cambió bajo mis pies».
Estado de la release
Todos los arreglos de arriba se fusionaron en main el 17 de septiembre de 2026. La última release etiquetada, la v0.21.3 (tag v2026.9.14, 14 de septiembre), no los incluye. Comprueba qué tienes:
hermes --version
hermes config get auxiliary.title_generation
Si alguno de estos te está mordiendo ahora mismo —los títulos con fragmentos de JSON y el 401 silencioso en providers personalizados son los dos peores—, ejecuta hermes update y espera a la próxima etiqueta, o sigue main en local mientras tanto.
Para seguir leyendo: si quieres que las llamadas auxiliares dejen de quemar dinero, empieza por cómo configurar el esfuerzo de razonamiento; la compresión frecuente es la misma familia de problemas y está tratada en la compresión y la cola ajustada; los timeouts y los detalles de puertos cuando un modelo local ejecuta tus tareas auxiliares están en la guía de modelos locales con llama.cpp; y la incorporación de nuevos providers cubre qué vigilar cuando cuelgas tareas auxiliares de un proveedor nuevo.
Resumen
- Hermes tiene un carril de llamadas en segundo plano (auxiliary) con 13 tareas integradas más las ranuras de MoA y autorrevisión, todas heredando el modelo principal por defecto.
- Cada tarea usa el mismo bloque de configuración:
provider/model/base_url/api_key/timeout/extra_body/reasoning_effort;provider: autosignifica «seguir al modelo principal». - Para ahorrar dinero y mantener la previsibilidad: fija modelos baratos en las tareas pequeñas de alta frecuencia (
approval,title_generation), y sube el timeout decompressioncuando la lleve un modelo local. - El lote del 17 de septiembre arregla diez fallos silenciosos (títulos con fragmentos de JSON, un fallback de cuota atascado, el 401 silencioso en providers personalizados y más) y todavía no está en ninguna release etiquetada.