Ya estás pagando por un razonamiento que no necesitas: el esfuerzo de razonamiento en cada selector de modelo de Hermes
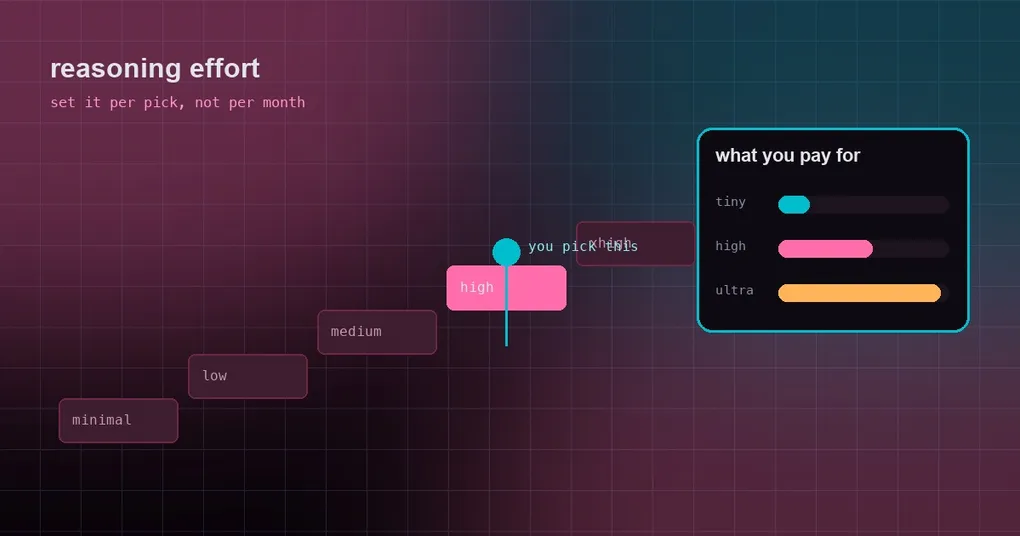
Son las 23:30 y le pides a Hermes que renombre formatTs a formatTimestamp en utils/date.ts. Termina en siete segundos — y la traza factura unos miles de thinking tokens a esfuerzo de razonamiento ultra. El modelo no es el problema. “Ultra” es un default global que pusiste la semana pasada para una revisión de arquitectura, y nadie lo ha tocado desde entonces. Hermes siempre te ha dejado ajustar el esfuerzo de razonamiento; lo que pasaba es que los controles estaban repartidos entre /reasoning, config.yaml y un submenú de Desktop que solo aparecía al pasar el ratón. Saber que la función existe y usarla de verdad eran dos grupos de personas distintos.
Eso cambió con el PR #110346: todos los selectores de modelo preguntan ahora por el nivel de esfuerzo justo después de elegir el modelo. Esta guía recorre los seis sitios donde puedes fijar el esfuerzo (una ejecución puntual, la sesión, el flag de /model, los selectores interactivos, hermes model y Desktop), además de la precedencia entre ellos — para que pagues por el razonamiento que una tarea necesita y no por el que configuraste la semana pasada.
Qué controla realmente el esfuerzo de razonamiento
El esfuerzo de razonamiento es el presupuesto de pensamiento que un modelo puede gastar antes de responder. En los modelos que exponen este control, el nivel se traduce a los parámetros thinking/reasoning de la petición; en los que no, el ajuste es simplemente inerte.
Hay exactamente una fuente de verdad para la escala, en hermes_constants.py:
VALID_REASONING_EFFORTS = ("minimal", "low", "medium", "high", "xhigh", "max", "ultra")Siete niveles, de menos a más. parse_reasoning_effort() convierte una palabra escrita en un dict de config: un nivel reconocido se vuelve {"enabled": True, "effort": "<level>"}, una cadena vacía o una palabra no reconocida devuelve None (es decir, “usa el default del provider”), y none es un interruptor de apagado explícito — reasoning_effort: false y none significan ambos “no pienses”.
Lo importante: esto se aplica por petición. En el mismo modelo, la diferencia de calidad entre low y ultra suele ser mucho menor que la diferencia de latencia y coste. Así que la pregunta real nunca es “qué nivel es el mejor”, sino “cuántos niveles merece esta tarea”.
| Ámbito | Cómo lo fijas | Dónde aterriza |
|---|---|---|
| Solo una ejecución | hermes --reasoning low -z "..." |
ese proceso, no se escribe nada |
| Sesión actual (CLI clásica) | /reasoning high |
override de sesión |
| Sesión actual, con cambio de modelo | /model X --reasoning high |
pin de sesión |
| Tu default global | /reasoning high --global |
agent.reasoning_effort |
| Cada modelo que nombres | agent.reasoning_overrides |
por modelo, gana al default global |
| Una tarea auxiliar | hermes model → Configure auxiliary models… |
auxiliary.vision.reasoning_effort |
| Cada subagente | delegation.reasoning_effort |
el bloque de delegation |
| Un chat de Desktop | la píldora de razonamiento del composer | esa sesión |
La palanca más pequeña: ejecuciones puntuales
Si vas a ejecutar un solo comando para un trabajo bien entendido, no necesitas tocar la config en absoluto. El flag --reasoning de nivel superior existe exactamente para esto:
# Una sola vez: un renombrado. Con low sobra.
hermes --reasoning low -z "rename formatTs to formatTimestamp in utils/date.ts"

# Interactivo, pero esta sesión va a ordenar actas de reunión desordenadas
hermes chat --reasoning high
El texto de ayuda es explícito en que esto sobrescribe el esfuerzo efectivo solo para esa ejecución; el nivel persistente sigue viviendo en config.yaml (o por modelo, en agent.reasoning_overrides). Para scripts de shell, jobs de CI y trabajo por lotes de archivos, esta es la opción más limpia: el esfuerzo viaja con el comando en lugar de convertirse sin ruido en el default de mañana.
Sesiones: /reasoning y /model --reasoning
En la CLI clásica, /reasoning es el comando dedicado — se encarga tanto del nivel de esfuerzo como de cómo se muestra el razonamiento:
/reasoning high           # solo esta sesión
/reasoning high --global  # escribe agent.reasoning_effort para ejecuciones futuras
/reasoning                # sin argumento: elegir de forma interactiva
/reasoning show           # mostrar/ocultar el flujo de razonamiento (full lo imprime todo)
/reasoning none           # apagar el razonamiento
El PR #110346 convirtió cambiar de modelo y fijar el esfuerzo en el mismo gesto. El parser de /model acepta ahora --reasoning <level>, así que una sola petición lleva la elección y su esfuerzo:
/model openrouter/anthropic/claude-opus-4.8 --reasoning highTres detalles que salen constantemente:
- El ámbito sigue al cambio de modelo. Sesión por defecto;
--globalescribeagent.reasoning_effort;--onceguarda una instantánea del valor actual, aplica el esfuerzo durante un solo turno y lo restaura después. - El esfuerzo se aplica después del cambio de agente. No es una sutileza: la ruta del cambio vuelve a resolver
reasoning_configdesdeconfig.yaml, así que escribir el esfuerzo primero quedaría pisado. El orden es deliberado. - Un nivel inválido da error en vez de no hacer nada en silencio.
/model --reasoning turbodevuelve/model --reasoning takes none, minimal, low, medium, high, xhigh, max or ultra.
También puedes saltarte los flags por completo. El selector interactivo de /model tiene ahora tres etapas — provider, modelo y una tercera etapa titulada Reasoning effort for <model> que lista la escala completa más una fila none (desactivar el razonamiento) y una fila de “mantener el actual”. Cuando el mapa de capacidades de la ruta dice que no hay control de razonamiento, esa tercera etapa se oculta en lugar de ofrecer un dial que no hace nada.
La TUI de Ink (hermes --tui) ejecuta el mismo flujo de tres etapas; el paso 3 se etiqueta Reasoning effort (step 3/3) y emite modelo, provider, esfuerzo y ámbito como un único comando de gateway. En las plataformas de mensajería (Telegram, Slack y compañía), /model --reasoning pasa por el mismo aplicador que usa /reasoning, así que los dos no pueden divergir.
hermes model: el paso de esfuerzo para el modelo principal y cada tarea auxiliar
hermes model es el punto de entrada que la mayoría usa primero (ver la referencia de hermes model). Antes del PR #110346 solo preguntaba por el esfuerzo en las rutas de Copilot, y el flujo de auxiliares no preguntaba nunca.
Ahora:
- Después de guardar el modelo principal viene un paso compartido: los siete niveles, Disable reasoning y Skip para mantener el valor actual. Los modelos que el catálogo marca como sin control de razonamiento se saltan el paso.
- La lista de providers ha ganado una fila Reasoning effort for the current model… para cuando solo quieres cambiar el esfuerzo.
- Configure auxiliary models… (provider → modelo) termina con el mismo paso de esfuerzo más una fila Provider default que deja el nivel en manos del provider. Esos valores se guardan como
auxiliary.<task>.reasoning_effort, o comodelegation.reasoning_effortpara delegation. - La lista de tareas muestra el nivel en la misma línea, p. ej.
openrouter · model · high, y Reset all to auto limpia todos los overrides de una vez. - Los bloques que deliberadamente no tienen esa clave — los slots de MoA y
memory_query_rewrite— se saltan el paso. No se echan en falta; simplemente configuran su profundidad en otro sitio.
Por qué esto importa más de lo que parece: la compresión, la generación de títulos y las comprobaciones de aprobación corren en cada turno. Bajarlos de high a minimal (o apagarlos) ahorra más dinero que afinar el nivel del modelo principal lo hará jamás.
Desktop: la píldora del composer y el esfuerzo por tarea en Settings
El selector de modelo de Desktop vive en el composer, justo a la izquierda del micrófono. Antes del PR #109907 el único control de esfuerzo era un submenú al pasar el ratón dentro de una fila de modelo; la píldora combinada decía Deepseek V4 Flash · Med, los usuarios lo leían como “este modelo solo va en medium”, y el submenú quedaba sin descubrir.
Ahora el esfuerzo tiene su propio elemento visible:
- Una píldora de razonamiento junto a la píldora del modelo muestra el nivel realmente en efecto para esta superficie (primero el valor de la sesión, si no el default de la config) y abre directamente las filas Thinking / Fast / Effort. Se oculta cuando el catálogo reporta
reasoning: falsepara el modelo activo, y se mantiene visible mientras las capacidades aún no se conocen, así que nunca parpadea durante la consulta al catálogo. - La píldora del modelo ya no pliega el esfuerzo dentro de su propia etiqueta; cada control dice una sola cosa.
El esfuerzo por tarea en Desktop necesitó dos PRs más. El #110435 añadió un select Reasoning en cada fila bajo Settings → Model → Auxiliary models: inherit · main model effort (el default, que elimina el override de esa tarea), Off, o un nivel — escribiendo la misma clave auxiliary.<task>.reasoning_effort que escribe hermes model. El contrato de la API que hay detrás merece conocerse: omitir el campo deja el override intacto, pasar un null explícito lo limpia (vuelta a inherit), pasar un nivel lo fija. Un valor desconocido como turbo devuelve un 400 con la lista de todos los niveles aceptados en lugar de caer en saco roto.
El PR #110535 cerró el círculo con los pins de auxiliares de Desktop: los 11 slots pueden fijarse, guardar ajustes no relacionados ya no reescribe ni descarta esos pins (las escrituras de config pasaron a ser por sección en lugar de volcar a disco una instantánea totalmente expandida), y cuando una tarea de revisión se enruta a otro modelo, su esfuerzo de razonamiento se respeta en vez de quedar tragado por el ajuste de la sesión padre.
Un detalle con trampa: la app de Desktop recuerda localmente un preset de esfuerzo/fast por modelo. Es una comodidad para la app y no cambia los crons ni los subagentes — para eso, usa hermes model o el archivo de config.
Cómo se apilan las capas y dónde encaja model_overrides
Precedencia, de mayor a menor (es también el orden de resolución en tiempo de ejecución): override de sesión (/reasoning --session, /model --reasoning) → override por modelo agent.reasoning_overrides → default global agent.reasoning_effort. Un config.yaml listo para copiar:
agent:
  # El default global; esta es la línea que escribe `/reasoning high --global`
  reasoning_effort: medium
  # Por modelo: las claves toleran variantes ortográficas (exactas, puntos/guiones
  # intercambiables, prefijo de provider opcional), gana la primera coincidencia,
  # y vence al default de arriba.
  # No hay soporte de `hermes config set` para esta clave — edita el YAML directamente.
  reasoning_overrides:
    "openrouter/anthropic/claude-opus-4.8": high
    "deepseek/deepseek-v4-flash": low

auxiliary:
  compression:
    reasoning_effort: minimal   # resumir el historial no necesita pensar mucho
  title_generation:
    reasoning_effort: none      # títulos: simplemente apágalo
  vision:
    reasoning_effort: ""        # vacío = default del provider

delegation:
  reasoning_effort: low         # subagentes; déjalo vacío para heredar del padre
model_overrides juega aquí un papel distinto (ver la guía de model_overrides): es donde vive la metadata del modelo — context_window, supports_vision, supports_reasoning y compañía. No fija el esfuerzo, pero decide si el control de esfuerzo existe siquiera: cuando el mapa de capacidades dice que una ruta no tiene control de razonamiento, el paso de hermes model, la tercera etapa del selector de /model y la píldora de Desktop se ocultan todos a la vez. Así que si estás con un modelo local o recién salido que el catálogo no conoce, declara primero las capacidades y los controles de esfuerzo aparecerán.
Dos excepciones que conviene interiorizar:
background_review.reasoning_effortse ignora mientras la revisión siga en el modelo principal. En ese caso el fork hereda la config de razonamiento de la conversación tal cual, y eso es lo que mantiene los bytes de su petición en el prefijo de prompt-cache del padre. Para conseguir un modelo distinto y un esfuerzo distinto, fija también el provider/modelo de la revisión — si no, Hermes te avisa una vez, a propósito.- El esfuerzo de MoA se configura por slot dentro del preset, no en el bloque auxiliary:
moa.presets.<name>.reference_models[].reasoning_effortyaggregator.reasoning_effort. Cada referencia puede correr a su propia profundidad y el aggregator puede ir más a fondo — por eso los bloques de MoA no tienen clavereasoning_effortpor diseño.
Una configuración de partida que se paga sola
Si prefieres no llevar toda la cadena de precedencia en la cabeza, haz estas cinco cosas:
- Deja el modelo principal en
medium. Súbelo para una tarea concreta con/model ... --reasoning highen lugar de editar el default global. - Ejecuta
hermes model→ Configure auxiliary models… y pon compression enminimaly title_generation apagado. Corren en cada turno, así que se amortizan de inmediato. - Fija
delegation.reasoning_effort: low. Los subagentes suelen ejecutar una tarea que ya viene descompuesta; no necesitan replanificarla. - Usa
hermes --reasoning low -z "..."para scripts y trabajos puntuales, para que una necesidad temporal nunca se convierta en un default permanente. - Si una ejecución larga se atasca, revisa el presupuesto de turnos antes de tirar de más razonamiento — de eso va la guía de max_turns. Y en rutas de plan gratuito, la configuración sin API key combina bien con
minimal.
La versión corta
El esfuerzo de razonamiento no es un dial de “cuanto más, mejor”; es un problema de alcance. En un mismo config.yaml tienes diales separados para la sesión, por modelo, por tarea auxiliar y por subagente. El PR #110346 llevó esos diales a los selectores que ya usas — lo único que queda es decidir cuántos niveles merece cada trabajo, para que una revisión del mes pasado deje de pagar tarifas ultra por un renombrado de este mes.