O segundo modelo que você nunca configurou: o canal de chamadas auxiliares do Hermes
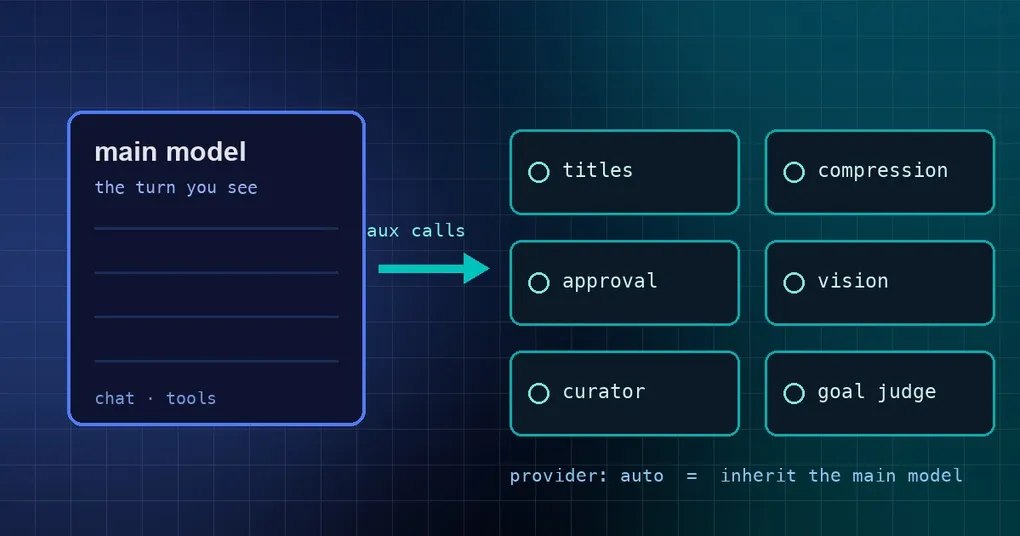
Em uma manhã de segunda-feira você abre a lista de sessões e a conversa importante de ontem tem o título {"title": "Fix the CI... — um fragmento de JSON truncado. Em outra ocasião você troca o modelo principal por um barato e rápido, e a aprovação de comandos fica estranha: comandos inofensivos são bloqueados e outros obviamente perigosos passam batido. Uma outra pessoa, rodando llama.cpp localmente, reclama que “uma compressão leva vários minutos”. Esses três sintomas parecem não ter relação, mas a raiz deles muitas vezes é o mesmo canal invisível: as tarefas auxiliares.
O canal de chamadas que você usa todos os dias e nunca configurou
O seu modelo principal não faz tudo sozinho. Além da conversa que você vê, o Hermes dispara uma série de pequenas requisições em segundo plano:
- nomear cada nova sessão;
- resumir quando a janela de contexto se enche;
- classificar se um comando deve parar e perguntar a você;
- pedir a um modelo de visão que descreva uma imagem quando o seu modelo principal é apenas texto;
- busca de skills, reescrita de consultas de memória, decomposição de tarefas do kanban, o juiz de satisfação do
/goal, pontuação de e-mails e a autoavaliação no fim do turno, que salva memória ou corrige uma skill.
Essas tarefas têm nomes no código. Na main atual existem 13 built-ins:
| Chave da tarefa | Nome exibido | O que faz |
|---|---|---|
vision |
Vision | análise de imagens e screenshots (o descritor para modelos principais só-texto) |
compression |
Compression | sumarização de contexto |
approval |
Approval | classificador inteligente de aprovação de comandos |
mcp |
MCP | raciocínio de ferramentas MCP |
title_generation |
Title generation | títulos de sessão |
review |
Review | o subagente revisor do /review |
memory_query_rewrite |
Memory query rewrite | reescreve consultas de recuperação de memória |
tts_audio_tags |
TTS audio tags | inserção de tags de TTS do Gemini |
skills_hub |
Skills hub | busca e instalação de skills |
triage_specifier |
Triage specifier | expande uma nota de Triage do kanban em uma especificação |
kanban_decomposer |
Kanban decomposer | decompõe uma tarefa em um grafo de subtarefas |
profile_describer |
Profile describer | descrições automáticas de profile |
curator |
Curator | passada de revisão do uso de skills |
Existem também goal_judge (satisfação do /goal), monitor (pontuação de e-mails importantes), background_review (o fork de autoaperfeiçoamento pós-turno) e os dois slots de MoA moa_reference / moa_aggregator. Todos herdam o seu modelo principal por padrão, e é por isso que você pode ter rodado “um modelo fazendo tudo” por meses sem perceber que esse canal existe — até ele quebrar.
O formato da configuração: uma chave decide em qual modelo uma tarefa roda
Toda tarefa usa o mesmo formato de bloco:
auxiliary:
  # ajustes globais
  transient_retries: 2          # tentativas no mesmo provider para um erro passageiro, limitado a 0..6
  free_only: false              # true = o tráfego de fundo nunca usa um canal PAID do OpenRouter
  openrouter_model: ""          # sobrescreve o modelo OpenRouter da cadeia automática
  stream_only_base_urls: []     # endpoints que rejeitam chat sem streaming (HTTP 400)

  # um bloco por tarefa, mesmo formato
  title_generation:
    enabled: true               # false = nenhum título
    model_upgrade_enabled: true # false = mantém o título instantâneo derivado, nunca chama um modelo
    provider: auto              # auto = herda o modelo principal
    model: ""                   # vazio = segue o provider
    prefer_fast_model: false    # true = usa a camada rápida do provider
    language: ""                # idioma dos títulos
    timeout: 30
  approval:
    provider: auto
    model: ""                   # recomenda-se aqui um modelo rápido e barato
    timeout: 30
  curator:
    timeout: 600                # a revisão de skills pode levar minutos em um modelo de raciocínio
Três erros fáceis:
provider: autosignifica “herdar o modelo principal” — não é um nome real de provider. Para fixar um modelo barato específico, defina tanto oproviderquanto omodel.- Os timeouts não são arbitrários: a classificação de aprovação tem 30 s por padrão (ela precisa ser rápida), o
kanban_decomposerrecebe 180 s e ocurator, 600 s. Comprimir com um modelo local é o caso clássico em que 120 s não bastam — a origem mais comum do “a compressão é tão lenta localmente”. - O
background_reviewtem ummax_input_tokens: 600000extra que limita o total de entrada que a autoavaliação reenvia. Aponte-o para um modelo diferente e ele reenvia um resumo compacto em vez da conversa inteira, cerca de 3–5× mais barato.
O lugar mais fácil de mudar isso é a última entrada do menu de modelos:
hermes model          # escolha "Configure auxiliary models..." no menu
hermes config get auxiliary.title_generation   # veja os valores efetivos
Plugins também podem registrar tarefas auxiliares próprias, e elas aparecem no mesmo menu. Rode hermes config get <key> antes de configurar qualquer coisa — essas chaves ainda estão mudando: no CLI v0.21.0 desta máquina, title_generation não tem o campo model_upgrade_enabled, enquanto a main já tem.
O lote de 17 de setembro: dez faces da falha silenciosa
Em 17 de setembro de 2026 entrou um grupo inteiro de correções para esse canal. O que elas têm em comum: a falha nunca levanta um erro, ela apenas produz um sintoma estranho.
| O que você vê | A causa real | PR |
|---|---|---|
| Um título que às vezes é um fragmento de JSON | a geração de título lia reasoning_content como prosa, ou gravava JSON truncado |
#113960 |
| Títulos que nunca terminam e tentativas que se acumulam | nenhum caminho de recuperação após rejeições de parâmetros empilhadas | #113958 |
| Desligar o upgrade de modelo deixa os títulos vazios | o título instantâneo derivado deveria sobreviver, mas uma chamada de modelo o sobrescrevia | #113955 |
| Um endpoint morto trava o tráfego de fundo por muito tempo | os títulos automáticos deveriam desistir depois de uma janela de timeout e nomear o endpoint que expirou | #113968 |
| Depois que o modelo principal bate a cota, o canal inteiro trava | a caminhada pelos fallback_providers não pulava um candidato limitado por cota |
#113965 |
| O DeepSeek retorna 400 em saída estruturada e o fallback morre junto | um 400 não pode matar candidatos de fallback nem custar uma primeira requisição fadada ao fracasso | #113966 |
| Tudo em segundo plano falha quando o token OAuth da xAI expira | as chamadas auxiliares deveriam se recuperar, não falhar | #113964 |
| Um provider customizado retorna um 401 silencioso | key_cmd é um callable, e cinco ramos de resolução ou chamavam .strip() nele ou enviavam seu repr como bearer token |
#114333 |
Um base_url de ollama local nunca entra em vigor |
esse canal nunca resolvia o endereço local e nunca chegava a chamar o servidor | #113961 |
O julgamento do /goal falha com um erro de juiz opaco |
ele deveria dizer que a autenticação da Nous falhou | #113963 |
A mais instrutiva: um provider customizado que usa key_cmd para cunhar um token sob demanda (a única abordagem correta quando as credenciais expiram). O runtime principal sempre passava o callable retornado adiante intacto, enquanto cinco ramos do cliente auxiliar assumiam uma string — então ou quebravam, ou enviavam <CommandTokenSource object at 0x…> ao servidor como bearer token. O segundo desfecho é pior: ele não dá erro, apenas devolve um 401 em silêncio.
Por que bugs assim são tão difíceis de rastrear
Porque eles vivem em um caminho “auxiliar” que é projetado para degradar: um título que falha não pode quebrar o seu chat, um classificador de aprovação lento deve cair para um prompt, uma compressão que falha precisa de uma rede de segurança. Degradar com elegância é o design correto, e o preço é que as falhas são engolidas. Você vê sintomas — títulos estranhos, aprovações pouco úteis, compressão lenta — em vez de uma mensagem de erro.
O que leva a uma recomendação bem prática: fixe um modelo rápido e barato para cada tarefa auxiliar (especialmente approval e title_generation). Assim, quando você trocar o modelo principal, fizer um downgrade ou perder acesso a um deles temporariamente, o comportamento de fundo continua estável — e durante a depuração você consegue dizer na hora se “o meu modelo principal mudou” ou se “o canal de fundo mudou debaixo de mim”.
Status de release
Todas as correções acima entraram na main em 17 de setembro de 2026. A release marcada mais recente, v0.21.3 (tag v2026.9.14, 14 de setembro), não as inclui. Veja o que você tem:
hermes --version
hermes config get auxiliary.title_generation
Se algum desses problemas está te incomodando agora — títulos como fragmentos de JSON e o 401 silencioso em providers customizados são os dois piores — rode hermes update e espere a próxima tag, ou acompanhe a main localmente enquanto isso.
Leitura adicional: para parar de gastar dinheiro com chamadas auxiliares, comece por como configurar o esforço de raciocínio; a compressão frequente é a mesma família de problema, coberta em compressão e a cauda enxuta; timeouts e detalhes de porta quando um modelo local roda as suas tarefas auxiliares estão no guia de modelos locais com llama.cpp; e a integração de novos providers cobre o que observar ao pendurar tarefas auxiliares em um novo fornecedor.
Resumo
- O Hermes tem um canal de chamadas em segundo plano (auxiliary) com 13 tarefas embutidas, mais os slots de MoA e de autoavaliação, todos herdando o modelo principal por padrão.
- Cada tarefa usa o mesmo bloco de configuração:
provider/model/base_url/api_key/timeout/extra_body/reasoning_effort;provider: autosignifica “seguir o modelo principal”. - Para economizar e manter previsibilidade: fixe modelos baratos nas tarefas pequenas e frequentes (
approval,title_generation) e aumente o timeout dacompressionquando um modelo local cuidar dela. - O lote de 17 de setembro corrige dez falhas silenciosas (títulos como fragmentos de JSON, um fallback de cota travado, o 401 silencioso em providers customizados e outras) e ainda não está em nenhuma release marcada.