Le second modèle que vous n'avez jamais configuré : la voie d'appel auxiliaire de Hermes
Un lundi matin, vous ouvrez votre liste de sessions et la conversation importante de la veille s’intitule {"title": "Fix the CI... — un fragment JSON tronqué. Une autre fois, vous faites passer le modèle principal sur un modèle rapide et bon marché, et l’approbation des commandes devient étrange : des commandes inoffensives sont bloquées, des commandes manifestement dangereuses passent sans problème. Quelqu’un d’autre, qui fait tourner llama.cpp en local, se plaint qu’« une compression prend plusieurs minutes ». Ces trois symptômes semblent sans rapport, mais leur origine est souvent la même voie invisible : les tâches auxiliaires.
La voie d’appel que vous utilisez chaque jour sans jamais l’avoir configurée
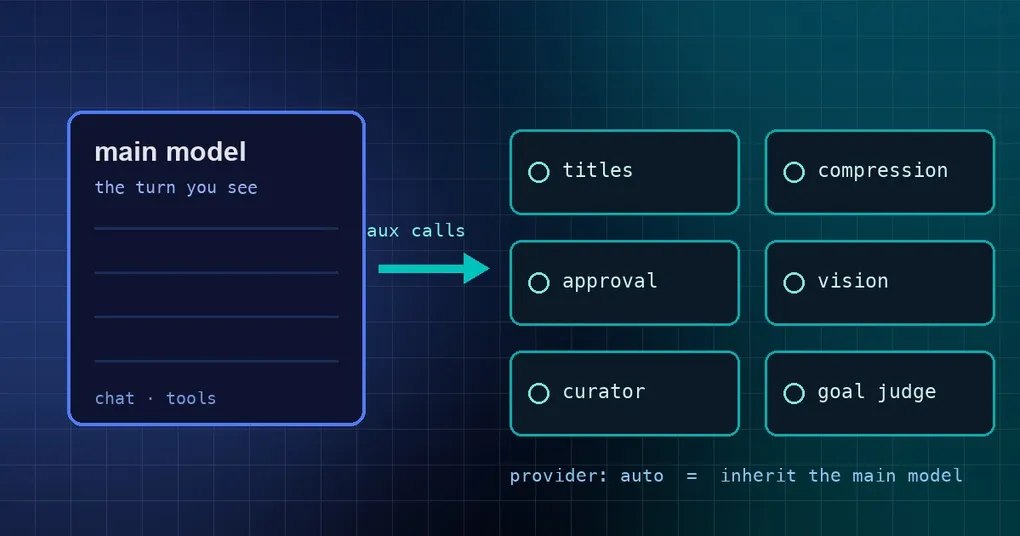
Votre modèle principal ne fait pas tout lui-même. À côté de la conversation que vous voyez, Hermes déclenche un flux de petites requêtes d’arrière-plan :
- nommer chaque nouvelle session ;
- résumer quand la fenêtre de contexte se remplit ;
- classifier si une commande doit s’arrêter et vous demander confirmation ;
- demander à un modèle de vision de décrire une image quand votre modèle principal ne traite que le texte ;
- la recherche de skills, la réécriture des requêtes de mémoire, la décomposition des tâches kanban, le juge de satisfaction de
/goal, la notation des mails, et l’auto-revue de fin de tour qui enregistre en mémoire ou corrige une skill.
Ces tâches ont des noms dans le code. Sur main, il y en a 13 intégrées :
| Clé de tâche | Nom affiché | Ce qu’elle fait |
|---|---|---|
vision |
Vision | analyse d’images et de captures d’écran (le descripteur pour les modèles principaux sans vision) |
compression |
Compression | résumé du contexte |
approval |
Approval | classifieur intelligent d’approbation des commandes |
mcp |
MCP | raisonnement sur les outils MCP |
title_generation |
Title generation | titres des sessions |
review |
Review | le subagent réviseur de /review |
memory_query_rewrite |
Memory query rewrite | réécrit les requêtes de récupération en mémoire |
tts_audio_tags |
TTS audio tags | insertion de balises TTS Gemini |
skills_hub |
Skills hub | recherche et installation de skills |
triage_specifier |
Triage specifier | développe une note Triage kanban en spec |
kanban_decomposer |
Kanban decomposer | décompose une tâche en graphe de sous-tâches |
profile_describer |
Profile describer | descriptions automatiques de profile |
curator |
Curator | passe de revue de l’usage des skills |
Il existe aussi goal_judge (satisfaction de /goal), monitor (notation des mails importants), background_review (le fork d’auto-amélioration d’après-tour) et les deux emplacements MoA moa_reference / moa_aggregator. Ils héritent de votre modèle principal par défaut, ce qui explique pourquoi vous avez pu faire tourner « un seul modèle pour tout » pendant des mois sans remarquer que cette voie existait — jusqu’à ce qu’elle casse.
La forme de la config : une clé décide sur quel modèle tourne une tâche
Chaque tâche accepte le même bloc :
auxiliary:
  # réglages globaux
  transient_retries: 2          # nouvelles tentatives chez le même provider en cas de hoquet passager, bornées à 0..6
  free_only: false              # true = le trafic d'arrière-plan n'emprunte jamais une voie OpenRouter PAYANTE
  openrouter_model: ""          # remplace le modèle OpenRouter de la chaîne automatique
  stream_only_base_urls: []     # endpoints qui refusent le chat sans streaming (HTTP 400)

  # un bloc par tâche, même forme
  title_generation:
    enabled: true               # false = aucun titre du tout
    model_upgrade_enabled: true # false = garder le titre dérivé instantané, ne jamais appeler de modèle
    provider: auto              # auto = hériter du modèle principal
    model: ""                   # vide = suivre le provider
    prefer_fast_model: false    # true = utiliser l'offre rapide du provider
    language: ""                # langue des titres
    timeout: 30
  approval:
    provider: auto
    model: ""                   # un modèle rapide et bon marché est recommandé ici
    timeout: 30
  curator:
    timeout: 600                # la revue des skills peut prendre des minutes sur un modèle de raisonnement
Trois erreurs faciles à commettre :
provider: autosignifie « hériter du modèle principal » — ce n’est pas un vrai nom de provider. Pour épingler un modèle bon marché précis, définissez à la foisprovideretmodel.- Les timeouts ne sont pas arbitraires : la classification des approbations vaut 30 s par défaut (elle doit être rapide),
kanban_decomposerdispose de 180 s,curatorde 600 s. Compresser avec un modèle local est le cas classique où 120 s ne suffisent pas — l’origine habituelle du « la compression est si lente en local ». background_reviewa unmax_input_tokens: 600000supplémentaire qui plafonne l’entrée totale que l’auto-revue rejoue. Routez-le vers un autre modèle et il rejoue un digest compact au lieu de la conversation entière, pour environ 3 à 5 fois moins cher.
L’endroit le plus simple pour changer cela est la dernière entrée du menu des modèles :
hermes model          # choisissez "Configure auxiliary models..." dans le menu
hermes config get auxiliary.title_generation   # affiche les valeurs effectives
Les plugins peuvent aussi enregistrer leurs propres tâches auxiliaires, et elles apparaissent dans le même menu. Lancez hermes config get <key> avant de configurer quoi que ce soit — ces clés bougent encore : sur la CLI v0.21.0 de cette machine, title_generation n’a pas de champ model_upgrade_enabled, alors que main en a déjà un.
La salve du 17 septembre : dix visages de défaillance silencieuse
Le 17 septembre 2026, tout un groupe de correctifs pour cette voie a été fusionné. Leur point commun : une défaillance ne lève jamais d’erreur, elle produit simplement un symptôme étrange.
| Ce que vous voyez | La vraie cause | PR |
|---|---|---|
| Un titre qui est parfois un fragment JSON | la génération de titres lisait reasoning_content comme de la prose, ou stockait un JSON tronqué |
#113960 |
| Les titres n’aboutissent jamais, les tentatives s’empilent | aucun chemin de récupération après des rejets de paramètres en cascade | #113958 |
| Désactiver la montée en gamme du modèle laisse les titres vides | le titre dérivé instantané devrait survivre, mais un appel au modèle l’écrasait | #113955 |
| Un endpoint mort bloque le trafic d’arrière-plan pendant une éternité | les titres automatiques devraient abandonner après une fenêtre de timeout et nommer l’endpoint qui a expiré | #113968 |
| Une fois le quota du modèle principal atteint, toute la voie se bloque | le parcours des fallback_providers ne sautait pas un candidat limité par son quota |
#113965 |
| DeepSeek renvoie un 400 sur la sortie structurée et le fallback meurt avec lui | un 400 ne doit pas tuer les candidats de fallback ni coûter une première requête condamnée | #113966 |
| Tout ce qui est en arrière-plan échoue dès que le token OAuth de xAI expire | les appels auxiliaires devraient se rétablir, pas échouer | #113964 |
| Un provider personnalisé renvoie un 401 silencieux | key_cmd est un callable, et cinq branches de résolution appelaient .strip() dessus ou envoyaient son repr comme bearer token |
#114333 |
Un base_url ollama local ne prend jamais effet |
cette voie ne résolvait jamais l’adresse locale et n’appelait jamais réellement le serveur | #113961 |
Le jugement de /goal échoue avec une erreur de juge opaque |
il devrait dire que l’authentification Nous a échoué | #113963 |
La plus instructive : un provider personnalisé qui utilise key_cmd pour fabriquer un token à la demande (la seule approche correcte quand les identifiants expirent). Le runtime principal transmettait toujours le callable retourné sans y toucher, tandis que cinq branches du client auxiliaire supposaient une chaîne de caractères — elles plantaient donc, ou envoyaient <CommandTokenSource object at 0x…> au serveur comme bearer token. La seconde issue est pire : elle ne renvoie pas d’erreur, elle produit juste un 401 discret.
Pourquoi de tels bugs sont si difficiles à traquer
Parce qu’elles vivent sur un chemin « auxiliaire » qui est conçu pour se dégrader : un titre raté ne doit pas casser votre conversation, un classifieur d’approbation lent doit retomber sur une demande de confirmation, une compression ratée a besoin d’un filet de sécurité. Se dégrader proprement est un choix de conception correct, et le prix à payer est que les défaillances sont avalées. Vous voyez des symptômes — des titres bizarres, des approbations inutiles, une compression lente — au lieu d’un message d’erreur.
D’où une recommandation très concrète : épinglez un modèle rapide et bon marché pour chaque tâche auxiliaire (surtout approval et title_generation). Ainsi, quand vous changez de modèle principal, que vous en rétrogradez un ou que vous perdez temporairement l’accès à l’un d’eux, le comportement d’arrière-plan reste stable — et pendant un débogage, vous savez immédiatement si c’est « mon modèle principal qui a changé » ou « la voie d’arrière-plan qui a changé sous mes pieds ».
État des versions publiées
Tous les correctifs ci-dessus ont été fusionnés dans main le 17 septembre 2026. La version taguée la plus récente, v0.21.3 (tag v2026.9.14, 14 septembre), ne les contient pas. Vérifiez ce que vous avez :
hermes --version
hermes config get auxiliary.title_generation
Si l’un d’eux vous mord vraiment — les titres en fragment JSON et le 401 silencieux sur les providers personnalisés sont les deux pires — lancez hermes update et attendez le prochain tag, ou suivez main en local en attendant.
Pour aller plus loin : pour éviter que les appels auxiliaires ne brûlent de l’argent, commencez par comment configurer l’effort de raisonnement ; la compression fréquente relève de la même famille de problèmes, traitée dans la compression et la queue allégée ; les timeouts et les détails de ports quand un modèle local exécute vos tâches auxiliaires sont dans le guide llama.cpp local ; et l’accueil de nouveaux providers explique ce qu’il faut surveiller quand vous confiez des tâches auxiliaires à un nouveau fournisseur.
En résumé
- Hermes possède une voie d’appel d’arrière-plan (auxiliary) avec 13 tâches intégrées, plus les emplacements MoA et d’auto-revue, toutes héritant du modèle principal par défaut.
- Chaque tâche accepte le même bloc de config :
provider/model/base_url/api_key/timeout/extra_body/reasoning_effort;provider: autosignifie « suivre le modèle principal ». - Pour économiser et rester prévisible : épinglez des modèles bon marché sur les petites tâches à haute fréquence (
approval,title_generation), et augmentez le timeout decompressionquand un modèle local s’en charge. - La salve du 17 septembre corrige dix défaillances silencieuses (titres en fragment JSON, un fallback bloqué par le quota, le 401 silencieux sur les providers personnalisés, et d’autres) et n’est encore dans aucune version taguée.