Mixture of Agents, explicado: pague duas vezes, receba uma resposta melhor
Existem trabalhos chatos não porque são difíceis de codificar, mas porque são difíceis de pensar a respeito. Reescrever a arquitetura de um scheduler que roda há três anos e que ninguém tem coragem de tocar. Reconstruir a linha do tempo de um incidente a partir de um log de 45 MB. Você faz a mesma pergunta três vezes e recebe três respostas, cada uma errada de um jeito diferente — juntas, estariam certas.
O Mixture of Agents (MoA) transforma “pergunte a três modelos” em um pipeline: vários reference models analisam o problema primeiro, e um aggregator lê o conselho deles e faz o trabalho de verdade. Este post vai de como ele roda até quem paga por ele, e termina com uma mudança recente fácil de interpretar errado.
1. O MoA em uma frase
O MoA não é uma tool nem um toggle — é um provider de modelo virtual. Cada preset nomeado que você configura aparece como um modelo selecionável sob o provider moa, então você pode escolhê-lo em qualquer lugar onde escolhe um modelo: CLI, TUI, gateway, dashboard, app desktop. Estruturalmente, ele fica no mesmo nível de anthropic ou openrouter.
Depois que um preset é selecionado:
- Os reference models rodam primeiro. Eles recebem apenas o texto de usuário e de assistente da conversa — nem o system prompt do Hermes, nem a transcrição de chamadas de tool — o que mantém essas chamadas baratas e evita rejeições de providers estritos.
- O aggregator é o modelo que age. Ele é chamado com o schema de tools normal do Hermes, escreve a resposta que você vê e emite chamadas de tool, que o Hermes executa como de costume.
- Na próxima iteração de modelo, todo o processo do MoA roda de novo sobre a conversa atualizada, resultados de tools incluídos.
Esse é o modelo mental: o aggregator é o protagonista, os references são conselheiros consultados uma vez por turno.
2. Configurando
Três caminhos, escolha o que couber:
- Dashboard → Models → Model Settings → Mixture of Agents
- Desktop app → Settings → Model → Mixture of Agents
- Linha de comando:
hermes moa configure [preset-name]
Ou escreva o config.yaml direto. Este é o preset padrão documentado:
moa:
  default_preset: default
  presets:
    default:
      reference_models:
        - provider: openai-codex
          model: gpt-5.5
        - provider: openrouter
          model: deepseek/deepseek-v4-pro
      aggregator:
        provider: openrouter
        model: anthropic/claude-opus-4.8
      enabled: true
A config guarda pares explícitos de provider/model, então você pode misturar fornecedores e usar dois modelos do mesmo fornecedor. Dois campos opcionais de temperatura (reference_temperature, aggregator_temperature) simplesmente não são enviados quando omitidos, deixando cada modelo usar o padrão do seu provider — o mesmo comportamento de um agente de modelo único.
Gerenciando presets pelo terminal:
hermes moa list                 # mostra os slots atuais
hermes moa configure review     # cria ou atualiza um preset chamado review
hermes moa delete review        # apaga um preset
Três formas de usar um de fato:
/model review --provider moa        # troca esta sessão para o preset review
/moa design a migration plan for this flaky test cluster    # um disparo só, depois volta ao modelo anterior
/moa é deliberadamente uma conveniência de disparo único: ele troca temporariamente para o preset padrão, envia seu prompt e restaura o modelo em que você estava. Ele nunca muda sua seleção de modelo, então um prompt normal não pode te colocar no MoA por acidente. Um /moa sozinho, sem prompt, apenas imprime o uso.
3. Quem é cobrado
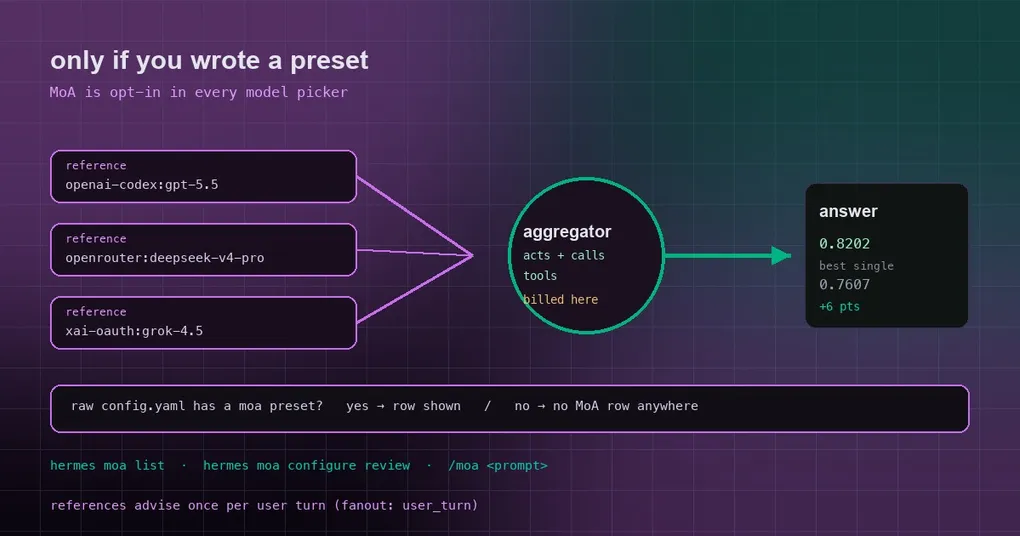
Esta é a parte que as pessoas perdem: o aggregator paga pela execução inteira. Ele roda cada passo do loop de tools, então quase todo o custo de um preset cai no provider do aggregator; os references aconselham uma vez por turno de usuário na cadência padrão.
A armadilha clássica: seu modelo principal roda em um provider de assinatura, e o aggregator do preset está em outro. Esse turno é cobrado no provider do aggregator, não na sua assinatura. Para evitar a surpresa, hermes moa list e hermes moa configure imprimem uma linha extra sempre que o provider do aggregator difere de model.provider, e o editor do desktop e o /model marcam o slot do aggregator como o modelo que age e que é cobrado.
Com que frequência os conselheiros rodam é a configuração fanout, e ela escala o custo diretamente:
fanout: user_turn(o padrão) — os conselheiros rodam uma vez, na primeira mensagem de cada turno de usuário, e o aggregator que age segue sozinho pelo resto do loop de tools. O mais barato por construção: o custo dos conselheiros não se multiplica com as chamadas de tool.fanout: per_iteration— os conselheiros rodam de novo a cada iteração de tool, então o conselho deles sempre acompanha os resultados mais recentes, ao custo de multiplicar a latência e o gasto dos conselheiros pelo número de chamadas de tool de um turno.fanout: every_n:3— o meio-termo: os conselheiros rodam na primeira iteração de cada turno de usuário e depois a cada terceira iteração de tool (qualquer N de 2 para cima funciona). As iterações intermediárias reutilizam a última orientação dos conselheiros, então o aggregator continua com conselho em cada passo — ele só é atualizado a cada N passos. O contador reinicia a cada nova mensagem de usuário.
Valores malformados caem de volta para user_turn. Note que o próprio padrão mudou: antes de julho de 2026 ele era per_iteration. Presets que querem conselho a cada passo precisam defini-lo explicitamente.
4. A mudança atual: sem preset, sem linha MoA
Esta é a correção de comportamento recente (PR #126509, issue #63353) que é fácil de ler errado como “o MoA foi desligado”.
A linha do seletor de modelos era construída a partir da config mesclada, e a config padrão carrega um esqueleto sintetizado de preset MoA. Então, mesmo que você nunca tivesse escrito um bloco moa:, sua lista de modelos mostrava uma linha de provider MoA com um preset default sintetizado — o que dava a impressão de que o MoA estava ativo por padrão.
A linha agora é condicionada por _raw_config_has_enabled_moa_preset(), que lê seu config.yaml cru, sem mesclar os padrões: a linha só aparece se você mesmo habilitou um preset (ou carrega uma config MoA achatada legada). O inventário da CLI e o seletor interativo do gateway compartilham um único construtor de linha, então as duas superfícies foram corrigidas de uma vez.
Na prática: se você nunca configurou o MoA, sua lista em /model é mais curta e mais limpa. Se configurou, nada muda — seus presets continuam aparecendo exatamente onde apareciam.
5. Detalhes que vale saber
- O prompt cache sobrevive. Selecionar um preset MoA é uma seleção de modelo normal: não reescreve o contexto passado, não troca toolsets nem reconstrói o system prompt no meio da conversa. A saída dos references é anexada como uma mensagem própria no final em vez de ser mesclada na sua, então o prefixo em cache fica intacto. Templates que exigem alternância estrita usuário/assistente (templates Jinja do llama.cpp e do vLLM, algumas rotas do OpenRouter) rejeitam isso com um 400; o Hermes tenta de novo aquela requisição com as duas mensagens adjacentes de usuário mescladas, memoriza a preferência do destino pelo resto da sessão e deixa todos os outros destinos na forma estável em cache.
- Limites de saída são do provider. Tetos de output-token em nível de preset e por slot não são mais suportados; valem os padrões do provider.
- Filtro de privacidade:
moa.privacy_filtervem desligado por padrão.displayredige apenas as superfícies visíveis ao usuário (os blocos de reference na UI e os registros quesave_tracesgrava);fulltambém redige o texto dos conselheiros injetado no prompt do aggregator. Formatos de credencial — prefixos de API key, JWTs, chaves privadas, strings de conexão de banco — são tratados pelo redator central de segredos do Hermes. - Profundidade de raciocínio por slot: tanto os slots de reference quanto o de aggregator podem definir
reasoning_effort(none,minimal,low,medium,high,xhigh,max,ultra), então um modelo pode atuar como conselheiro rápido e outro como pensador profundo. - Um desligamento por preset:
enabled: falsedesativa o fan-out de references daquele preset, então o aggregator age sozinho exatamente como se você o tivesse selecionado como um modelo comum. - Limites: um aggregator não pode ser outro preset MoA (árvores recursivas são bloqueadas); a falha de credencial de um único reference model não aborta o turno — a falha é incluída no contexto de reference e a execução continua; o MoA não é mais listado em
hermes tools, e não há toolsetmoapara habilitar. - Ele pode ser um fallback: um preset funciona como entrada em
fallback_providers(por exemplo{provider: moa, model: <preset>}). Quando o primário falha, o Hermes ativa o preset em si — references e aggregator, commoa://localcomo endpoint virtual.
6. O bench oficial: cerca de seis pontos acima do seu melhor componente
No HermesBench, um preset de dois modelos (gpt-5.5 como reference, claude-opus-4.8 como aggregator):
| Configuração | Score do HermesBench |
|---|---|
| Opus aggregator (opus-4.8 + gpt-5.5 reference) — MoA | 0.8202 |
anthropic/claude-opus-4.8 alone |
0.7607 |
openai/gpt-5.5 alone |
0.7412 |
Então não é uma média: ele supera seu componente mais forte em cerca de seis pontos, o que é o argumento para comprar uma segunda perspectiva em tarefas difíceis.
7. Quando não usar
O MoA aumenta o número de chamadas de modelo — uma iteração pode significar várias chamadas de reference mais a chamada do aggregator. Para tarefas do dia a dia, conversões de formato e buscas simples, um único modelo é mais rápido e mais barato. Ele justifica seu custo nos trabalhos em que uma suposição errada significa refazer meio dia de trabalho: desenho de arquitetura, post-mortems de incidentes, planos de migração, revisão de um refactor complexo.
Se você está ajustando o roteamento de modelos, combine isso com nosso guia da lane de modelo auxiliar (quais chamadas passam pela lane auxiliar) e o guia de model overrides; para tomada de controle automática quando o modelo primário falha, o guia de fallback em três camadas cobre a cadeia. E para entender por que o MoA não perturba o prefix cache, veja o post sobre compartilhamento de cache. Detalhes dos comandos: referência de hermes moa.