Warum ein Gateway-Neustart denselben Cache zweimal bezahlt
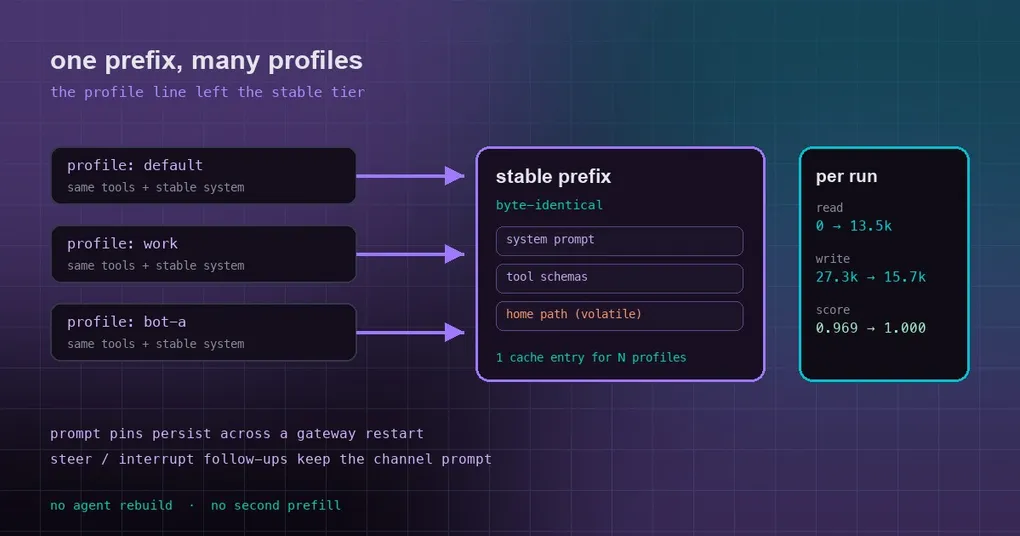
Ein Gateway, drei Profile: deins, eines für einen Team-Workflow, ein Bot in einem Gruppenchat. Du stellst dem Bot im Gruppenchat eine Frage, öffnest eine Sekunde später deine eigene Session und fragst dasselbe — und beides wird als Erstkontakt abgerechnet. Die cache write-Zeilen in der Rechnung sehen unauffällig aus, doch die erste Nachricht nach jedem Gateway-Neustart ist langsam, und zwar so, als hätte das Modell deinen System-Prompt noch nie gesehen.
Die Regel ist einfach: der Provider verwendet nur ein byte-identisches Prefix wieder. Ändere ein Zeichen darin, und alles danach wird neu berechnet. Hermes teilt seinen System-Prompt genau aus diesem Grund schon in die Stufen stable, context und volatile auf. Drei am 2026-09-28 gemergte Fixes jagten ein gemeinsames Fehlerbild: Entweder war etwas in die stable-Stufe gerutscht, das dort nicht hingehört, oder etwas, das hätte geerbt werden sollen, wurde es nicht.
1. Eine Zeile in der stable-Stufe, die sich pro Profil unterschied
In agent/system_prompt.py wird der System-Prompt aus den Blöcken stable, context und volatile zusammengesetzt. Tool-Schemas und der stable System-Prompt liegen in stable — diese Bytes müssen unter allen Umständen identisch bleiben, sonst kann keiner der dahinterliegenden Gesprächsverlauf wiederverwendet werden.
Das Problem war die Zeile Active Hermes profile: .... Ihre ganze Aufgabe ist es, dem Modell zu sagen, welche Verzeichnisse es liest und schreibt, ihr Text enthält also den Home-Pfad des Profils. Sie saß in der stable-Stufe — was bedeutete, dass jedes andere Profil, jede andere Maschine, jede Session mit einem anderen Home ein anderes stable Prefix erzeugte. Ein multiplexendes Gateway, das N Profile bedient, bezahlte N Cache-Writes, statt einen Eintrag zu teilen.
Diese Zeile reist jetzt in der volatile-Stufe, nach dem übrigen volatile Inhalt. Das Ergebnis ist ein stable-Prefix, das über Profile und Homes hinweg byte-identisch ist. Der neue Test im Repository sagt es klar: test_stable_tier_is_identical_across_homes.
Die Produktionsänderung sind fünf hinzugefügte und zwei entfernte Zeilen. Der Benchmark aus demselben PR zeigt, was das wert ist: 16 Tasks (9 standard, 7 hard), 2 Modelle × 2 Wiederholungen, jede Anfrage über denselben Inference-Endpoint geroutet und ein deterministischer versteckter Grader pro Task.
| Konfiguration (jeweils n=32) | Score | Tokens/Lauf | $/Lauf | Anfragen/Lauf |
|---|---|---|---|---|
| Referenz-CLI-Agent A, opus-5.5 | 1,000 | 146k | 0,158 | 5,4 |
| Hermes vorher, opus-5.5 | 0,969 | 155k | 0,245 | 6,8 |
| Hermes nachher, opus-5.5 | 1,000 | 152k | 0,173 | 6,1 |
| Referenz-CLI-Agent B, gpt-5.6-terra | 0,995 | 145k | 0,123 | 9,4 |
| Hermes vorher, gpt-5.6-terra | 0,968 | 121k | 0,110 | 7,5 |
| Hermes nachher, gpt-5.6-terra | 1,000 | 115k | 0,108 | 7,1 |
Nur die Cache-Seite: Vorher las die erste Anfrage eines Opus-Laufs 0 gecachte Tokens und schrieb etwa 20k. Nachher liest sie 13,5k, und die Cache-Writes pro Lauf fallen von 27,3k auf 15,7k.
Eine ehrliche Einschränkung, damit du nicht zu viel erwartest: Eine Single-Profile-Installation mit festem Home hat dieses Prefix schon vorher über Sessions hinweg wiederverwendet, du wirst es dort also nicht spüren. Der Gewinn liegt bei Multi-Profile- und multiplexenden Hosts sowie in Benchmarks wie dem oben, in dem jeder Lauf ein frisches Home bekommt.
2. Nach einem Neustart kippte das erste interne Event den Prompt A → B → A
Der zweite Fix dreht sich um den ersten Atemzug nach einem Neustart.
Das erste, was nach einem Gateway-Neustart eintrifft, ist meist keine menschliche Nachricht, sondern ein internes Event — ein Kanban-Wake, eine abgeschlossene Delegation, ein Startup-Resume. Diese Turns renderten früher einen System-Prompt, und der nächste menschliche Turn renderte wieder den ursprünglichen: A → B → A. Der Preis war ein Prompt-Cache-Miss plus ein Agent-Rebuild und ein vollständiges Neu-Prefill des Gesprächs.
Interne Turns verwenden jetzt die System-Prompt-Bytes des letzten menschlichen Turns wieder. Mechanisch ist es ein Pin-Snapshot:
- der Routing-Eintrag (state.db
gateway_routingplus einsessions.json-Spiegel) speichert ihn; - er wird vor dem Agent-Lauf bei jedem menschlichen Turn geschrieben und beim ersten internen Turn nach einem Neustart zurückgelesen;
- Lesen und Schreiben sind über die Session-ID abgeschottet;
/resumeund CLI-Handoff löschen den Pin — eine gewechselte Session darf keine alten Bytes erben.
Ein Privacy-Detail verdient eine eigene Erwähnung: Der Pin hält fest, unter welcher privacy.redact_pii-Policy er gerendert wurde, und Bytes, die unter einer anderen Policy gerendert wurden, werden nie wiederverwendet. Sonst könnte ein einziger Neustart Inhalte, die hätten redigiert werden müssen, in unredigierter Form verschicken. Das deckt interne Events nach einem Neustart ab und — da dieselbe Umgehung auch dort existierte — interne Events innerhalb eines Prozesses.
3. Der halbe Satz, den ein /steer hinterlässt, ließ den Channel-Prompt fallen
Der dritte Fall tritt auf, nachdem du einen Lauf mit /steer korrigiert oder eine Generierung unterbrochen hast.
Der Text, den du angehängt hast — oder die Unterbrechung selbst —, wird oft zum nächsten Turn. Dieser Turn startete früher mit channel_prompt = None, was die Telegram-Gruppen-Identitätszeile, deine YAML-channel_prompts und die Slack-Identität aus dem System-Prompt entfernte. Der Prompt hatte sich geändert, also wurde der gecachte Agent neu gebaut und das ganze Gespräch neu geprefillt. Dann kippte deine nächste menschliche Nachricht es zurück, und du bezahltest dasselbe zweimal.
Der wirksame Fix ist eine Zuweisung: Gibt es kein anstehendes Event, erbt der Follow-up den Channel-Prompt des Turns, auf den er folgt (_run_agent_queued_followup in gateway/run_turn.py). Event-gestützte Follow-ups bleiben unberührt — sie lösen weiterhin ihren eigenen Prompt auf.
Was das für dich bedeutet
- Multi-Profile-Hosts: N Profile teilen jetzt einen stable-Prefix-Cache-Eintrag, statt N davon zu schreiben. Es gibt nichts zu konfigurieren; update, und du hast es.
- Die erste Nachricht nach einem Neustart: kein Kaltstart mehr. Sie trifft den Cache, den sie treffen soll.
- Nach einer Unterbrechung im Gruppenchat: kein „einen Satz korrigiert, das ganze Gespräch neu berechnet“ mehr auf der Rechnung.
Um die Stufen und ihre Größen selbst zu sehen, führe hermes prompt-size aus — es gibt eine Byte-Aufschlüsselung des System-Prompts plus der Tool-Schemas aus. Das Multi-Profile-Setup selbst behandelt unser Multiplexing- und Profile-Guide; wenn du am Routing schraubst, erklärt der Guide zur Auxiliary-Model-Lane, welche Calls eigene Cache-Einträge schreiben. Alle drei Fixes brauchen den neuen Code, also führe hermes update aus (der Upgrade-Walkthrough). Und weil es dieselbe Woche ist: Hier ist, wie MoA diesen Cache nicht kaputt macht — der Mixture-of-Agents-Guide.