重启一次网关,为什么又白付一遍缓存钱
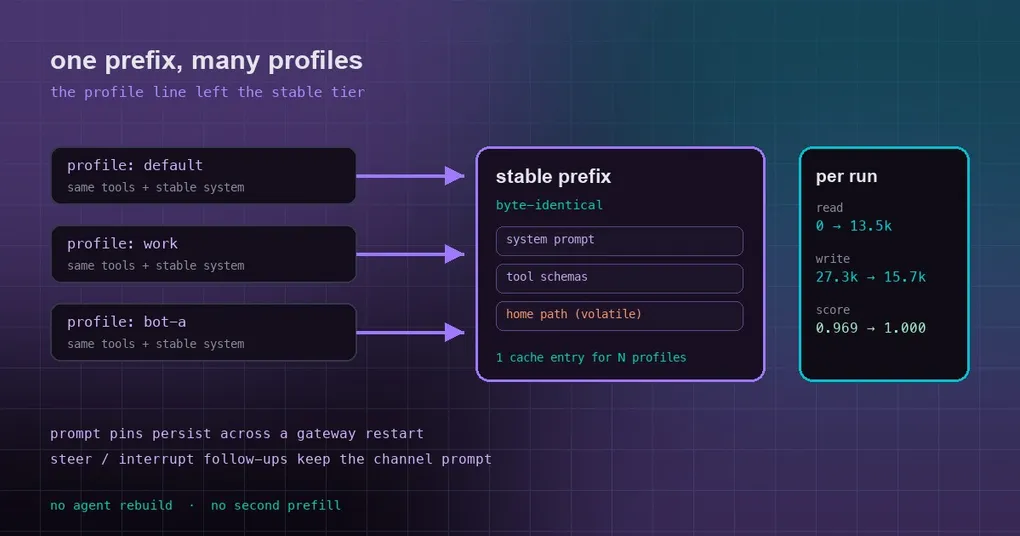
同一个网关跑着三个 profile:一个给你自己用,一个给团队的工作流,还有一个挂在群里当机器人。你在群里问机器人一个问题,下一秒自己开个会话问同样的事,然后发现——两边都在“第一次”付钱。账单上那些 cache write 数字看起来很正常,但每次重启网关后的第一条消息都要慢上一大截,像是模型从来没见过你的系统提示。
缓存的规则其实很简单:服务端只认字节完全相同的前缀。前缀里改一个字符,后面所有内容都得重新算一遍。Hermes 的系统提示本来按“稳定 / 上下文 / 易变”三层组织,就是为这件事服务的。2026-09-28 合并的三个修复,修的都是同一个毛病:有东西跑进了稳定层,或者该继承的东西没继承。
一、稳定层里混进了一行“每个 profile 都不一样”的话
打开 agent/system_prompt.py,你会看到系统提示被拆成 stable、context、volatile 三块。工具 schema 和稳定系统提示属于 stable——这部分的字节必须在任何情况下都保持一致,否则后面每一条对话历史都无法复用。
问题出在 Active Hermes profile: ... 这一行。它要告诉模型“你现在读写的目录是哪个”,所以文本里带着 profile 的 home 路径。而它原本被放在 stable 层——于是每换一个 profile、每换一台机器、每个 home 路径不同的会话,稳定前缀的字节全都不同。一个同时服务 N 个 profile 的多路复用网关,就变成了付 N 份缓存写入,而不是共享同一条缓存记录。
现在这一行挪到了 volatile 层(也就是易变尾部),位置在其他易变内容之后。效果是 stable 前缀在不同 profile、不同 home 之间逐字节一致。仓库里新增的测试名字很直白:test_stable_tier_is_identical_across_homes。
改动本身只有 5 行新增、2 行删除,但同一批改动附带的基准测试说明了它的分量:16 个任务(9 个标准 + 7 个硬任务),2 个模型 × 2 次重复,全部请求走同一个推理端点,每个任务都有确定性的隐藏评分器。
| 配置(每组 n=32) | 得分 | tokens/次 | 美元/次 | 请求数/次 |
|---|---|---|---|---|
| 参照 CLI agent A,opus-5.5 | 1.000 | 146k | 0.158 | 5.4 |
| Hermes 改前,opus-5.5 | 0.969 | 155k | 0.245 | 6.8 |
| Hermes 改后,opus-5.5 | 1.000 | 152k | 0.173 | 6.1 |
| 参照 CLI agent B,gpt-5.6-terra | 0.995 | 145k | 0.123 | 9.4 |
| Hermes 改前,gpt-5.6-terra | 0.968 | 121k | 0.110 | 7.5 |
| Hermes 改后,gpt-5.6-terra | 1.000 | 115k | 0.108 | 7.1 |
单看缓存:改前 Opus 每一次运行的首个请求读到 0 个缓存 token、写出约 20k;改后首请求读到 13.5k,整轮运行的缓存写入从 27.3k 降到 15.7k。
有一点要说清楚,避免过度期待:单 profile、固定 home 的安装本来就会跨会话复用这条前缀,那类环境下你感受不到变化。收益集中在多 profile 和多路复用的主机上,以及像上面这种每个 run 都给一个新 home 的评测场景。
二、重启网关之后,第一条内部事件会把提示翻来覆去
第二条修复针对的是重启后的第一口气。
网关重启后,第一件到达的事往往不是人发的消息,而是内部事件——看板(kanban)唤醒、子代理完成回调、启动时的会话恢复。这些事件原先会让系统提示从 A 翻到 B 再翻回 A:先按内部事件自己的规则渲染一份提示,下一次人类回合又渲染回原来那份。结果是一次缓存未命中 + 一次 agent 重建,整段对话重新预填充。
现在这些内部回合会复用上一个人类回合渲染出的系统提示字节。落地的做法是把“pin 快照”写进状态里:
- 路由记录(
state.db的gateway_routing加一份sessions.json镜像)保存这份快照; - 每个人类回合开始运行 agent 之前写入一次,重启后的第一个内部回合读回来;
- 读写都以 session id 为边界做校验;
/resume和 CLI handoff 会清除这个 pin——换了会话就不该沿用旧字节。
还有一条隐私上的细节值得单独提:这份 pin 会记录它是在哪个 privacy.redact_pii 策略下渲染的。在不同策略下渲染的字节永远不会被复用——否则一次重启就可能把本该脱敏的内容按未脱敏的形态送出去。这条不仅覆盖重启后的内部事件,也覆盖同进程内的内部事件。
三、/steer 留下的那半句话,把 channel prompt 弄丢了
第三条发生在你用 /steer 纠偏、或者打断一次生成之后。
被打断、或者通过 /steer 追加的那段文字,很可能成为下一个回合。原来这个回合以 channel_prompt = None 开始——于是 Telegram 群组身份行、config.yaml 里的 channel_prompts、Slack 的身份说明全都从系统提示里消失了。系统提示变了 → 缓存的 agent 被重建 → 整段对话重新预填充。更糟的是,下一条人类消息会把提示翻回原样,于是再付一次同样的代价。
修复只有一行有效逻辑:在没有待处理事件时,让这个后继回合沿用它所跟随的那个回合的 channel prompt(gateway/run_turn.py 的 _run_agent_queued_followup)。由真实事件驱动的后继回合不受影响——它们照旧解析自己该用的提示。
这三件事对你怎么体现
- 多 profile 的主机:N 个 profile 现在共享同一条稳定前缀缓存,而不是各写一份。你什么都不用配,升级即可。
- 重启后的第一句话:不再冷启动。第一条消息该命中缓存就命中。
- 群里被打断之后:不再出现“纠正一句话,整段对话重新算一遍”的账单。
想自己看提示的分层和体积,可以跑 hermes prompt-size——它会打印系统提示与工具 schema 的字节分解。多 profile 网关的配置方法见我们之前写的 多路复用与 profile 指南;如果你在调模型路由与辅助模型通道,辅助模型通道指南里解释了哪类调用会额外产生缓存写入。这三个修复都需要新代码,跑一次 hermes update 即可(升级流程)。顺带一提,同一周我们还写过 MoA 如何做到不破坏缓存:Mixture of Agents 指南。