gateway 多路复用默认开启:一个进程服务所有 profile
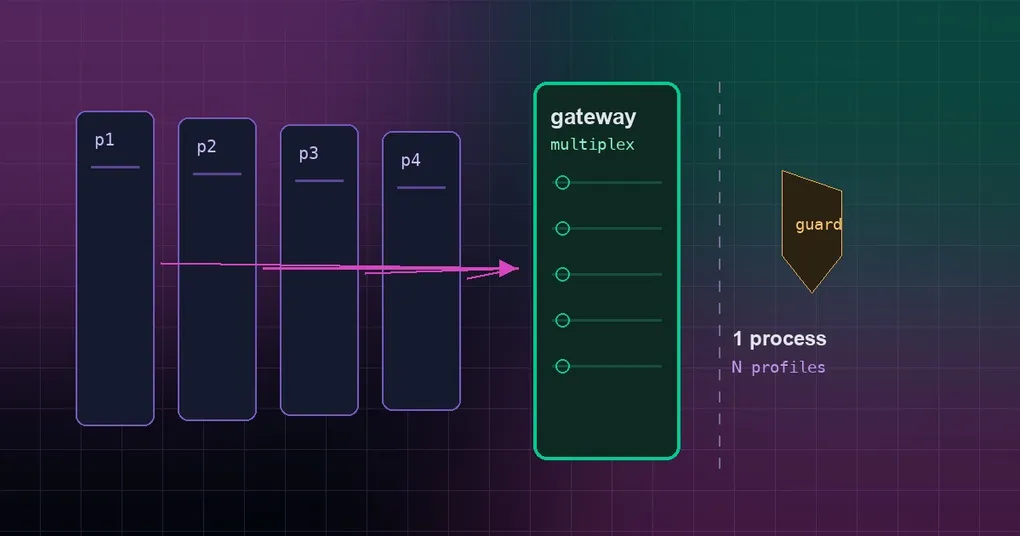
周一早上群里没人回话。你在一台机器上跑着三个 Hermes profile——default、coder、research——每个都有自己的 systemd unit、自己的端口,还有一条 hermes -p coder gateway start 要你记得敲。昨晚那次重启只回来两个,而其中某个 profile 的 Telegram token 同时被两个进程轮询,同一条消息被回了两次。你什么都没改,只是每加一个 bot,机器上就多一份要单独照看的东西。Hermes 对“一台机器上多个 bot”这个问题给的答案很直接:让一个 gateway 进程服务机器上所有 profile——从 2026-09-16 起,这就是默认行为,同时配了一道启动守卫,保证现有安装不会在不知情的情况下被改掉。
先把“多路复用 gateway”说清楚
三个词先落地。profile 是一份自包含的 Hermes agent:自己的配置、凭据、记忆、技能和定时任务,放在 ~/.hermes/profiles/<name> 下面。gateway 是那个常驻进程,负责让你的 bot 一直在线:轮询 Telegram、接 webhook、唤醒定时任务,把收到的每条消息交给一次 agent turn。多路复用(multiplexing) 说的就是让一个 gateway 进程同时服务多个 profile。
在此之前,标准形态是每个 profile 一个进程(文档里叫 standalone,也就是 --standalone 会恢复的那种):每个 profile 有自己的 unit、自己的端口、自己的 PID 文件。多路复用把这队进程换成一个:默认 profile 的 gateway 成为唯一的入站进程,服务机器上每一个 profile,并把每条入站消息路由回它所属的那个。profile 本身依然是各自独立的 agent——被共享的只有进程。
如果你更想按 profile 分开管理,那套做法完全保留,多实例 profile 指南里有完整走法。
现在改了什么:默认开启,但每次启动都会重新判定
gateway.multiplex_profiles 的默认值变成了开启。真正值得留意的是“你从没设过这个值”时发生什么:未设置被当成一个请求,而不是一个结论,默认 gateway 会在每次启动时把这个请求判定一次。
启动时它会跑一遍与 hermes gateway migrate --multiplex 相同的 preflight,只有这次收拢本来就安全,才真的切成多路复用:
- 默认 profile 存在,且机器上有两个或更多 profile;
- 没有任何次级 profile 还在跑自己的 gateway(活着的进程或已安装的服务都算);
- 没有两个 profile 共用同一份 bot 凭据;
- 没有“绑定端口的平台缺少
/p/<profile>/入站路径”的情况; - 这台机器是迁移能处理的类型(不是 s6 容器,也不是 Windows Scheduled Tasks)。
上面任何一条不成立,gateway 就完全按以前的样子起来——只服务默认 profile——并打一条 WARNING,写明是哪一条挡住了,顺手把 hermes gateway migrate --multiplex 这条命令告诉你。磁盘上什么都不改。
而显式写下的值永远不会被二次猜测:
gateway.multiplex_profiles: true(迁移会写入的值):无视 preflight,直接多路复用——这是你或迁移做出的决定;gateway.multiplex_profiles: false(--standalone恢复的值):永久保持每 profile 一个 gateway;关掉之后,本文下面所有行为都不生效;- 进程环境变量
GATEWAY_MULTIPLEX_PROFILES的优先级高于以上两者。
无论判定结果是什么,它都会被记下来,而不只是打一行日志:默认 home 的 gateway_state.json 里会记录 multiplex_standalone_reason,hermes gateway status 会把它打印成 ⚠ Serving the default profile only (gateway.multiplex_profiles unset): <reason>,并附上两条补救路径。等某次启动真的切成多路复用了,这个记录会被清掉。
其它进程也不再靠“合并后的默认值”猜结论:hermes -p coder setup、dashboard、定时任务触发时的端口解析、hermes gateway migrate 都会先读运行中 gateway 的 served_profiles 记录,只有没有任何 gateway 在跑时才退回去看那个显式开关。
怎么确认自己现在处于哪种模式
一条命令就够了:
hermes gateway status- 如果输出里有
Serving the default profile only ...那一行,你现在是 standalone,冒号后面就是这次启动守卫拦下来的原因; - 如果没有那一行,说明 gateway 正以多路复用模式运行。它的自我记录——默认 home 的
gateway_state.json里的served_profiles——会列出它服务的每一个 profile,这也是其它工具读取的来源。
在 dashboard 上,同样的信息在 System 页面;接口层面,/api/status?profile=coder 会把它作为 gateway_shared_with 返回(该 profile 自己拥有 gateway 时是 null)。
想动手确认也可以:试着启动一个次级 profile 的 gateway——多路复用模式下 CLI 会直接拒绝(见下),standalone 模式下它会正常起来。
一个 gateway,还是每个 profile 一个进程?
多路复用更适合这几种情况:
- 容器 / VPS 上,N 个 supervisor unit、N 个端口、N 个 PID 文件本身就是负担;
- 很多低流量的 profile,每一个都不值得独占一个进程;
- 你希望只有一样东西需要启动、监控和重启。
加一个 profile 的成本也随之降到“加一个 bot token”——运行中的 gateway 会直接接上它,而不必再养一个 service。在运行中的 gateway 上热接入 profile 讲的就是这条热路径。
反过来,如果你需要 profile 之间硬性的进程级隔离,就继续用每 profile 一进程:各占一份内存、各自的崩溃域、可以单独重启一个而不动其它。当某个跑飞的技能有可能把整个进程拖下水时,这一点比省几个 unit 重要得多。
主动把整队收拢成一个 gateway
与其重启默认 gateway 然后指望启动守卫同意,不如显式跑迁移:
hermes gateway migrate --multiplex它的动作顺序是:先在默认 profile 上写入 gateway.multiplex_profiles: true,停掉并卸载每个次级 profile 已安装的 unit,再把默认 gateway 作为 multiplexer 拉起来,最后从它实时的 served_profiles 记录确认清单里每个 profile 都真的在被服务。
这个过程是事务性的。开关先落盘,所以在那之后任何一步被杀掉都可以续跑:重跑同一条命令会读取迁移写下的 manifest,并从实时状态继续——运行中的默认 gateway 记录的 served_profiles 必须覆盖 manifest 里迁移过的每一个 profile,才算真正完成。如果后续某一步失败(停掉某个次级、卸载 unit 后的 daemon-reload、写配置),已经移除的次级会当场装回来、开关也回滚。回滚没能完整完成时,manifest 会保留下来并明确告诉你,剩下的可以手工收尾。
它还会提前拒绝:在计划阶段就能看出这次收拢行不通时,任何还在正常工作的 gateway 都不会被停掉——比如一队以 root 运行的 system unit 却没有记录下 User=、记录的用户在系统里解析不到、或者 config.yaml 不可写。system unit 的 User= 会被保留:迁移在移除之前先把它读出来,带进默认 gateway 的启动和回滚流程。
如果你不是在迁移、而是在新机器上从零开始,那更简单:装好 Hermes 后让默认 gateway 起来就够了,启动 preflight 会把剩下的判定做完。
打开之后,哪些行为不一样了
多路复用意味着默认 gateway 是唯一的入站进程,所以同一个 profile 再起一个 gateway 就会把它的平台绑两次。下面这些行为都是自动的,开关一关就全部失效。
次级 profile 不能再启动自己的 gateway。 hermes -p coder gateway run、start、install、restart 都是硬错误,退出码 78,并把你指回 multiplexer:“The default gateway is running as a profile multiplexer and already serves profile ‘coder’.” 这个拒绝发生在 CLI 里,在碰任何服务管理器之前,所以一个被服务的 profile 永远不会留下一个永久失败的 systemd unit,或者一个不停重启的 launchd 循环。当 coder 自己没有 gateway 时,hermes -p coder gateway stop 同样会以退出码 78 拒绝——此时除了 multiplexer 没有别的东西可停,而在默认 profile 上执行 hermes gateway stop 会替所有被服务的 profile 一起停掉。
Dashboard 和桌面端遵循同一套规则。 对被服务的 profile,“Start” 和 “Stop” 两个 action 返回 409 并给出同样的解释(渲染成 System 页面上的一条内联提示),而 “Restart” 重启的是 multiplexer——真正在服务这个 profile 的那个进程——而不是去 spawn 一个只可能失败的 -p coder 重启。因为这次重启会让设备上所有 bot 重连,两个客户端都会先问一句:“Restart the shared gateway? All bots on this device reconnect: default, coder, research”(这份名单就是运行中 gateway 的 served_profiles),完成后报告 “Shared gateway restarted (3 bots)”。standalone 的 profile 仍然是普通的重启语义。接口层面,/api/status?profile=coder 会把同一份名单作为 gateway_shared_with 返回(standalone 时为 null)。
安装流程会跳过后台服务那一步。 hermes -p coder setup gateway、hermes -p coder setup、hermes -p coder gateway setup 和 hermes -p coder import 照常配置该 profile 的 bot,但会跳过“安装 gateway 后台服务”这一步,改为打印 “Profile ‘coder’ is already served by the default multiplexer”——而不是注册一个注定躺在那里不工作的 unit 或 plist。把 bot token 加上,运行中的 multiplexer 就会接上它。
绑定端口的平台会换到带前缀的地址上。 需要监听端口的平台,会挂在默认 gateway 的监听地址上、带 /p/<profile>/ 前缀,所以过去指向该 profile 自己端口的 webhook 地址,现在指向共享监听地址加这个前缀,形如 /p/<profile>/webhooks/...。启动 preflight 检查的也正是“有没有绑定端口的平台缺少 /p/<profile>/ 入站路径”这一条。
token 依然按 profile 各算各的,凭据绝不共享。 每个被服务的 profile 用它自己的 bot 凭据把平台拉起来,每一轮 turn 都解析被路由 profile 的配置、技能、记忆、SOUL 和 provider key。被服务的 profile 也永远不会继承启动方的凭据——不管开关开着还是关着:路由到别的 home 的子进程,在叠加自己的凭据范围之前,会先被清掉启动 profile 注入的那些 Tier-1/Tier-2 凭据;而且针对次级 profile 的一次“没有作用域的凭据读取”会直接抛错,而不是悄悄返回默认 profile 的值。所以每个 profile 请使用自己的 bot token——两个 profile 共用一个 token,正是 preflight 会拒绝的情况。
--force 仍然存在。 run、start、install 和 restart 都接受 --force,前提是你确实想为某个 profile 单独跑一个进程——在 multiplexer 运行期间不建议这么做。另外,standalone 时代那份跨 profile 的生命周期包装脚本在多路复用模式下不再使用,你只需要管理默认 gateway。
如何持久地退出(或强制开启)
开关设在默认 profile 上(multiplexer 归它管),然后重启它的 gateway:
hermes config set gateway.multiplex_profiles false
hermes gateway restart
等价地,写在默认 profile 的 ~/.hermes/config.yaml 里:
gateway:
  multiplex_profiles: false
(这个开关也接受写成顶层的 multiplex_profiles: true,方便起见。)
false 会永久保持每 profile 一个 gateway——磁盘上的 false 被当作一次有意的回滚,本文描述的所有行为随之失效。true 则是在启动 preflight 本来会收手的情况下强制多路复用,因为这是你做的决定。默认 gateway 进程环境里的 GATEWAY_MULTIPLEX_PROFILES 覆盖以上两者——在容器里你往往控制环境变量而不是配置文件,这时它最顺手。
还有一根针对无人值守路径的杠杆:hermes update 可以把整个 profile 队列自动收拢进默认 gateway,管这件事的键是 gateway.auto_multiplex_migration,hermes config set gateway.auto_multiplex_migration false 同样能让退出生效。这个自动收拢读的就是这个键(托管层写下的 false 优先于用户写的 true),并且在默认 gateway 是一个无法解析 User= 的 system unit 时会直接拒绝收拢。
排查清单与小结
hermes gateway status说某个次级还在跑自己的 gateway。 停掉并卸载它——活着的进程或已安装的 unit 正是守卫在等的条件——然后重跑hermes gateway migrate --multiplex。- 两个 profile 共用一份 bot 凭据。 给其中一个换一个独立 token;preflight 不会去抢另一个进程还握着的 token。
- 有绑定端口的平台没有
/p/<profile>/入站路径。 把它的 webhook 指到默认监听地址并带上该前缀,或者干脆保持 standalone。 - 在 s6 容器或 Windows Scheduled Tasks 上什么都不切换。 这类主机不是迁移能处理的,启动守卫不会替你收拢,请保持每 profile 一进程。
- 启动次级 profile 时拿到退出码 78。 这是约定,不是 bug:去管默认 gateway,用默认 profile 上的
hermes gateway restart;确实需要独立进程再用--force。 - 迁移在中途死掉了。 重跑
hermes gateway migrate --multiplex,它会从自己写下的 manifest 恢复;如果回滚没能完整完成,manifest 会保留并告诉你缺什么。
一句话总结:多路复用现在默认开启,但在一台还没准备好的机器上什么都不会变——未设置的开关每次启动都会被重新判定,判定结果会记录在案并显示在 hermes gateway status 里,而显式写下的 true / false 永远优先。如果你在一台机器上跑着好几个 bot,那么 hermes gateway status 现在就是告诉你身处哪个世界的那一条命令。完整的参数列表在 hermes gateway 命令参考里。