Multiplexação de perfis no gateway agora é o padrão
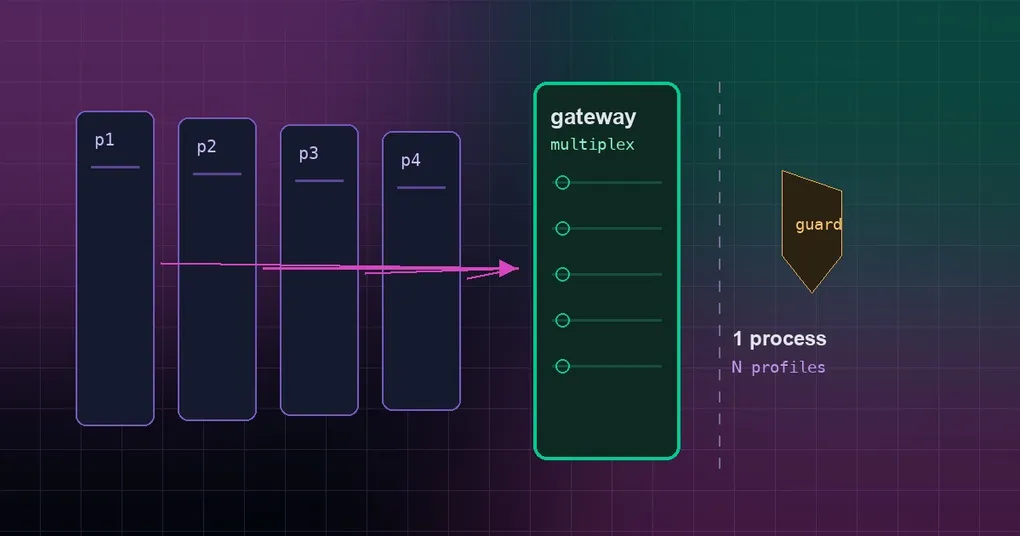
Segunda-feira de manhã e ninguém responde no grupo. Em uma única máquina você roda três perfis do Hermes — default, coder e research — e cada um tem sua própria unit do systemd, sua própria porta e o seu próprio hermes -p coder gateway start que você deveria lembrar de digitar. O reboot da noite passada trouxe só dois de volta, e o token do Telegram de um perfil acabou consultado por dois processos ao mesmo tempo, então cada mensagem foi respondida duas vezes. Você não mudou nada: só tem mais uma coisa para cuidar a cada bot que adiciona. O Hermes responde a isso com um único processo gateway que atende todos os perfis da máquina, e desde 2026-09-16 esse é o padrão — com uma guarda para que nenhuma instalação existente seja alterada de surpresa.
O que é um gateway com multiplexação
Três palavras primeiro. Um perfil (profile) é um agente Hermes autocontido: configuração, credenciais, memória, skills e tarefas cron próprias, tudo em ~/.hermes/profiles/<name>. O gateway é o processo de longa duração que mantém seus bots conectados: consulta o seu bot do Telegram, responde ao seu webhook, acorda as tarefas cron e entrega cada mensagem recebida a um turn do agente. Multiplexação (multiplexing) é deixar um único processo gateway atender mais de um perfil.
Até agora o formato padrão era um processo por perfil (o que a documentação chama de standalone, e o que o --standalone restaura): cada perfil tem sua unit, sua porta e seu arquivo PID. Um multiplexer troca essa frota por um único processo — o gateway do perfil default passa a ser o único processo de entrada e atende mensagens de todos os perfis da máquina, encaminhando cada mensagem ao perfil a que ela pertence. Os perfis continuam sendo agentes separados; o que se compartilha é apenas o processo.
O formato de um processo por perfil continua totalmente suportado, e o guia de perfis multi-instância mostra como manter vários perfis lado a lado.
O que mudou: ativado por padrão, mas decidido a cada inicialização
gateway.multiplex_profiles agora vem ativado. A parte que vale ler duas vezes é o que acontece quando você nunca definiu esse valor: um flag não definido é tratado como um pedido, não como um veredito, e o gateway padrão resolve esse pedido uma vez a cada inicialização.
Ao subir, ele executa o mesmo preflight do hermes gateway migrate --multiplex, e só multiplexa quando a reunião teria sido segura:
- o perfil default existe e há dois ou mais perfis na máquina;
- nenhum perfil secundário ainda roda o próprio gateway, nem como processo vivo, nem como serviço instalado;
- dois perfis não compartilham a mesma credencial de bot;
- nenhuma plataforma que ocupa uma porta ficou sem o seu ingress
/p/<profile>/; - a máquina é de um tipo que a migração entende: não um contêiner s6, não o Windows Scheduled Tasks.
Se qualquer um desses pontos falhar, o gateway sobe exatamente como sempre subiu, atendendo apenas o perfil default, e registra um WARNING que nomeia o bloqueio e entrega a linha hermes gateway migrate --multiplex. Nada é alterado em disco.
Um valor explícito nunca é questionado:
gateway.multiplex_profiles: true(o que a migração grava) multiplexa mesmo com o preflight contra — a decisão foi sua ou da migração;gateway.multiplex_profiles: false(o que o--standalonerestaura) mantém um gateway por perfil de forma definitiva; com ele desligado, tudo o que vem a seguir fica inerte;GATEWAY_MULTIPLEX_PROFILESno ambiente do processo tem prioridade sobre os dois.
O veredito fica registrado, não só no log: o gateway_state.json do home padrão guarda multiplex_standalone_reason, e o hermes gateway status imprime isso como ⚠ Serving the default profile only (gateway.multiplex_profiles unset): <reason>, junto com as duas saídas possíveis. Uma inicialização que de fato multiplexa limpa esse registro.
Os outros processos também deixaram de adivinhar o veredito a partir do valor padrão mesclado: o hermes -p coder setup, o dashboard, a resolução de porta no disparo do cron e o hermes gateway migrate leem primeiro o registro served_profiles do gateway em execução, e só recorrem ao flag explícito quando não há gateway rodando.
Como descobrir em qual modo você está
Um comando responde:
hermes gateway status- Se aparecer uma linha começando com
Serving the default profile only, você está em modo standalone, e o texto depois dos dois-pontos é o motivo pelo qual a guarda de inicialização se conteve. - Se essa linha não existir, o gateway está rodando como multiplexer. O registro dele —
served_profilesdentro dogateway_state.jsondo home padrão — lista cada perfil atendido, e é esse registro que as outras ferramentas leem.
No dashboard, a mesma informação está na página System, e na API o /api/status?profile=coder a entrega como gateway_shared_with (null quando aquele perfil tem gateway próprio).
Dá para testar na prática também: tente iniciar o gateway de um perfil secundário. No modo multiplexer a CLI recusa; no modo standalone ele sobe.
Um gateway ou um processo por perfil?
A multiplexação compensa quando:
- você faz deploy em contêiner ou VPS, onde N units do supervisor, N portas e N arquivos PID pesam;
- você tem muitos perfis de baixo tráfego que não justificam cada um um processo inteiro;
- você quer uma única coisa para iniciar, monitorar e reiniciar.
Adicionar um perfil passa a custar um token de bot — o gateway em execução já o incorpora — em vez de mais um serviço para cuidar. Nosso guia sobre atender perfis em um gateway em execução cobre esse caminho a quente.
Fique com um processo por perfil quando precisar de isolamento duro em nível de processo entre os perfis: pegadas de memória separadas, domínios de falha independentes e a possibilidade de reiniciar um perfil sem tocar nos outros. Quando uma skill descontrolada em um perfil pode derrubar o processo inteiro junto, isso pesa mais do que economizar algumas units.
Reunir a frota de propósito
Em vez de reiniciar o gateway padrão e torcer para a guarda concordar, rode a migração:
hermes gateway migrate --multiplexNa ordem: ela grava gateway.multiplex_profiles: true no perfil default, para e desinstala cada unit instalada de cada secundário, sobe o gateway padrão como multiplexer e confirma, a partir do registro served_profiles ao vivo desse gateway, que cada perfil migrado está realmente sendo atendido.
A migração é transacional. O flag vai primeiro, então uma interrupção em qualquer ponto posterior é retomável: rodar o comando de novo lê o manifest que a migração gravou e continua a partir do estado ao vivo — o served_profiles do gateway padrão ao vivo precisa cobrir cada perfil migrado no manifest antes que ela se considere concluída. Se um passo posterior falhar (parar um secundário, um daemon-reload depois de remover uma unit, gravar a configuração), os secundários já removidos voltam e o flag é restaurado. Um rollback que não consegue terminar mantém o manifest e avisa, para você concluir na mão.
Ela também recusa cedo, antes de parar qualquer gateway em funcionamento, quando o plano já mostra que a reunião não vai funcionar: uma frota de units de sistema rodadas como root sem User= registrado para reproduzir, um usuário registrado que o sistema não resolve, ou um config.yaml sem permissão de escrita. O User= de uma unit de sistema é preservado: a migração o lê antes de remover qualquer coisa e o leva para a subida do gateway padrão e para o rollback.
Se você está começando do zero em vez de migrar, é mais simples: instale o Hermes, deixe o gateway padrão subir e o preflight de inicialização faz o resto.
O que se comporta diferente quando está ativado
O multiplexer é o único processo de entrada, então um segundo gateway para o mesmo perfil duplicaria o bind das plataformas daquele perfil. Tudo o que segue é automático e fica inerte no momento em que o flag está em false.
Um perfil secundário não pode iniciar o próprio gateway. hermes -p coder gateway run, start, install e restart são erro duro com código de saída 78, apontando de volta para o multiplexer: “The default gateway is running as a profile multiplexer and already serves profile ‘coder’.” A recusa acontece na CLI, antes de qualquer gerenciador de serviços ser tocado, então um perfil atendido nunca acaba com uma unit do systemd permanentemente falha nem com um loop de respawn do launchd. O hermes -p coder gateway stop recusa do mesmo jeito (saída 78) quando o coder não tem gateway próprio — não há nada a parar além do multiplexer, e o hermes gateway stop no perfil default derruba ele para todos os perfis atendidos.
O dashboard e o Desktop seguem a CLI. Para um perfil atendido, Start e Stop respondem 409 com a mesma explicação, mostrada como aviso embutido na página System, e o Restart reinicia o multiplexer — o processo que de fato atende o perfil — em vez de disparar um -p coder restart que só poderia falhar. Como esse reinício reconecta todos os bots do dispositivo, os dois apps perguntam antes: “Restart the shared gateway? All bots on this device reconnect: default, coder, research” — a lista é o served_profiles do gateway em execução — e depois informam “Shared gateway restarted (3 bots)”. Um perfil standalone mantém o reinício comum. Na API, o /api/status?profile=coder devolve essa mesma lista como gateway_shared_with (null para um gateway standalone).
O setup pula o serviço em segundo plano. hermes -p coder setup gateway, hermes -p coder setup, hermes -p coder gateway setup e hermes -p coder import continuam configurando os bots daquele perfil, mas pulam o passo “instalar o serviço de gateway em segundo plano” para um perfil atendido e imprimem “Profile ‘coder’ is already served by the default multiplexer” em vez de registrar uma unit ou um plist que só ficaria parado. Adicione o token do bot e o multiplexer em execução já o incorpora.
Plataformas que ocupam porta passam para um prefixo de URL. Uma plataforma que escuta em uma porta é atendida no listener do gateway padrão sob /p/<profile>/, então um webhook que antes apontava para a porta própria daquele perfil agora aponta para o listener compartilhado mais esse prefixo, em um formato como /p/<profile>/webhooks/.... É exatamente isso que o preflight de inicialização verifica: “nenhuma plataforma que ocupa porta sem o seu ingress /p/<profile>/”.
Tokens continuam por perfil e as credenciais nunca são compartilhadas. Cada perfil atendido sobe suas plataformas com as próprias credenciais de bot, e cada turn resolve a configuração, as skills, a memória, o SOUL e as chaves de provider do perfil roteado. Um perfil atendido também nunca herda as credenciais do perfil de lançamento, com o flag ligado ou desligado: um processo filho roteado para outro home tem as credenciais Tier-1/Tier-2 do perfil de lançamento removidas antes que o próprio escopo seja sobreposto, e uma leitura de credencial sem escopo para um secundário levanta erro em vez de devolver em silêncio o valor do perfil padrão. Dê a cada perfil o seu próprio token de bot — dois perfis compartilhando um é justamente o que o preflight recusa.
--force continua existindo. run, start, install e restart aceitam --force se você quiser de propósito um processo separado para um perfil, o que não é recomendado enquanto o multiplexer está rodando. E o script de ciclo de vida entre perfis das instalações standalone não é usado no modo multiplexer: você administra apenas o gateway padrão.
Desativar de forma duradoura ou forçar
Configure o flag no perfil default — é ele que possui o multiplexer — e reinicie o gateway dele:
hermes config set gateway.multiplex_profiles false
hermes gateway restart
Equivalentemente, no ~/.hermes/config.yaml do perfil default:
gateway:
  multiplex_profiles: false
(O flag também é aceito no nível de cima como multiplex_profiles: true, por conveniência.)
false mantém um gateway por perfil de forma definitiva: um false em disco é respeitado como rollback deliberado, e todos os comportamentos descritos acima ficam inertes. true força a multiplexação mesmo onde o preflight se conteria, porque a decisão é sua. GATEWAY_MULTIPLEX_PROFILES no ambiente do gateway padrão tem prioridade sobre os dois — a alavanca prática em um contêiner, onde você controla o ambiente e não o arquivo.
Há mais uma alavanca no caminho não assistido: o hermes update consegue reunir a frota no gateway padrão por conta própria, e a chave que governa isso é gateway.auto_multiplex_migration; hermes config set gateway.auto_multiplex_migration false deixa essa recusa explícita. Um false do escopo gerenciado vence um true do usuário, e o update se recusa a reunir uma frota em uma unit de sistema padrão cujo User= ele não consegue resolver.
Diagnóstico e resumo
- O
hermes gateway statusdiz que um secundário ainda roda o próprio gateway. Pare e desinstale — um PID vivo ou uma unit instalada é o que a guarda espera — e rodehermes gateway migrate --multiplexde novo. - Dois perfis compartilham uma credencial de bot. Dê a um deles o próprio token; o preflight não vai tomar tokens que outro processo ainda segura.
- Uma plataforma que ocupa porta está sem o ingress
/p/<profile>/. Aponte o webhook dela para o listener padrão com esse prefixo, ou fique em standalone. - Nada é reunido em um contêiner s6 ou no Windows Scheduled Tasks. Essa máquina não é de um tipo que a migração entende, então a guarda de inicialização não pode fazer isso por você; mantenha um gateway por perfil ali.
- Você recebeu o código de saída 78 ao iniciar um secundário. Isso é o contrato, não um bug: administre o gateway padrão com
hermes gateway restarte só recorra ao--forcese quiser mesmo um processo separado. - Uma migração morreu no meio. Rode
hermes gateway migrate --multiplexde novo; ela retoma a partir do manifest que gravou, e um rollback incompleto mantém o manifest e diz o que falta.
A versão curta: a multiplexação está ativada por padrão, mas em uma máquina que não está pronta nada muda — um flag não definido é decidido a cada inicialização, o veredito é registrado e aparece no hermes gateway status, e um true ou false explícito sempre vence. Se você roda vários bots em uma mesma máquina, o hermes gateway status é agora o comando que diz em qual mundo você está. A lista completa de flags está na referência do comando hermes gateway.