Por qué reiniciar tu gateway te hace pagar dos veces la misma cache
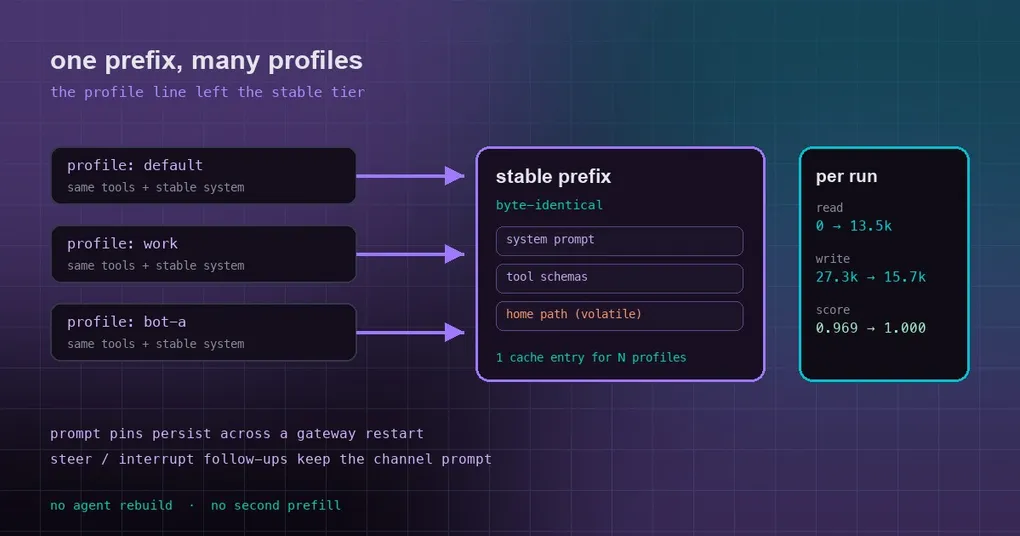
Un gateway, tres profiles: el tuyo, uno para un flujo de trabajo de equipo y un bot en un grupo de chat. Preguntas algo al bot en el grupo, abres tu propia sesión un segundo después y preguntas lo mismo, y ambas se facturan como primeros contactos. Las líneas de cache write en la factura parecen normales, y aun así el primer mensaje después de cada reinicio del gateway es lento de una forma que sugiere que el modelo nunca ha visto tu system prompt.
La regla es simple: el provider solo reutiliza un prefijo idéntico byte a byte. Cambia un solo carácter y todo lo que viene detrás se recalcula. Hermes ya divide su system prompt en niveles stable, context y volatile justo por esto. Tres correcciones fusionadas el 2026-09-28 perseguían un mismo modo de fallo: algo se había colado en el nivel stable que no debía estar ahí, o algo que debería haberse heredado no se heredaba.
1. Una línea del nivel stable que difería en cada profile
En agent/system_prompt.py el system prompt se compone de bloques stable, context y volatile. Los esquemas de tools y el system prompt estable viven en stable: esos bytes tienen que seguir idénticos pase lo que pase, o no se puede reutilizar nada del historial de conversación que va detrás.
El problema era la línea Active Hermes profile: .... Su única función es decirle al modelo qué directorios lee y escribe, así que su texto contiene la home path del profile. Estaba en el nivel stable, lo que significaba que cada profile distinto, cada máquina distinta y cada sesión con una home distinta producían un prefijo estable distinto. Un gateway multiplexado que servía N profiles pagaba N escrituras de cache en lugar de compartir una sola entrada.
Esa línea ahora viaja en el nivel volatile, después del resto del contenido volatile. El resultado es un prefijo stable idéntico byte a byte entre profiles y homes. El nuevo test del repositorio lo dice sin rodeos: test_stable_tier_is_identical_across_homes.
El cambio en producción son cinco líneas añadidas y dos eliminadas. El benchmark que se publicó con el mismo PR muestra cuánto vale eso: 16 tareas (9 estándar, 7 difíciles), 2 modelos × 2 repeticiones, cada petición enrutada por el mismo endpoint de inferencia y un grader oculto determinista por tarea.
| Configuration (n=32 each) | Score | Tokens/run | $/run | Requests/run |
|---|---|---|---|---|
| reference CLI agent A, opus-5.5 | 1.000 | 146k | 0.158 | 5.4 |
| Hermes before, opus-5.5 | 0.969 | 155k | 0.245 | 6.8 |
| Hermes after, opus-5.5 | 1.000 | 152k | 0.173 | 6.1 |
| reference CLI agent B, gpt-5.6-terra | 0.995 | 145k | 0.123 | 9.4 |
| Hermes before, gpt-5.6-terra | 0.968 | 121k | 0.110 | 7.5 |
| Hermes after, gpt-5.6-terra | 1.000 | 115k | 0.108 | 7.1 |
Solo por el lado de la cache: antes, la primera petición de una ejecución con Opus leía 0 tokens cacheados y escribía unos 20k. Ahora lee 13.5k, y las escrituras de cache por ejecución bajan de 27.3k a 15.7k.
Una advertencia honesta para que no te hagas expectativas de más: una instalación de un solo profile con una home fija ya reutilizaba este prefijo entre sesiones, así que ahí no lo vas a notar. La ganancia está en hosts multi-profile y multiplexados, y en benchmarks como el de arriba, donde cada ejecución parte de una home nueva.
2. Después de un reinicio, el primer evento interno hacía cambiar el prompt A → B → A
La segunda corrección va sobre el primer aliento tras un reinicio.
Lo primero que llega después de reiniciar el gateway normalmente no es un mensaje humano, sino un evento interno: un kanban wake, una delegación que termina, una reanudación al arrancar. Esos turnos antes renderizaban un system prompt y luego el siguiente turno humano volvía a renderizar el original: A → B → A. El coste era un fallo de cache de prompt más una reconstrucción del agente y un re-prefill completo de la conversación.
Los turnos internos ahora reutilizan los bytes del system prompt del último turno humano. Mecánicamente es una instantánea fijada (pin snapshot):
- la entrada de enrutado (state.db
gateway_routingmás un espejo ensessions.json) la guarda; - se escribe antes de que el agente se ejecute en cada turno humano y se relee en el primer turno interno tras un reinicio;
- las lecturas y escrituras están acotadas por el id de sesión;
/resumey el traspaso desde el CLI limpian el pin: una sesión cambiada no debe heredar bytes antiguos.
Hay un detalle de privacidad que merece mención aparte: el pin registra bajo qué política privacy.redact_pii fue renderizado y los bytes renderizados bajo una política distinta nunca se reutilizan. De lo contrario, un solo reinicio podría enviar en forma no redactada contenido que debería haberse redactado. Eso cubre los eventos internos después de un reinicio y, como el mismo bypass también existía ahí, los eventos internos dentro de un mismo proceso.
3. La media frase que deja un /steer tiraba el channel prompt
La tercera ocurre después de corregir una ejecución con /steer o de interrumpir una generación.
El texto que añadiste —o la interrupción misma— suele convertirse en el siguiente turno. Ese turno antes empezaba con channel_prompt = None, lo que eliminaba del system prompt la línea de identidad del grupo de Telegram, tus channel_prompts de YAML y la identidad de Slack. El prompt cambiaba, así que el agente cacheado se reconstruía y toda la conversación se re-prefillaba. Después tu siguiente mensaje humano lo devolvía a su sitio y pagabas dos veces lo mismo.
La corrección efectiva es una única asignación: cuando no hay ningún evento pendiente, el follow-up hereda el channel prompt del turno al que sigue (_run_agent_queued_followup en gateway/run_turn.py). Los follow-ups respaldados por eventos no se tocan: siguen resolviendo su propio prompt.
Qué significa esto para ti
- Hosts multi-profile: N profiles ahora comparten una sola entrada de cache de prefijo estable en lugar de escribir N. No hay nada que configurar; actualiza y lo tienes.
- El primer mensaje tras un reinicio: ya no es un arranque en frío. Da en la cache en la que debería dar.
- Tras una interrupción en un grupo de chat: se acabó el «arreglé una frase y recalculé toda la conversación» en la factura.
Para ver tú mismo los niveles y sus tamaños, ejecuta hermes prompt-size: imprime un desglose en bytes del system prompt más los esquemas de tools. La configuración multi-profile en sí está cubierta en nuestra guía de multiplexado y profiles; si estás ajustando el enrutado, la guía del carril de modelos auxiliares explica qué llamadas escriben entradas de cache propias. Las tres correcciones necesitan el código nuevo, así que ejecuta hermes update (la guía paso a paso de actualización). Y ya que es la misma semana: así evita MoA romper esta cache, la guía de Mixture of Agents.