磁盘一卡,整个助手都停摆:Hermes 把三件「不该挡在门口的事」挪到了后台
凌晨两点,你在 NAS 上跑着 Hermes 的 gateway,同时系统正在做备份。你在手机上给它发了一句「在吗」,然后看着对话框 —— 转圈,转圈,半天不回。你以为是模型慢,其实是磁盘慢:这台机器上每一次会话的状态写入,都要等磁盘把上一个块写完。同一件事也发生在你的笔记本上:桌面版挂着没关,风扇却一直转,Activity Monitor 里一个 CPU 核被吃满 —— 那是后台每秒钟两次的空转探针。
这类卡顿的共同点是:该在后台慢慢做的事,被放在了门口的必经之路上。 9 月 18 日到 20 日合并的一组改动(#117206、#117063、#117066、#117201、#117041、#116967)分别处理了这几条路,思路完全一致:读路径只读本地、写路径交给后台线程、轮询按节拍而不是按循环。
一次状态写入,冻结了所有进站消息
write_runtime_status() 负责把网关的运行状态写进 gateway/runtime_status.json。它做的是「读文件 → 合并 → 写回」三步,听起来很轻,但它是同步跑在事件循环上的,而且每轮对话要写两次,平台适配器每切换一次状态也要写。
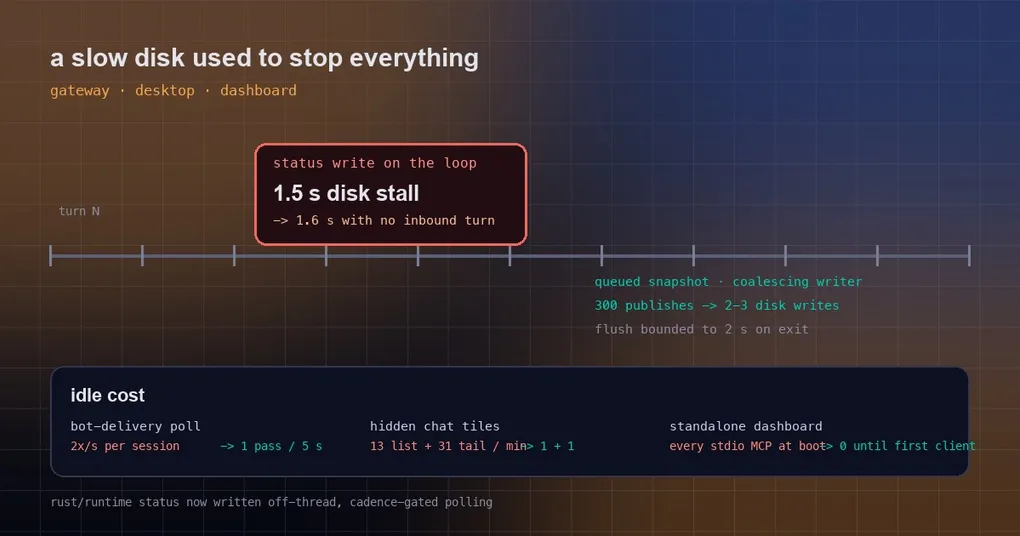
在慢盘或被占用的盘上,这三步会把整个循环按在地上。PR #117206 里的探针数字很直接:磁盘停顿 1.5 秒,事件循环就停顿 1.6 秒 —— 这 1.6 秒里所有进站消息(手机上那条「在吗」)都在排队等着处理。
改法是把「写」这件事整个拆出来:
- 状态更新先发到内存快照(
publish_runtime_status()),不碰磁盘,不会阻塞; - 一个合并写入线程(
_RuntimeStatusWriter)独占文件,把一批更新压成少量写入 —— 实测 300 次 publish 只产生 2 到 3 次磁盘写; - 需要一个确定落盘的调用点(比如启动、退出)用有上限的等待(
wait_timeout),退出时的落盘预算上限 2 秒。
有个行为细节值得知道:写入线程每次落盘前会重新读一遍文件再叠加自己的快照,所以别的进程写的字段不会被覆盖(比如 hermes gateway migrate --standalone 或容器启动时写入的 desired_state)。代价是:如果退出时磁盘彻底卡死,那个「已停止」的时间戳可能停留在旧值,而不是让退出流程一直挂着。
桌面版空转:每秒两次的探针,和隐藏标签页的轮询
hermes serve(桌面版/TUI 的后端)里有一个机器人投递轮询。它的循环里唯一的阻塞点是 completion_queue.get(timeout=0.5) —— 也就是说,每一轮循环都会跑一次投递探测,每秒两次、每个会话两次。而每次探测都会遍历 active_sessions.json 里的租约,逐个调 psutil 判断进程是否活着。
成本是「会话数 × 租约数 × 每秒两次」。报告者的实测是:11 个会话、8 个租约,每个轮次 88 次探针,吃掉 102% 的一个 CPU 核。
PR #117063 做了两件事:把投递轮询挂到和 /loop、/heartbeat、看板轮询一样的 5 秒节拍上;以及当租约属于当前进程自己时直接短路,不再对自己做 psutil 探测。探针从「5 秒 10 次」降到「5 秒 1 次」,自持租约的 psutil 调用从约 80 次降到 0 次。短路的实现还特意保留了 (pid, 进程启动时间) 的比对 —— 否则一个被系统回收后恰好等于自己 PID 的进程,可能让一条过期租约永远活着。
同一批里还有一处:被切到后台但保持存活的聊天面板(keep-alive tile)以前照旧轮询 subagent.list(每 5 秒)和 subagent.tail(活跃子代理每 2 秒)。它们的判断条件是 document.visibilityState,而整个窗口是可见的,只是标签被 visibility: hidden 藏起来了 —— 所以判断永远为真。PR #117066 让两个轮询都读面板可见性上下文,隐藏时不再武装定时器,重新显示时再恢复。换算到 60 秒/每个隐藏面板:从「13 次 list + 31 次 tail」降到「1 + 1」。
dashboard:没人打开时不再拉起所有 MCP,大数据库不再冻住界面
另外两处卡顿发生在 hermes dashboard 上。
启动即预热。 以前一个独立的 hermes dashboard 会在启动时立刻做后台 MCP 发现 —— 把配置里每一个 stdio MCP 服务器都拉起来,哪怕你从来没打开过界面。报告者顺着 mcp-stderr.log 的写入抖动找到了它(在 NAS/ZFS 上尤其明显)。PR #117201 把发现改成「先武装、等第一个客户端」:第一个 /api/ws 连接进来时才真正启动,或者在首次构建 agent 时提前触发。桌面版非 headless 仍然保持启动即预热,行为不变。
大 state.db 冻住所有请求。 GET /api/sessions/search、/api/sessions/stats 和 /api/sessions/{id} 这三个路由是在 async def 里直接开 SQLite 的。会话库到几百 MB 时,FTS5 查询会让整个事件循环停顿数秒 —— 表现就是侧边栏卡死、WebSocket 唤醒超时。PR #117041 把这三个路由的数据库工作挪进 asyncio.to_thread,和模块里其它同类路由保持一致。探针结果:三个路由在事件循环线程上的 SQLite 打开次数从 3/4 变成 0/4。
如果你的会话库已经很大,除了等这个改动,也可以先做一次离线整理:hermes sessions optimize-storage(需要所有持有者进程停下),它重建 FTS 索引 —— 这部分由更早的 #65798 提供,不属于本次改动。
锁被谁拿着?现在日志会说出进程名
上面说的都是「等一等就好」,但有一类等待是有害的:写锁被别人拿着。Hermes 的每一个进程都会打开 state.db,所以扫描「谁打开了这个文件」根本区分不出唯一那个写者 —— 超时日志只能说出受害者自己(database is locked (another Hermes process held the state.db write lock for over 60s)),你不知道该去关谁。
PR #116967 让超时日志在抛错前先读 /proc/locks,只保留写类型的锁,把 SQLite 的字节偏移解码成具体语义(-shm 的 120 是 WAL 写、121 是 checkpoint、122 是 recover、123-127 是读槽;主文件上的 pending 字节是 PENDING/RESERVED/SHARED),再把持有者归到某个 PID 上。新的日志长这样:
WARNING hermes_state_lockowners: state.db write lock unavailable for 60s (state.db):
PID 594094 (hermes --worktree --yolo) holds WAL write lock on state.db-shm两点限制要知道:这个能力目前只支持 Linux(/proc/locks 是 Linux 特有的),非 Linux 返回空;OFD 锁不会导出 PID,日志会如实标注。持有者的命令行只进日志、不进异常文本 —— 因为异常分类是按文案分桶的,一个叫 fix-corrupt-db 的 worktree 名字会把分类带偏。
如果你的 state.db 经常被人抢锁,可以配合看 state.db 损坏自愈 和 WAL 写入守卫 两篇,那里讲了锁等待的时间预算和修复流程。
更新也少做了一次无用功
顺手一提,同一批里还有一个很实在的改动:hermes update 以前只要 web UI 或桌面版源码有变动,就会重新跑 npm ci,把 node_modules 整个解压两遍。PR #117110 让这两次安装也走和第一次一样的清单摘要判断:摘要没变、Electron 还在,就跳过。报告者在 Windows 上测到的场景是「三次 npm 安装、117 秒」,改动后其中两次直接跳过。
这些改动现在能用了吗
要诚实说明:上面这些合并时间都在 2026 年 9 月 18 日至 20 日,而当前最新发版是 v0.21.3(标签 v2026.9.14)。也就是说它们在 main 上,还没进任何正式版本 —— 你用 hermes update 拿到的还是旧行为。想提前体验有两条路:等下一个版本发布后升级,或者自己从 main 构建。想知道自己现在有没有踩到这些慢路径,可以:
hermes --version                          # 确认你在哪个版本
hermes sessions optimize-storage          # 大 state.db 的离线整理(需先停掉持有者)
小结
把这六个改动放在一起看,它们修的是同一种病:关键路径上出现了 I/O。 状态写入、进程探针、启动预热、SQLite 查询、npm 安装 —— 每一个单独看都不起眼,但只要它挡在「处理下一条消息」的路上,用户感受到的就是「Hermes 卡了」。判断一个后台任务该不该留在主循环里,可以问三个问题:它需要网络或磁盘吗?它有别人没必要的等待吗?它是不是可以按节拍做?三个问题里只要有一个答「是」,它就属于后台。
如果你更关心的是「打开列表时的卡顿」而不是「处理消息时的卡顿」,可以接着看 读路径上的缓存那篇;桌面版里子代理的实时编排可以看子代理实时控制。