Un disco lento, un asistente congelado: Hermes movió al segundo plano tres trabajos que bloqueaban la puerta
Son las dos de la mañana, tu gateway de Hermes corre en el NAS y el backup acaba de empezar. Le preguntas «¿estás ahí?» desde el móvil y te quedas mirando el indicador de carga. Nada. Das por sentado que el modelo va lento, pero la máquina está ocupada escribiendo en disco, y cada actualización de estado de sesión en ese equipo tiene que esperar detrás del bloque anterior. Lo mismo ocurre en el portátil: la app de escritorio sigue abierta, los ventiladores están en marcha y hay un núcleo de CPU al 100 % en el Monitor de Actividad. Eso es un sondeo en reposo que consulta dos veces por segundo.
Los dos bloqueos comparten una única causa: había trabajo que pertenece al segundo plano ocupando la puerta. Un lote de cambios fusionados entre el 18 y el 20 de septiembre (#117206, #117063, #117066, #117201, #117041, #116967) se ocupa de esas puertas, y la solución es siempre la misma: las rutas de lectura se quedan en local, las escrituras se mudan a un hilo en segundo plano y los sondeos pasan a correr con una cadencia en lugar de en cada iteración del bucle.
Una sola escritura de estado congelaba todos los mensajes entrantes
write_runtime_status() escribe el estado en tiempo de ejecución del gateway en gateway/runtime_status.json con un read-merge-write. Suena barato, pero se ejecutaba de forma síncrona en el bucle de eventos, dos veces por turno más una en cada transición de estado de un adaptador.
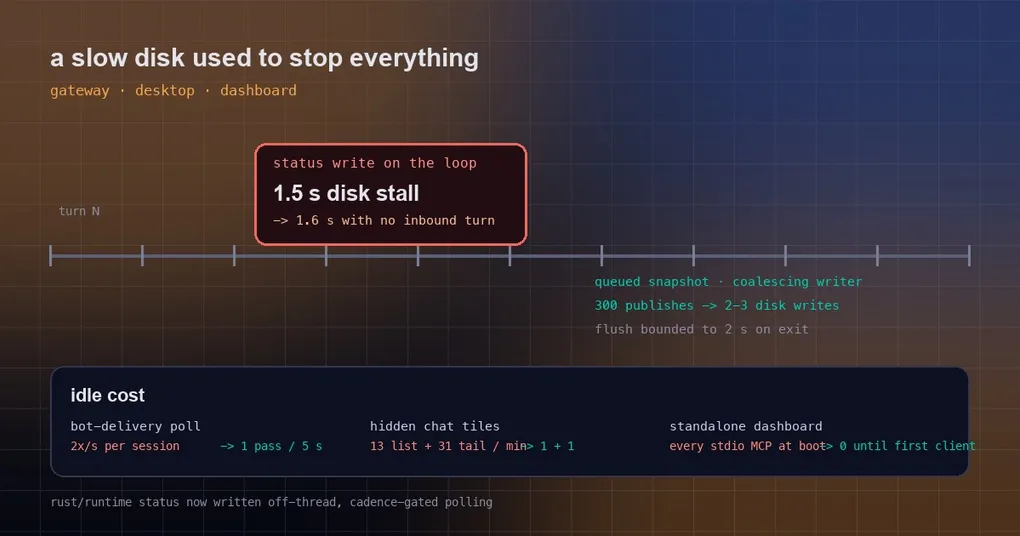
En un disco lento o disputado, esos tres pasos bloquean el bucle entero. El sondeo del PR #117206 es contundente: 1,5 s de bloqueo de disco produjeron 1,6 s de bloqueo del bucle, y durante esos 1,6 segundos cada mensaje entrante — incluido ese «¿estás ahí?» del móvil — se queda esperando en una cola.
La solución extrae la escritura por completo:
- las actualizaciones de estado publican en una instantánea en memoria (
publish_runtime_status()) y nunca tocan el disco en la ruta caliente; - un hilo escritor que agrupa actualizaciones (
_RuntimeStatusWriter) es el dueño del archivo y funde una ráfaga de actualizaciones en unas pocas escrituras: se midió 300 publicaciones reducidas a 2-3 escrituras en disco; - los puntos de llamada que de verdad necesitan los bytes en disco (arranque, apagado) usan una espera acotada (
wait_timeout), y el sello final al salir recibe un presupuesto de 2 s en lugar de bloquearse para siempre.
Hay un comportamiento que conviene conocer: el escritor vuelve a leer el archivo justo antes de cada escritura y superpone su instantánea sobre el resultado, así que los campos escritos por otros procesos no se pisan (piensa en hermes gateway migrate --standalone, o en un contenedor que siembra desired_state durante el arranque). El precio es la otra cara de una espera acotada: si el disco se atasca al salir, el sello de «detenido» puede quedar obsoleto en el siguiente arranque en lugar de dejar colgada la salida.
La app de escritorio: dos sondeos por segundo y pestañas ocultas que seguían consultando
hermes serve (el backend que hay detrás de la app de escritorio y de la TUI) ejecuta un sondeo de entrega de bots. Su único punto bloqueante es completion_queue.get(timeout=0.5), lo que significa que cada iteración del bucle lanzaba un sondeo de entrega: dos veces por segundo, por sesión. Cada sondeo recorría todos los leases de active_sessions.json y llamaba a psutil para comprobar si el proceso seguía vivo.
El coste es sesiones × leases × 2/s. Los números de quien lo reportó: 11 sesiones, 8 leases, 88 sondeos por ronda al 102 % de un núcleo de CPU.
El PR #117063 pone el sondeo de entrega en la misma cadencia de 5 s que los sondeos de /loop, /heartbeat y kanban, y hace un cortocircuito total cuando un lease pertenece al proceso actual: sin sondeo psutil sobre ti mismo. Los sondeos pasaron de 10 cada 5 s a 1, y las llamadas a psutil para leases propios bajaron de unas 80 a cero. El cortocircuito mantiene a propósito la comparación de identidad (pid, process start time): de lo contrario, un PID reciclado que casualmente coincidiera con el tuyo podría mantener vivo un lease obsoleto para siempre.
Mismo lote, misma familia: las pestañas de chat ocultas de keep-alive seguían consultando subagent.list cada 5 s y subagent.tail cada 2 s por cada subagente activo. Su única protección era document.visibilityState, y la ventana entera sí es visible: las pestañas se ocultan con visibility: hidden y el layout se conserva. Así que la guarda siempre daba verdadero. El PR #117066 condiciona ambos pollers al contexto de visibilidad del panel y los vuelve a armar al mostrarse. Por cada pestaña oculta y por minuto, eso es pasar de «13 llamadas de list + 31 de tail» a «1 + 1».
hermes dashboard: ni tormenta de spawns MCP al arrancar, ni interfaz congelada con una base de datos grande
Dos bloqueos más viven en hermes dashboard.
Warm-up al arrancar. Un hermes dashboard en modo standalone lanzaba el descubrimiento de MCP en segundo plano de inmediato, arrancando cada servidor MCP stdio configurado aunque nadie llegara a abrir la interfaz. Quien lo reportó lo rastreó hasta el churn de escritura de mcp-stderr.log, que se nota especialmente mal en almacenamiento NAS/ZFS. El PR #117201 arma el descubrimiento y lo dispara con el primer cliente /api/ws (o lo adelanta en la primera construcción de agente). Un dashboard lanzado por Desktop conserva su arranque inmediato, así que ahí no cambia nada.
Un state.db grande que lo bloquea todo. GET /api/sessions/search, /api/sessions/stats y /api/sessions/{id} abrían SQLite directamente dentro de handlers async def. Cuando la base de datos de sesiones llega a unos cientos de megabytes, la consulta FTS5 bloquea el bucle de eventos durante segundos; el síntoma es una barra lateral congelada y timeouts al despertar el WebSocket. El PR #117041 encamina el trabajo de base de datos de esos tres handlers por asyncio.to_thread, igual que los handlers hermanos del mismo módulo. Antes y después: las aperturas de SQLite en el hilo del bucle en las tres rutas pasaron de 3 de 4 a 0 de 4.
Si tu base de datos de sesiones ya es grande, hay una pasada offline que puedes ejecutar hoy mismo: hermes sessions optimize-storage (con todos los procesos que la retienen detenidos) reconstruye el índice FTS. Ese camino viene del #65798 anterior, no de este lote.
«Database is locked»: ahora el log nombra al proceso que lo retiene
Hay esperas benignas. Un lock de escritura retenido por otro no lo es. Todos los procesos de Hermes tienen state.db abierto, así que escanear descriptores abiertos no permite distinguir al único escritor de los lectores; el mensaje del timeout de 60 segundos solo podía nombrar a la víctima (database is locked (another Hermes process held the state.db write lock for over 60s)), y no tenías ni idea de a qué proceso había que matar.
El PR #116967 lee /proc/locks en busca de la base de datos y de sus inodos -wal y -shm justo antes de lanzar el error, conserva los locks de clase escritura, descodifica los offsets en bytes de SQLite (en -shm, 120 es una escritura WAL, 121 un checkpoint, 122 un recover y 123-127 slots de lectura; un byte pendiente en el archivo principal significa PENDING/RESERVED/SHARED) y atribuye el titular a un PID. La nueva línea de log:
WARNING hermes_state_lockowners: state.db write lock unavailable for 60s (state.db):
PID 594094 (hermes --worktree --yolo) holds WAL write lock on state.db-shm
Dos límites que conviene tener presentes: esto es solo para Linux (lee /proc/locks), y los locks OFD no exportan un PID, así que el log lo dice en lugar de adivinar. La línea de comandos del titular va al log, no al texto de la excepción: los errores se agrupan por frase, y un worktree llamado fix-corrupt-db cambiaría de grupo.
Si te topas con contención de locks a menudo, los artículos sobre la autocuración de la corrupción de state.db y la protección de escritura WAL cubren los presupuestos de reintento y el flujo de reparación.
Las actualizaciones dejaron de hacer una pasada inútil
Otra del mismo lote, porque se nota mucho: hermes update volvía a ejecutar npm ci cada vez que cambiaban las fuentes de la web-ui o del escritorio, extrayendo node_modules dos veces. El PR #117110 condiciona esas dos instalaciones al mismo digest de manifiestos que ya condicionaba la primera pasada (más una comprobación de presencia de Electron para la pasada de escritorio). El escenario de quien lo reportó — tres pasadas de npm, 117 segundos — ahora se salta dos de ellas cuando el lockfile no ha cambiado.
¿Hay algo de esto disponible ya?
Con sinceridad: no. Todos los cambios de arriba se fusionaron entre el 18 y el 20 de septiembre de 2026, y la release más reciente es la v0.21.3 (tag v2026.9.14). Están en main y no están en ninguna release, así que hermes update te sigue dando el comportamiento antiguo. Puedes esperar a la próxima release o compilar desde main tú mismo. Para ver en qué ruta de código estás hoy:
hermes --version                          # qué release estás ejecutando
hermes sessions optimize-storage          # reconstrucción FTS offline para un state.db grande
El patrón
Lee los seis cambios juntos y verás que tratan una sola enfermedad: I/O en la ruta crítica. Una escritura de estado, un sondeo de proceso, un warm-up de arranque, una consulta a SQLite, una instalación de npm: cada una parece inofensiva por separado, pero cualquier cosa que se interponga entre Hermes y «atiende el siguiente mensaje» el usuario la lee como «Hermes va lento». Una prueba rápida para cualquier tarea de fondo que estés a punto de dejar en el bucle principal: ¿necesita red o disco? ¿espera a algo que no hace falta? ¿podría correr con una cadencia? Un solo «sí» y su sitio está en segundo plano.
Si lo que te molesta es el bloqueo del lado de lectura — un selector que gira, una lista que se cuelga — esa historia está en el artículo sobre la caché de la ruta de lectura; para la vista en vivo del escritorio de los hijos en ejecución, mira dirigir subagentes en vuelo.