Un disque lent, un assistant figé : Hermes a déplacé à l'arrière-plan trois tâches qui bouchaient l'entrée
Il est 2 h du matin, votre gateway Hermes tourne sur le NAS et la sauvegarde vient de démarrer. Vous lui envoyez « t’es là ? » depuis votre téléphone et vous fixez le spinner. Rien. Vous supposez que le modèle est lent — mais la machine est occupée à écrire sur le disque, et chaque mise à jour de statut de session sur cette machine doit attendre le bloc précédent. Même chose sur votre portable : l’application desktop est encore ouverte, les ventilateurs tournent et un cœur CPU est à 100 % dans le Moniteur d’activité. C’est un sondage au repos qui interroge deux fois par seconde.
Les deux blocages partagent une seule cause : du travail qui appartient à l’arrière-plan était assis dans l’embrasure de la porte. Une série de changements fusionnés les 18 et 20 septembre (#117206, #117063, #117066, #117201, #117041, #116967) s’attaque à ces passages, et le correctif est chaque fois identique : les chemins de lecture restent locaux, les écritures partent dans un thread d’arrière-plan, les sondages obéissent à une cadence au lieu de tourner à chaque itération de la boucle.
Une seule écriture de statut gelait chaque message entrant
write_runtime_status() écrit l’état d’exécution du gateway dans gateway/runtime_status.json par un read-merge-write. Cela semble bon marché, mais c’était exécuté de façon synchrone sur la boucle d’événements, deux fois par tour plus une fois à chaque transition d’état d’adaptateur.
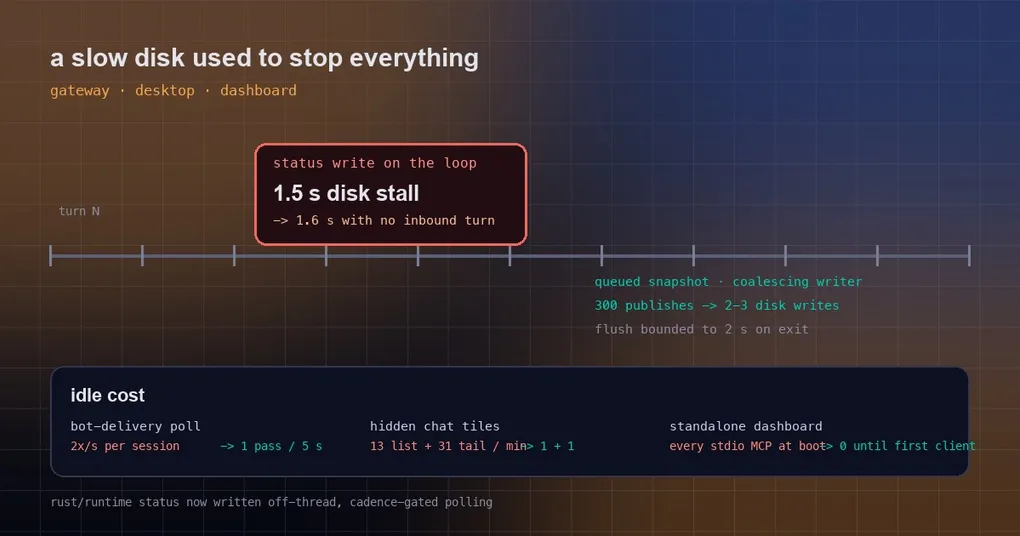
Sur un disque lent ou saturé, ces trois étapes bloquent toute la boucle. La sonde du PR #117206 est sans ambiguïté : un blocage disque de 1,5 s a produit un blocage de boucle de 1,6 s — et pendant ces 1,6 secondes, chaque message entrant, y compris ce « t’es là ? » parti de votre téléphone, reste dans une file d’attente.
Le correctif sépare complètement l’écriture :
- les mises à jour de statut publient dans un instantané en mémoire (
publish_runtime_status()), sans jamais toucher le disque sur le chemin chaud ; - un thread écrivain qui fusionne les écritures (
_RuntimeStatusWriter) possède le fichier et replie une rafale de mises à jour en quelques écritures — mesuré à 300 publications réduites à 2-3 écritures disque ; - les points d’appel qui ont réellement besoin des octets sur le disque (démarrage, arrêt) utilisent une attente bornée (
wait_timeout), et l’estampille finale à la sortie dispose d’un budget de 2 s au lieu de bloquer indéfiniment.
Un comportement à connaître : l’écrivain relit le fichier juste avant chaque écriture et pose son instantané par-dessus le résultat, de sorte que les champs écrits par d’autres processus ne sont pas écrasés (pensez à hermes gateway migrate --standalone, ou à un conteneur qui initialise desired_state au boot). La contrepartie est le revers d’une attente bornée : si le disque est coincé à la sortie, l’estampille « stopped » peut être périmée au démarrage suivant plutôt que de faire pendre l’arrêt.
L’application desktop : deux sondages par seconde, et des tuiles masquées qui continuaient de sonder
hermes serve (le backend derrière l’application desktop et la TUI) exécute un sondage de livraison de bot. Le seul point bloquant de sa boucle est completion_queue.get(timeout=0.5) — autrement dit chaque itération de la boucle lançait une sonde de livraison : deux fois par seconde, par session. Chaque sonde parcourait chaque bail de active_sessions.json et appelait psutil pour vérifier que le processus était vivant.
Le coût, c’est sessions × baux × 2/s. Les chiffres du rapporteur : 11 sessions, 8 baux, 88 sondes par tour à 102 % d’un cœur CPU.
Le PR #117063 aligne le sondage de livraison sur la même cadence de 5 s que les sondages /loop, /heartbeat et kanban, et court-circuite complètement quand un bail appartient au processus courant — aucune sonde psutil sur soi-même. Les sondes passent de 10 par 5 s à 1, et les appels psutil pour les baux auto-détenus d’environ 80 à zéro. Le court-circuit conserve délibérément la comparaison d’identité (pid, process start time) : sinon, un PID recyclé qui se trouverait être le vôtre pourrait maintenir indéfiniment un bail périmé.
Même série, même famille : les tuiles de chat keep-alive masquées continuaient à sonder subagent.list toutes les 5 s et subagent.tail toutes les 2 s par sous-agent actif. Leur seule garde était document.visibilityState — et la fenêtre entière est visible ; les onglets sont masqués avec visibility: hidden, la mise en page préservée. La garde était donc toujours vraie. Le PR #117066 conditionne les deux pollers au contexte de visibilité du panneau et les réarme à l’affichage. Par tuile masquée et par minute, cela fait passer « 13 list + 31 tail » à « 1 + 1 ».
hermes dashboard : pas de tempête de spawn MCP au boot, pas d’UI figée sur une grosse base
Deux autres blocages vivent dans hermes dashboard.
Préchauffage au démarrage. Un hermes dashboard lancé en standalone déclenchait immédiatement la découverte MCP en arrière-plan — en spawnant chaque serveur MCP stdio configuré, même si personne n’ouvrait jamais l’UI. Le rapporteur a remonté la piste via le brassage d’écritures de mcp-stderr.log, qui se voit très mal sur du stockage NAS/ZFS. Le PR #117201 arme la découverte et la déclenche au premier client /api/ws (ou la fait avancer au premier build d’agent). Un dashboard lancé par Desktop garde son démarrage avide, donc rien ne change de ce côté.
Un gros state.db qui bloque tout. GET /api/sessions/search, /api/sessions/stats et /api/sessions/{id} ouvraient SQLite directement dans des handlers async def. Une fois la base de sessions à quelques centaines de mégaoctets, la requête FTS5 bloque la boucle d’événements pendant des secondes — le symptôme est une barre latérale figée et des délais d’expiration de réveil WebSocket. Le PR #117041 fait passer le travail base de données de ces trois handlers par asyncio.to_thread, comme les handlers frères du même module. Avant/après : les ouvertures SQLite sur le thread de la boucle à travers les trois routes passent de 3 sur 4 à 0 sur 4.
Si votre base de sessions est déjà volumineuse, il existe une passe hors ligne que vous pouvez lancer dès aujourd’hui : hermes sessions optimize-storage (avec tous les détenteurs arrêtés) reconstruit l’index FTS. Ce chemin vient du #65798 antérieur, pas de cette série.
« Database is locked » — désormais le log nomme le processus qui la détient
Certaines attentes sont bénignes. Un verrou d’écriture détenu par quelqu’un d’autre ne l’est pas. Chaque processus Hermes a state.db ouvert, donc scanner les descripteurs ouverts ne permet pas de distinguer l’unique écrivain des lecteurs — le message de délai de 60 secondes ne pouvait nommer que la victime (database is locked (another Hermes process held the state.db write lock for over 60s)), et vous n’aviez aucune idée du processus à tuer.
Le PR #116967 lit /proc/locks pour la base, ses inodes -wal et -shm juste avant de lever l’erreur, ne garde que les verrous de classe écriture, décode les décalages d’octets de SQLite (sur -shm, 120 est une écriture WAL, 121 un checkpoint, 122 un recover, 123-127 des slots de lecture ; un octet pending sur le fichier principal signifie PENDING/RESERVED/SHARED) et attribue le détenteur à un PID. La nouvelle ligne de log :
WARNING hermes_state_lockowners: state.db write lock unavailable for 60s (state.db):
PID 594094 (hermes --worktree --yolo) holds WAL write lock on state.db-shm
Deux limites à garder en tête : c’est Linux uniquement (ça lit /proc/locks), et les verrous OFD n’exportent pas de PID, donc le log le dit au lieu de deviner. La ligne de commande du détenteur va dans le log, pas dans le texte de l’exception — les erreurs sont regroupées par phrase, et un worktree nommé fix-corrupt-db ferait basculer de seau.
Si vous subissez régulièrement de la contention de verrous, les articles sur l’auto-réparation de la corruption de state.db et sur le garde-fou d’écriture WAL couvrent les budgets de nouvelle tentative et le flux de réparation.
Les mises à jour ne font plus une passe inutile
Encore une de la même série, parce qu’elle est très tangible : hermes update relançait npm ci dès que les sources du web-UI ou du desktop changeaient, extrayant node_modules deux fois. Le PR #117110 conditionne ces deux installations au même digest de manifestes qui conditionnait déjà la première passe (plus une vérification de présence d’Electron pour la passe desktop). Le scénario du rapporteur — trois passes npm, 117 secondes — en saute désormais deux quand le lockfile est inchangé.
Tout cela est-il déjà disponible ?
Honnêtement : non. Chaque changement ci-dessus a été fusionné les 18-20 septembre 2026, et la dernière release est v0.21.3 (tag v2026.9.14). Tout cela vit sur main et ne figure dans aucune release — hermes update vous donne toujours l’ancien comportement. Vous pouvez attendre la prochaine release, ou compiler depuis main vous-même. Pour voir sur quel chemin de code vous êtes aujourd’hui :
hermes --version                          # la release que vous exécutez
hermes sessions optimize-storage          # reconstruction FTS hors ligne pour un gros state.db
Le schéma
Lisez les six changements ensemble et ils traitent une seule maladie : les I/O sur le chemin critique. Une écriture de statut, une sonde de processus, un préchauffage au démarrage, une requête SQLite, une installation npm — chacun semble inoffensif isolément, mais tout ce qui se dresse entre Hermes et « traiter le message suivant » se lit pour l’utilisateur comme « Hermes est lent ». Un test rapide pour toute tâche d’arrière-plan que vous vous apprêtez à laisser sur la boucle principale : a-t-elle besoin du réseau ou d’un disque ? Attend-elle quelque chose dont elle pourrait se passer ? Pourrait-elle tourner sur une cadence ? Un seul « oui » et elle appartient à l’arrière-plan.
Si ce qui vous agace, c’est le blocage côté lecture — un sélecteur qui tourne, une liste qui pend — l’histoire est dans l’article sur le cache du chemin de lecture ; pour la vue en direct des enfants en cours d’exécution dans le desktop, voir piloter les sous-agents en plein vol.