Um disco lento, um assistente congelado: o Hermes levou para o segundo plano três tarefas que entupiam a porta
São 2 da manhã, seu gateway do Hermes roda no NAS e o backup acabou de começar. Você manda um “e aí, tá aí?” pelo celular e fica olhando o spinner. Nada. Você assume que o modelo está lento — mas a máquina está ocupada escrevendo em disco, e toda atualização de status de sessão nessa máquina tem de esperar o bloco anterior terminar. O mesmo acontece no seu notebook: o app desktop continua aberto, as ventoinhas estão girando e um núcleo de CPU fica cravado no Monitor de Atividade. Isso é um poll ocioso sondando duas vezes por segundo.
As duas travadas têm uma causa só: trabalho que pertence ao segundo plano estava parado bem na soleira da porta. Um lote de mudanças mescladas em 18-20 de setembro (#117206, #117063, #117066, #117201, #117041, #116967) mexe nessas soleiras, e a correção é sempre a mesma: caminhos de leitura ficam locais, escritas vão para uma thread de segundo plano, polls rodam num ritmo fixo em vez de a cada iteração do loop.
Uma escrita de status congelava todas as mensagens recebidas
write_runtime_status() grava o estado de runtime do gateway em gateway/runtime_status.json com um read-merge-write. Parece barato, mas rodava de forma síncrona no event loop, duas vezes por turno e mais uma a cada transição de estado de adapter.
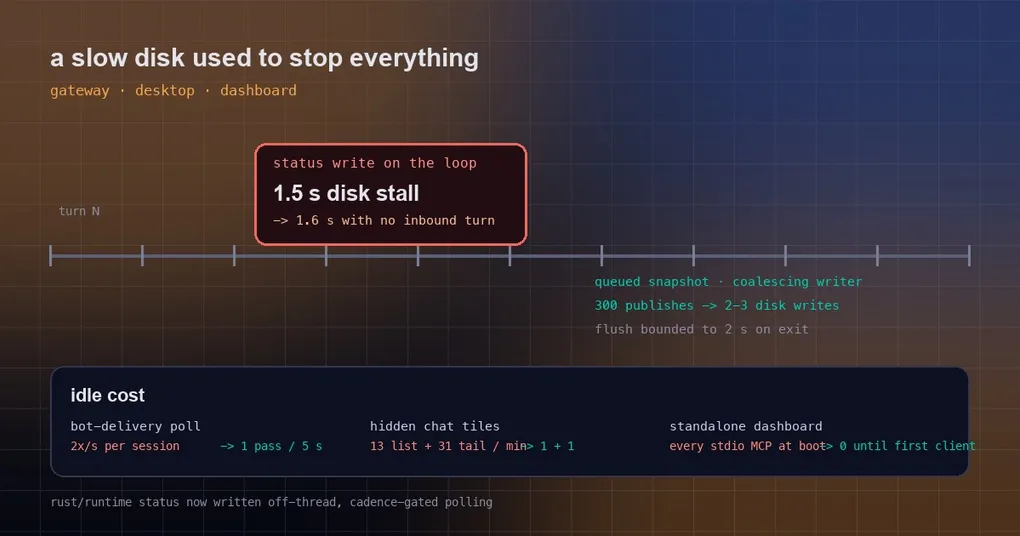
Em um disco lento ou disputado, esses três passos travam o loop inteiro. A sonda do PR #117206 é direta: um stall de disco de 1,5 s produziu um stall de loop de 1,6 s — e durante esses 1,6 segundos toda mensagem que chega, inclusive aquele “e aí, tá aí?” do celular, fica numa fila.
A correção separa a escrita por completo:
- atualizações de status publicam num snapshot em memória (
publish_runtime_status()), sem nunca tocar o disco no caminho quente; - uma thread de escrita com coalescência (
_RuntimeStatusWriter) é dona do arquivo e junta uma rajada de atualizações em poucas escritas — medido em 300 publishes colapsando para 2-3 escritas em disco; - os pontos de chamada que realmente precisam dos bytes no disco (startup, shutdown) usam uma espera limitada (
wait_timeout), e o carimbo final na saída ganha um orçamento de 2 s em vez de bloquear para sempre.
Um comportamento que vale conhecer: o writer relê o arquivo imediatamente antes de cada escrita e sobrepõe o snapshot ao resultado, então campos gravados por outros processos não são sobrescritos (pense em hermes gateway migrate --standalone, ou num contêiner semeando desired_state no boot). O trade-off é o outro lado de uma espera limitada: se o disco estiver travado na saída, o carimbo de “stopped” pode ficar desatualizado no próximo boot, em vez de a saída travar.
O app desktop: duas sondagens por segundo e abas ocultas que continuavam sondando
hermes serve (o backend por trás do app desktop e da TUI) roda um poll de entrega de bot. O único ponto bloqueante do loop é completion_queue.get(timeout=0.5) — ou seja, cada iteração do loop rodava uma sondagem de entrega: duas vezes por segundo, por sessão. Cada sondagem percorria todo lease em active_sessions.json e chamava psutil para conferir se o processo estava vivo.
O custo é sessões × leases × 2/s. Os números de quem reportou: 11 sessões, 8 leases, 88 sondagens por rodada a 102% de um núcleo de CPU.
O PR #117063 coloca o poll de entrega na mesma cadência de 5 s dos polls de /loop, /heartbeat e kanban, e faz um curto-circuito total quando o lease pertence ao processo atual — nenhuma sondagem psutil em você mesmo. As sondagens caíram de 10 a cada 5 s para 1, e as chamadas psutil para leases próprios foram de cerca de 80 para zero. O curto-circuito mantém de propósito a comparação de identidade (pid, horário de início do processo): caso contrário, um PID reciclado que por acaso fosse igual ao seu poderia manter um lease obsoleto vivo para sempre.
Mesmo lote, mesma família: abas de chat keep-alive ocultas continuavam chamando subagent.list a cada 5 s e subagent.tail a cada 2 s por subagente ativo. A única proteção era document.visibilityState — e a janela inteira está visível; as abas são escondidas com visibility: hidden, com o layout preservado. Então a proteção era sempre verdadeira. O PR #117066 condiciona os dois pollers ao contexto de visibilidade do painel e os rearma quando o painel reaparece. Por aba oculta por minuto, isso é “13 list + 31 tail” caindo para “1 + 1”.
hermes dashboard: sem tempestade de spawn de MCP no boot, sem UI travada com um banco grande
Mais duas travadas moram no hermes dashboard.
Warm-up no boot. Um hermes dashboard standalone disparava a descoberta de MCP em segundo plano imediatamente — dando spawn em cada servidor MCP stdio configurado, mesmo que ninguém abrisse a UI. Quem reportou rastreou isso pelo churn de escrita do mcp-stderr.log, que aparece feio em armazenamento NAS/ZFS. O PR #117201 arma a descoberta e a dispara no primeiro cliente /api/ws (ou a antecipa na primeira construção de agente). Um dashboard criado pelo Desktop mantém a inicialização ansiosa, então nada muda ali.
Um state.db grande bloqueando tudo. GET /api/sessions/search, /api/sessions/stats e /api/sessions/{id} abriam o SQLite diretamente dentro de handlers async def. Quando o banco de sessões chega a algumas centenas de megabytes, a query FTS5 bloqueia o event loop por segundos — o sintoma é uma sidebar congelada e timeouts de wake do WebSocket. O PR #117041 encaminha o trabalho de banco desses três handlers por asyncio.to_thread, igual aos handlers irmãos no mesmo módulo. Antes/depois: aberturas de SQLite na thread do loop nas três rotas caíram de 3 de 4 para 0 de 4.
Se seu banco de sessões já está grande, existe uma passada offline separada que você pode rodar hoje: hermes sessions optimize-storage (com todos os detentores parados) reconstrói o índice FTS. Esse caminho veio do #65798 anterior, não deste lote.
“Database is locked” — agora o log nomeia o processo que está segurando o lock
Algumas esperas são benignas. Um lock de escrita nas mãos de outro processo não é. Todo processo do Hermes mantém o state.db aberto, então varrer descritores abertos não distingue o único escritor dos leitores — a mensagem de timeout de 60 segundos só conseguia nomear a vítima (database is locked (another Hermes process held the state.db write lock for over 60s)), e você não tinha ideia de qual processo matar.
O PR #116967 lê /proc/locks do banco, dos seus inodes -wal e -shm, pouco antes de lançar o erro, mantém os locks de classe de escrita, decodifica os deslocamentos de bytes do SQLite (no -shm, 120 é uma escrita WAL, 121 um checkpoint, 122 um recover, 123-127 slots de leitura; um byte pendente no arquivo principal significa PENDING/RESERVED/SHARED) e atribui o detentor a um PID. A nova linha de log:
WARNING hermes_state_lockowners: state.db write lock unavailable for 60s (state.db):
PID 594094 (hermes --worktree --yolo) holds WAL write lock on state.db-shm
Duas limitações a ter em mente: isso é só para Linux (lê /proc/locks), e locks OFD não exportam um PID, então o log diz isso em vez de chutar. A linha de comando do detentor vai para o log, não para o texto da exceção — os erros são agrupados por frase, e um worktree chamado fix-corrupt-db mudaria o bucket.
Se você encontra contenção de lock com frequência, os textos sobre autocorreção de corrupção do state.db e guarda de escrita do WAL cobrem os orçamentos de retry e o fluxo de reparo.
As atualizações pararam de fazer uma passada inútil
Mais uma do mesmo lote, porque é bem tangível: hermes update rodava npm ci de novo sempre que as fontes da web-UI ou do desktop mudavam, extraindo node_modules duas vezes. O PR #117110 condiciona essas duas instalações ao mesmo digest de manifestos que já condicionava a primeira passada (mais uma checagem de presença do Electron para a passada do desktop). O cenário de quem reportou — três passadas de npm, 117 segundos — agora pula duas delas quando o lockfile não mudou.
Isso já está disponível?
Sendo honesto: não. Toda mudança acima foi mesclada em 18-20 de setembro de 2026, e a release mais nova é a v0.21.3 (tag v2026.9.14). Elas vivem na main e não estão em nenhuma release — hermes update ainda te dá o comportamento antigo. Você pode esperar a próxima release ou compilar da main. Para ver em qual caminho de código você está hoje:
hermes --version                          # qual release você está rodando
hermes sessions optimize-storage          # reconstrução offline do FTS para um state.db grande
O padrão
Lidas juntas, as seis mudanças tratam de uma doença só: I/O no caminho crítico. Uma escrita de status, uma sondagem de processo, um warm-up de boot, uma query SQLite, um npm install — cada uma parece inofensiva sozinha, mas qualquer coisa que fique entre o Hermes e “tratar a próxima mensagem” soa para o usuário como “o Hermes está lento”. Um teste rápido para qualquer tarefa de segundo plano que você esteja prestes a deixar no loop principal: ela precisa de rede ou de disco? Ela espera algo que não precisaria? Ela poderia rodar num ritmo fixo? Um único “sim” e ela pertence ao segundo plano.
Se o que te incomoda é a trava do lado da leitura — um picker que gira, uma lista que trava — essa história está em o post sobre cache do caminho de leitura; para a visão ao vivo do desktop dos processos filhos em execução, veja dirigir subagentes em pleno voo.