Por que abrir um dropdown custa três segundos
Você aperta Ctrl+P para trocar de modelo. O dropdown abre — vazio — e o cursor gira por três ou quatro segundos até a lista aparecer. Você culpa a rede, mas no mesmo instante o hermes plugins list também está ali parado sem fazer nada, e o painel de Profiles na barra lateral do desktop perde um frame toda vez que se atualiza. Três superfícies, três travamentos e, se você ler as implementações, o mesmo hábito: o caminho que lê uma lista também estava indo buscar na rede e percorrendo o filesystem.
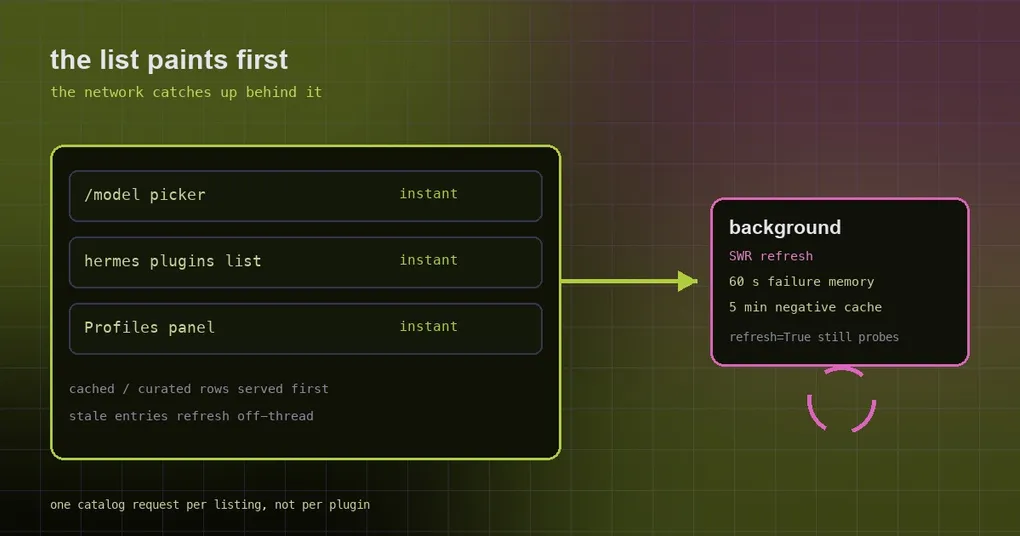
Três PRs mesclados em 18 de setembro de 2026 desembaraçam esse hábito — #114994 para o seletor de modelos, #114811 para as listagens de plugins, #114879 para o painel de Profiles. Vale lê-los em conjunto porque o princípio por trás dos três cabe em uma frase: o caminho de leitura toca apenas dados locais; a rede e o trabalho pesado vão para segundo plano.
Três travamentos, uma causa
| Superfície | O que toda leitura costumava fazer | O que isso custava de fato |
|---|---|---|
| Seletor de modelos (Desktop / TUI / dashboard) | chamar /v1/models e sondagens de autenticação em cada provider autenticado |
uma requisição por provider; o mais lento define a sua espera |
hermes plugins list / página de Plugins |
buscar o catálogo ao vivo para cada linha de plugin (e cada nome candidato dela) | plugins × candidates × timeout; quando o host do catálogo está inacessível, o travamento se multiplica |
Painel de Profiles / GET /api/profiles |
rglob("SKILL.md") por profile para contar skills |
uma varredura completa da árvore de skills a cada poll |
O terceiro é o arquétipo: ele não trava uma vez, trava a cada poll. O app de desktop puxa a lista de profiles a cada poucos segundos, então “contar as skills” — algo que precisa acontecer uma vez por dia — virou pressão contínua de I/O.
O seletor de modelos: sirva o cache, atualize por trás dele
O caminho de leitura de model.options (refresh=False) agora se comporta como stale-while-revalidate: devolve imediatamente as linhas vindas do cache ou da lista curada e atualiza catálogos desatualizados fora da thread.
Mecanicamente, uma flag non_blocking_catalogs desce pela cadeia de chamadas até cached_provider_model_ids(non_blocking=True):
- uma linha com as mesmas credenciais no cache de disco é servida com qualquer idade, e o refresh é disparado fora da thread;
- uma linha fria (sem cache) devolve uma lista vazia, então o chamador mantém sua lista curada — você nunca fica com um dropdown em branco;
- o pool de prefetch paralelo (com o qual o chamador costumava se juntar sem timeout) é simplesmente ignorado nesse caminho.
Várias correções menores no mesmo PR mostram de onde os segundos realmente vinham:
- Escritores concorrentes precisavam de lock. Threads atualizando providers diferentes descartavam as linhas umas das outras; agora as escritas são serializadas sob
_cache_write_lock. - A sondagem de 8 segundos do Ollama Cloud. O caminho de leitura passa
cache_only=, pulando essa sondagem — e ele também não escreve mais no cache de disco (só um resultado que incluiu o catálogo ao vivo é persistido). - Codex e Copilot caem para a lista curada em uma leitura fria (a versão inicial do contribuidor renderizava uma linha de Copilot vazia).
- As falhas do Z.AI são lembradas. Uma chave que retorna 429 em todo endpoint antes reexecutava quatro sondagens de chat completion a cada abertura do seletor, e era daí que vinham as linhas repetidas de
POST …/chat/completions -> 429relatadas. A detecção de endpoint com falha agora é lembrada em processo por cinco minutos, igual ao cache negativo que a troca de token do Copilot já tinha. refresh=Truenão mudou. O botão “Refresh models” continua invalidando o cache e sondando cada provider ao vivo. A resposta instantânea é o que você ganha por padrão; a resposta ao vivo exige um clique deliberado.
Listagens de plugins: lembre das falhas, iça o trabalho repetido
Dois problemas estavam por trás do hermes plugins list:
- Um fetch de catálogo ao vivo que falhava nunca era lembrado. O
fetch_live_catalog()só escrevia seu cache em caso de sucesso e não deixava nada em caso de falha, então um host de catálogo inacessível significava esperar o timeout de uma conexão nova a cada chamada. - A kill list era calculada na granularidade errada. Cada linha de plugin — e cada um dos seus até três candidatos (o nome, o nome de catálogo do sidecar, o repositório do sidecar) — percorria de forma independente “consultar a lista de removidos” → “buscar o catálogo ao vivo”. O total era
plugins × candidates × timeout.
A correção faz duas coisas: o fetch_live_catalog agora lembra de uma tentativa falha por LIVE_CATALOG_FAILURE_TTL_SECONDS (60 segundos), período durante o qual uma cópia desatualizada em disco ainda responde e a rede é deixada em paz (force=True contorna os dois caches); e a kill list é resolvida uma vez por listagem e uma vez por reconstrução do hub (resolved_removed_entries()), com cada linha comparada contra esse único resultado (removed_annotation(...)).
Uma correção menos visível tem o efeito mais sentido: o GET /api/dashboard/plugins/hub do dashboard agora faz await de asyncio.to_thread(_merged_plugins_hub). A reconstrução rodava no event loop, o que significava que as requisições HTTP e todos os WebSockets congelavam enquanto ela rodava — você via a interface inteira travar, não apenas uma página de plugins lenta.
O painel de Profiles: o poll não deve percorrer árvores de skills
A terceira correção é a mais limpa: as contagens de skills deixam de ser calculadas na leitura e passam a ser último valor conhecido mais uma recontagem em segundo plano.
list_profiles(lazy_skill_count=True)devolve o últimoskill_countconhecido; uma entrada nunca contada ou antiga agenda uma execução de_count_skillsem segundo plano por profile a cada janela de rechecagem de 60 segundos, então a thread da requisição faz zero I/O na árvore de skills e a cadência do refresh fica desacoplada da taxa de poll.- Esse é o modo usado por
GET /api/profiles, pelo RPCprofiles.liste pela entrada de fallback REST. - O padrão síncrono não mudou:
hermes profile list/showeprofiles.describecontinuam reportando números atualizados. O caminho preciso não foi sacrificado — só o que é consultado por polling. - A própria contagem ficou mais barata:
_walk_skill_countagora usa o walker do próprio repositório (agent.skill_utils.iter_skill_index_files, umos.walkcom poda) em vez dePath.rglob— cerca de metade das chamadas ao filesystem, e best-effort quando uma subárvore desaparece no meio da varredura em vez de abortar a enumeração inteira. - O TTL da contagem de skills passou de 30 segundos para 600, com a invalidação por assinatura ainda capturando adição/remoção de skills no refresh seguinte.
- Mais duas rotas (
/api/profiles/projects/treee/api/profiles/sessions/pull-requests) só consumiam nome e caminho, mas pagavam a varredura completa delist_profiles(); agora usamprofiles_to_serve, uma leitura pura de diretório.
Duas coisas a ter em mente
refresh=Trueexiste justamente para quebrar o cache. Se um modelo que você sabe que existe estiver faltando na lista, clicar em “Refresh models” é o movimento correto — não desconfiar de um cache quebrado.- Os painéis de Profiles do Desktop e do dashboard agora mostram o último skill count conhecido. Logo depois de instalar uma skill, o número pode ficar um ciclo de refresh atrás; isso é design, não bug. Para um número ao vivo, use
hermes profile show <name>.
Para contexto sobre trabalho no caminho de leitura, veja o post sobre a paleta de comandos, que cobre a mesma interação de “digite e filtre na hora”. A revisão e a instalação de catálogo são explicadas no guia do catálogo de plugins e na referência do hermes plugins; para configurações com múltiplos profiles, veja o guia de multi-instância com profiles e a referência do hermes profile.
Status de release
Os três PRs entraram na main em 18 de setembro de 2026, e a tag mais recente é a v0.21.3 (nome de tag v2026.9.14, lançada em 14 de setembro), então nada disso está em uma release marcada ainda:
hermes --version
hermes update
A lição
Três travamentos que parecem desconexos, um princípio: um caminho de leitura precisa continuar instantâneo quando a rede está fora e o diretório é enorme. As regras reaproveitáveis são três — sirva o cache primeiro e atualize por trás dele (serializando escritores concorrentes), trate uma falha como um estado que vale a pena lembrar e iça trabalho repetido para a granularidade certa em vez de refazê-lo por linha ou por profile. Da próxima vez que algum painel “levar alguns segundos para abrir”, pergunte primeiro: neste caminho de leitura, quem está mexendo na rede ou percorrendo o filesystem em silêncio?