Por qué abrir un desplegable te cuesta tres segundos
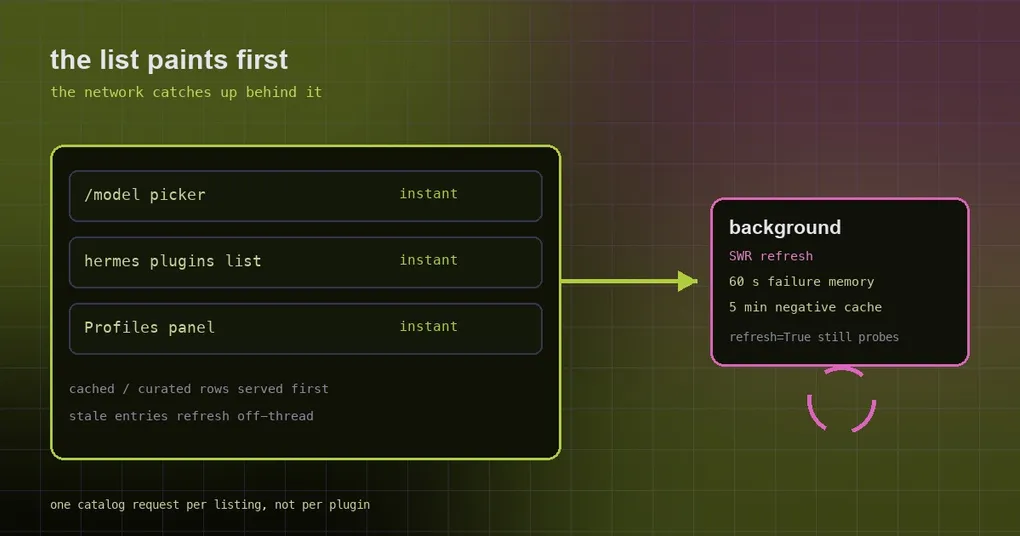
Pulsas Ctrl+P para cambiar de modelo. El desplegable se abre —vacío— y el cursor gira tres o cuatro segundos antes de que la lista se rellene. Le echas la culpa a la red, pero en ese mismo momento hermes plugins list también está ahí parado sin hacer nada, y el panel de Profiles de la barra lateral del escritorio pierde un frame cada vez que se refresca. Tres superficies, tres bloqueos y, si lees sus implementaciones, encuentras la misma costumbre: el camino que lee una lista también estaba yendo a la red y recorriendo el sistema de archivos.
Tres PR fusionados el 18 de septiembre de 2026 desenredan esa costumbre: el #114994 para el selector de modelos, el #114811 para los listados de plugins y el #114879 para el panel de Profiles. Merece la pena leerlos juntos porque el principio que hay detrás de los tres cabe en una frase: el camino de lectura solo toca datos locales; la red y el trabajo pesado se van a segundo plano.
Tres bloqueos, una causa
| Superficie | Qué hacía antes cada lectura | Lo que costaba de verdad |
|---|---|---|
| Selector de modelos (Desktop / TUI / dashboard) | llamar a /v1/models y hacer sondas de auth en cada proveedor autenticado |
una petición por proveedor; el más lento marca tu espera |
hermes plugins list / página de Plugins |
descargar el catalog en vivo para cada fila de plugin (y para cada nombre candidato suyo) | plugins × candidates × timeout; cuando el host del catalog no responde, el bloqueo se multiplica |
Panel de Profiles / GET /api/profiles |
rglob("SKILL.md") por profile para contar skills |
un recorrido completo del árbol de skills en cada sondeo |
El tercero es el arquetipo: no se bloquea una vez, se bloquea en cada sondeo. La app de escritorio pide la lista de profiles cada pocos segundos, así que «contar las skills», algo que debería pasar una vez al día, se convirtió en presión continua de I/O.
El selector de modelos: sirve la caché y refresca por detrás
El camino de lectura de model.options (refresh=False) ahora se comporta como stale-while-revalidate: devuelve de inmediato las filas cacheadas o curadas y refresca los catalogs obsoletos fuera del hilo.
En lo mecánico, un flag non_blocking_catalogs viaja por la cadena de llamadas hasta cached_provider_model_ids(non_blocking=True):
- una fila con las mismas credenciales en la caché de disco se sirve sea cual sea su antigüedad, y el refresco se lanza fuera del hilo;
- una fila en frío devuelve una lista vacía, así que quien llama conserva su lista curada: nunca te quedas con un desplegable en blanco;
- el pool de precarga en paralelo (al que antes se unía la llamada sin timeout) se omite por completo en este camino.
Varios arreglos menores del mismo PR muestran de dónde salían realmente esos segundos:
- Los escritores concurrentes necesitaban un lock. Los hilos que refrescaban proveedores distintos se pisaban las filas entre sí; ahora las escrituras se serializan bajo
_cache_write_lock. - La sonda de 8 segundos de Ollama Cloud. El camino de lectura pasa
cache_only=, saltándose esa sonda, y además ya no escribe la caché de disco (solo se persiste un resultado que incluía el catalog en vivo). - Codex y Copilot recurren a su lista curada en una lectura en frío (la versión inicial del contribuidor renderizaba una fila de Copilot vacía).
- Los fallos de Z.AI se recuerdan. Una clave que devuelve 429 en todos los endpoints antes volvía a lanzar cuatro sondas de chat-completion cada vez que abrías el selector, y de ahí venían las líneas repetidas
POST …/chat/completions -> 429del usuario que lo reportó. La detección de endpoint fallido ahora se recuerda en proceso durante cinco minutos, igual que la caché negativa que ya tenía el intercambio de token de Copilot. refresh=Trueno cambia. El botón «Refresh models» sigue invalidando la caché y sondeando cada proveedor en vivo. La respuesta instantánea es lo que obtienes por defecto; la respuesta en vivo es un clic deliberado.
Los listados de plugins: recordar los fallos y elevar el trabajo repetido
Detrás de hermes plugins list había dos problemas:
- Una descarga fallida del catalog en vivo no se recordaba nunca.
fetch_live_catalog()escribía su caché solo en caso de éxito y no dejaba nada atrás en caso de fallo, así que un host de catalog inaccesible significaba esperar un timeout de conexión nuevo en cada llamada. - La kill list se calculaba con la granularidad equivocada. Cada fila de plugin, y cada uno de sus hasta tres candidatos (el nombre, el nombre de catalog del sidecar, el repo del sidecar), recorría por su cuenta «buscar en la lista de eliminados» → «descargar el catalog en vivo». El total era
plugins × candidates × timeout.
El arreglo hace dos cosas: fetch_live_catalog ahora recuerda un intento fallido durante LIVE_CATALOG_FAILURE_TTL_SECONDS (60 segundos), tiempo durante el cual una copia obsoleta en disco sigue respondiendo y la red se deja en paz (force=True salta ambas cachés); y la kill list se resuelve una vez por listado y una vez por reconstrucción del hub (resolved_removed_entries()), con cada fila comparada contra ese único resultado (removed_annotation(...)).
Un arreglo menos visible tiene el efecto más sonoro: el GET /api/dashboard/plugins/hub del dashboard ahora hace await asyncio.to_thread(_merged_plugins_hub). La reconstrucción se ejecutaba en el event loop, lo que significaba que las peticiones HTTP y todos los WebSocket se congelaban mientras corría: veías toda la interfaz colgada, no solo una página de plugins lenta.
El panel de Profiles: el sondeo no debería recorrer árboles de skills
El tercer arreglo es el más limpio: los recuentos de skills pasan de calcularse al leer a último valor conocido más un recuento en segundo plano.
list_profiles(lazy_skill_count=True)devuelve el últimoskill_countconocido; una entrada que nunca se contó o que está caducada programa un_count_skillsen segundo plano por profile y por ventana de recomprobación de 60 segundos, así que el hilo de la petición hace cero I/O del árbol de skills y la cadencia de refresco queda desacoplada de la frecuencia del sondeo.- Ese es el modo que usan
GET /api/profiles, el RPCprofiles.listy la entrada de fallback REST. - El valor por defecto síncrono no cambia:
hermes profile list/showyprofiles.describesiguen informando de cifras frescas. No se ha sacrificado el camino preciso, solo el sondeado. - Contar por sí mismo se ha vuelto más barato:
_walk_skill_countahora usa el walker del propio repositorio (agent.skill_utils.iter_skill_index_files, unos.walkcon pruning) en lugar dePath.rglob: aproximadamente la mitad de llamadas al sistema de archivos, y best-effort cuando un subárbol desaparece a mitad del recorrido en lugar de abortar toda la enumeración. - El TTL del recuento de skills pasó de 30 segundos a 600, con la invalidación por firma encargándose todavía de detectar el alta o la baja de skills en el siguiente refresco.
- Otras dos rutas (
/api/profiles/projects/treey/api/profiles/sessions/pull-requests) solo consumían el nombre y la ruta pero pagaban el recorrido completo delist_profiles(); ahora usanprofiles_to_serve, una lectura de directorio pura.
Dos cosas que conviene tener en cuenta
- Se supone que
refresh=Truerompe la caché. Si falta en la lista un modelo que sabes que existe, hacer clic en «Refresh models» es lo correcto, y no sospechar de una caché rota. - Los paneles de Profiles de Desktop y del dashboard ahora muestran el último recuento de skills conocido. Justo después de instalar una skill, el número puede quedarse un ciclo de refresco por detrás; eso es diseño, no un bug. Para un número en vivo, usa
hermes profile show <name>.
Para poner en contexto el trabajo sobre el camino de lectura, mira el artículo sobre la paleta de comandos, que cubre la misma interacción de «escribir y filtrar al instante». La revisión e instalación de catalogs se explican en la guía del plugin catalog y la referencia de hermes plugins; para configuraciones con varios profiles, mira la guía multi-instancia de profiles y la referencia de hermes profile.
Estado de la release
Los tres PR se fusionaron en main el 18 de septiembre de 2026, y el tag más reciente es la v0.21.3 (nombre del tag v2026.9.14, publicado el 14 de septiembre), así que nada de esto está todavía en una release etiquetada:
hermes --version
hermes update
La lección
Tres bloqueos que parecen no tener relación, un principio: un camino de lectura tiene que seguir siendo instantáneo cuando la red está caída y el directorio es enorme. Las reglas reutilizables son tres: servir primero la caché y refrescar por detrás (serializando a los escritores concurrentes), tratar un fallo como un estado que merece recordarse y elevar el trabajo repetido a la granularidad correcta en lugar de rehacerlo por fila o por profile. La próxima vez que algún panel «tarde unos segundos en abrirse», pregúntate primero: en este camino de lectura, ¿quién está tocando la red o recorriendo el sistema de archivos a escondidas?