Warum ein geöffnetes Dropdown dich drei Sekunden kostet
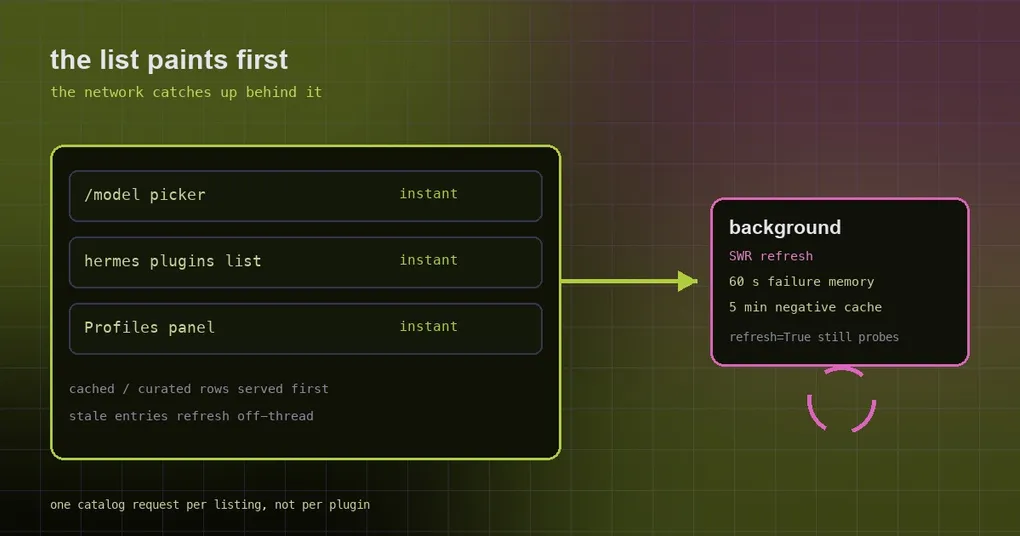
Du drückst Ctrl+P, um das Modell zu wechseln. Das Dropdown öffnet sich — leer — und der Cursor dreht drei oder vier Sekunden, bevor sich die Liste füllt. Du gibst dem Netzwerk die Schuld, aber im selben Moment hängt auch hermes plugins list einfach nur da, und das Profiles-Panel in der Desktop-Sidebar verliert bei jedem Refresh einen Frame. Drei Oberflächen, drei Hänger — und liest man die Implementierungen, findet man dieselbe Gewohnheit: Der Pfad, der eine Liste liest, griff auch noch ins Netzwerk und lief das Dateisystem ab.
Drei am 18. September 2026 gemergte PRs entwirren diese Gewohnheit — #114994 für den Model-Picker, #114811 für Plugin-Listen, #114879 für das Profiles-Panel. Sie lohnen sich gemeinsam gelesen, weil das Prinzip hinter allen dreien ein einziger Satz ist: Der Lesepfad berührt nur lokale Daten; Netzwerk und schwere Arbeit wandern in den Hintergrund.
Drei Hänger, eine Ursache
| Oberfläche | Was jeder Lesevorgang früher tat | Was es wirklich kostete |
|---|---|---|
| Model-Picker (Desktop / TUI / Dashboard) | bei jedem authentifizierten Provider /v1/models und Auth-Probes aufrufen |
eine Anfrage pro Provider; der langsamste bestimmt deine Wartezeit |
hermes plugins list / Plugins-Seite |
den Live-Katalog für jede Plugin-Zeile holen (und für jeden ihrer Kandidatennamen) | plugins × candidates × timeout; ist der Katalog-Host nicht erreichbar, vervielfacht sich der Hänger |
Profiles-Panel / GET /api/profiles |
pro Profile rglob("SKILL.md"), um Skills zu zählen |
ein vollständiger Walk über den Skill-Baum bei jedem Poll |
Der dritte Fall ist der Archetyp: Er hängt nicht einmal, er hängt bei jedem Poll. Die Desktop-App holt die Profile-Liste alle paar Sekunden, und so wurde „Skills zählen“ — eigentlich eine Aufgabe für einmal am Tag — zu dauerhaftem I/O-Druck.
Der Model-Picker: Cache ausliefern, dahinter aktualisieren
Der Lesepfad von model.options (refresh=False) verhält sich jetzt wie Stale-While-Revalidate: Er gibt gecachte oder kuratierte Zeilen sofort zurück und aktualisiert veraltete Kataloge außerhalb des Threads.
Technisch wandert ein Flag non_blocking_catalogs die Aufrufkette hinunter bis in cached_provider_model_ids(non_blocking=True):
- Eine Zeile im Disk-Cache mit denselben Credentials wird unabhängig von ihrem Alter ausgeliefert, der Refresh läuft in einem separaten Thread;
- eine kalte Zeile gibt eine leere Liste zurück, sodass der Aufrufer seine kuratierte Liste behält — ein leeres Dropdown bekommst du nie;
- der parallele Prefetch-Pool (auf den der Aufrufer früher ohne Timeout gewartet hat) wird auf diesem Pfad komplett übersprungen.
Mehrere kleinere Fixes im selben PR zeigen, woher die Sekunden tatsächlich kamen:
- Nebenläufige Schreiber brauchten ein Lock. Threads, die verschiedene Provider aktualisierten, verwarfen gegenseitig ihre Zeilen; Schreibvorgänge werden jetzt unter
_cache_write_lockserialisiert. - Die 8-Sekunden-Probe von Ollama Cloud. Der Lesepfad übergibt
cache_only=und überspringt diese Probe — und er schreibt den Disk-Cache gar nicht mehr (persistent gespeichert wird nur ein Ergebnis, das den Live-Katalog enthielt). - Codex und Copilot fallen bei einem kalten Lesevorgang auf ihre kuratierte Liste zurück (in der ersten Version des Beitragenden wurde eine leere Copilot-Zeile gerendert).
- Z.AI-Fehler werden gemerkt. Ein Key, der auf jedem Endpoint 429 liefert, durchlief früher bei jedem Öffnen des Pickers erneut vier Chat-Completion-Probes — daher kamen die wiederholten
POST …/chat/completions -> 429-Zeilen im Bugreport. Die Erkennung fehlgeschlagener Endpoints wird jetzt prozessintern fünf Minuten lang gemerkt, passend zum Negative-Cache, den der Token-Austausch von Copilot bereits hatte. refresh=Trueist unverändert. Der Button „Refresh models“ leert weiterhin den Cache und probt jeden Provider live. Die sofortige Antwort bekommst du per Default; die Live-Antwort ist ein bewusster Klick.
Plugin-Listen: Fehler merken, wiederholte Arbeit nach oben ziehen
Hinter hermes plugins list steckten zwei Probleme:
- Ein fehlgeschlagener Live-Katalog-Abruf wurde nie gemerkt.
fetch_live_catalog()schrieb seinen Cache nur bei Erfolg und ließ bei einem Fehler nichts zurück, ein nicht erreichbarer Katalog-Host bedeutete also, bei jedem Aufruf einen frischen Connection-Timeout auszusitzen. - Die Kill-List wurde auf der falschen Granularität berechnet. Jede Plugin-Zeile — und jeder ihrer bis zu drei Kandidaten (der Name, der Katalogname des Sidecars, das Repo des Sidecars) — durchlief unabhängig „Removed-Liste nachschlagen“ → „Live-Katalog holen“. In Summe:
plugins × candidates × timeout.
Der Fix tut zwei Dinge: fetch_live_catalog merkt sich einen fehlgeschlagenen Versuch jetzt für LIVE_CATALOG_FAILURE_TTL_SECONDS (60 Sekunden); während dieser Zeit antwortet weiterhin eine veraltete Kopie auf der Platte, und das Netzwerk bleibt unberührt (force=True umgeht beide Caches). Und die Kill-List wird einmal pro Auflistung und einmal pro Hub-Rebuild aufgelöst (resolved_removed_entries()), wobei jede Zeile gegen dieses eine Ergebnis abgeglichen wird (removed_annotation(...)).
Ein weniger sichtbarer Fix hat den spürbarsten Effekt: Das GET /api/dashboard/plugins/hub des Dashboards wartet jetzt auf asyncio.to_thread(_merged_plugins_hub). Der Rebuild lief früher auf dem Event-Loop, was bedeutete, dass HTTP-Anfragen und jedes WebSocket währenddessen einfroren — du sahst die gesamte Oberfläche hängen, nicht nur eine langsame Plugins-Seite.
Das Profiles-Panel: Polling darf keine Skill-Bäume ablaufen
Der dritte Fix ist der sauberste: Die Skill-Zahlen wechseln von berechnet-beim-Lesen zu letztem bekannten Wert plus Hintergrund-Neuzählung.
list_profiles(lazy_skill_count=True)gibt den zuletzt bekanntenskill_countzurück; ein nie gezählter oder veralteter Eintrag plant eine Hintergrund-_count_skillspro Profile und 60-Sekunden-Nachprüf-Fenster ein, sodass der Request-Thread keinerlei Skill-Baum-I/O macht und die Refresh-Frequenz vom Poll-Intervall entkoppelt ist.- Das ist der Modus, den
GET /api/profiles, der RPCprofiles.listund der REST-Fallback-Einstieg nutzen. - Der synchrone Default ist unverändert:
hermes profile list/showundprofiles.describemelden weiterhin frische Zahlen. Der genaue Pfad wurde nicht geopfert — nur der gepollte. - Auch das Zählen selbst wurde billiger:
_walk_skill_countnutzt jetzt den eigenen Walker des Repositories (agent.skill_utils.iter_skill_index_files, einos.walkmit Pruning) stattPath.rglob— etwa halb so viele Filesystem-Aufrufe, und best-effort, wenn ein Teilbaum mitten im Walk verschwindet, statt die ganze Aufzählung abzubrechen. - Die TTL der Skill-Zählung wanderte von 30 Sekunden auf 600, wobei die Signatur-Invalidierung das Hinzufügen und Entfernen von Skills beim nächsten Refresh weiterhin erkennt.
- Zwei weitere Routen (
/api/profiles/projects/treeund/api/profiles/sessions/pull-requests) nutzten immer nur Name und Pfad, zahlten aber den vollenlist_profiles()-Walk; sie verwenden jetztprofiles_to_serve, ein reines Verzeichnislesen.
Zwei Dinge, die man im Kopf behalten sollte
refresh=Truesoll den Cache brechen. Wenn ein Modell fehlt, von dem du weißt, dass es existiert, ist ein Klick auf „Refresh models“ das Richtige — nicht der Verdacht auf einen kaputten Cache.- Die Profiles-Panels in Desktop und Dashboard zeigen jetzt die zuletzt bekannte Skill-Zahl. Direkt nach der Installation eines Skills kann die Zahl einen Refresh-Zyklus hinterherhinken; das ist Design, kein Bug. Für eine Live-Zahl nutze
hermes profile show <name>.
Zum Kontext der Arbeit am Lesepfad siehe den Beitrag zur Command Palette, der dieselbe Interaktion „tippen und sofort filtern“ behandelt. Katalog-Review und Installation werden im Plugin-Katalog-Leitfaden und in der hermes plugins-Referenz erklärt; für Setups mit mehreren Profiles siehe den Leitfaden zu mehreren Instanzen und die hermes profile-Referenz.
Release-Status
Alle drei PRs wurden am 18. September 2026 in main gemergt, und der neueste Tag ist v0.21.3 (Tag-Name v2026.9.14, veröffentlicht am 14. September), nichts davon ist also schon in einem getaggten Release:
hermes --version
hermes update
Die Lehre
Drei Hänger, die unzusammenhängend aussehen, ein Prinzip: Ein Lesepfad muss sofort bleiben, wenn das Netzwerk down ist und das Verzeichnis riesig ist. Die wiederverwendbaren Regeln sind drei: zuerst den Cache ausliefern und dahinter aktualisieren (mit Serialisierung nebenläufiger Schreiber), einen Fehler als merkbaren Zustand behandeln und wiederholte Arbeit auf der richtigen Granularität zusammenfassen, statt sie pro Zeile oder pro Profile zu wiederholen. Wenn das nächste Panel „ein paar Sekunden zum Öffnen“ braucht, frag zuerst: Wer berührt auf diesem Lesepfad still das Netzwerk oder läuft das Dateisystem ab?