打开一个下拉框为什么要等好几秒:读列表的路上不该做网络探测
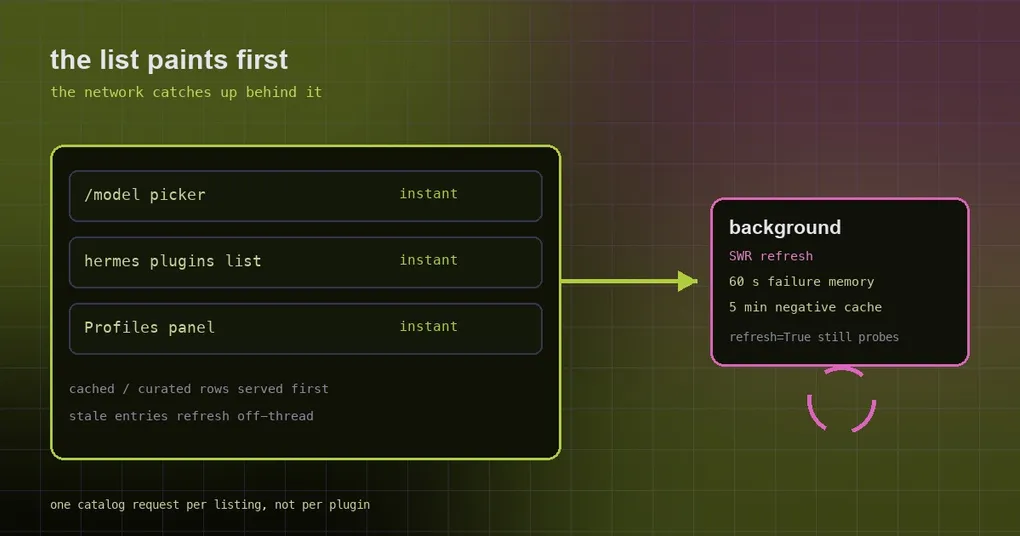
你按 Ctrl+P 想换个模型,下拉框弹出来了,但列表是空的 —— 等待光标转了三四秒才填上内容。你以为是网络慢,其实同一时刻 hermes plugins list 也在原地不动,桌面版侧边栏的 Profiles 面板每刷新一次就掉一下帧。三个界面,三次卡顿,如果去看它们的实现,会发现同一个习惯:在「读一个列表」这条路上,顺手做了「访问网络」和「遍历文件系统」。
这三处卡顿在 9 月 18 日被三个 PR 分别修掉(#114994 模型选择器、#114811 插件列表、#114879 Profiles 面板)。它们值得放在一起读,因为修法背后的原则是同一条:读路径只读本地;网络与重活挪到后台。
三个卡顿,一个根因
| 界面 | 之前每次读列表在做什么 | 真实代价 |
|---|---|---|
| 模型选择器(Desktop / TUI / dashboard) | 对每个已登录 provider 调 /v1/models 与鉴权探测 |
每个 provider 一个请求,最慢的那个决定你等多久 |
hermes plugins list / 插件面板 |
为每一个插件行(以及它的候选名)去拉一次在线目录 | 插件数 × 候选数 × 超时;目录主机不可达时,卡顿按乘法增长 |
Profiles 面板 / GET /api/profiles |
对每个 profile 调 rglob("SKILL.md") 统计技能数 |
轮询一次就遍历一遍全部技能树 |
第三个尤其典型:它不是「慢一次」,而是每次轮询都慢一次。桌面版每隔几秒拉一次 profile 列表,于是「统计技能数」这件本来一天做一次就够的事,变成了持续性的 I/O 压力。
模型选择器:先给缓存,后台再刷新
model.options 这个读路径(refresh=False)现在的行为是 stale-while-revalidate:立刻返回缓存或精选(curated)列表,然后在线程之外去刷新过期的目录。
具体做法是给读路径加了一个 non_blocking_catalogs 标志,一路传到 cached_provider_model_ids(non_blocking=True):
- 只要磁盘缓存里有同一份凭据的记录,无论多旧都直接返回,过期刷新在线程外进行;
- 缓存是冷的(以前从没成功拉过)就返回空,调用方于是保留精选列表 —— 不会出现空白下拉框;
- 并行预取池(原来调用方要无超时地等它)在这条路径上直接跳过。
顺手修的几处细节很能说明「卡顿从哪来」:
- 并发写入要加锁。多个 provider 的刷新线程同时写缓存会互相覆盖对方的行,新增
_cache_write_lock统一串行化; - Ollama Cloud 的 8 秒探测:读路径通过
cache_only=跳过那 8 秒探测,而且读路径不再写缓存(只有包含在线目录的结果才允许落盘); - 冷读时 Codex / Copilot 回退到精选列表(贡献者的初版会让 Copilot 显示为空行);
- Z.AI 的失败要记住:一个在所有端点上都是 429 的 key,之前每次打开选择器都会重跑四次 chat-completion 探测,于是日志里满屏
POST …/chat/completions -> 429。现在失败的端点探测在本进程内记忆 5 分钟(和 Copilot 令牌交换已有的负缓存一致); refresh=True(界面上的 Refresh models)行为不变:清缓存、逐家实时探测。也就是说「我就是要立刻看到最新列表」这条路依然存在,只是不再是你每次打开面板都要付的代价。
插件列表:失败要记住,重复计算要合并
插件侧的问题有两个:
- 在线目录的失败从来不被记住。
fetch_live_catalog()只在成功时写缓存,失败什么都不留 —— 于是目录主机不可达时,每一次调用都要重新等一次连接超时。 - kill list 的计算被放在了错误的粒度上。每个插件行、以及它的最多三个候选(名字、sidecar 里的目录名、sidecar 里的仓库名)都会各走一遍「查剔除名单」→「拉在线目录」。合起来就是
插件数 × 候选数 × 超时。
修法两条:fetch_live_catalog 现在把失败记住 LIVE_CATALOG_FAILURE_TTL_SECONDS(60 秒),在这个窗口里仍然用磁盘上的旧副本作答、网络完全不去碰(force=True 可以绕过);剔除名单在每次列表、每次面板重建时只解析一次(resolved_removed_entries()),每行只跟这份结果比对(removed_annotation(...))。
还有一个不显眼但体感明显的修复:桌面版的 GET /api/dashboard/plugins/hub 现在把重建放进 asyncio.to_thread。之前重建跑在事件循环上,重建期间 HTTP 请求和所有 WebSocket 一起冻结 —— 你看到的是整个界面卡住,而不只是插件页慢。
Profiles 面板:轮询不该遍历技能树
第三个问题的修法最干净:把「技能数」从同步计算改成最后已知值 + 后台补算。
list_profiles(lazy_skill_count=True):skill_count返回上一次算出来的值;从没算过或已过期的记录,会为每个 profile 每 60 秒最多安排一次后台统计,所以请求线程在技能树上花的时间是零,刷新节奏也和轮询频率解耦;- 用它的调用方是
GET /api/profiles、profiles.listRPC 和 REST 回退入口; - 同步的默认行为不变:
hermes profile list/show、profiles.describe依然给实时数字。也就是说「我要准确数字」的场景没有被牺牲,牺牲的只是面板; - 统计本身也变便宜了:
_walk_skill_count改用仓库自己的遍历器(agent.skill_utils.iter_skill_index_files,os.walk+ 剪枝),替代Path.rglob,文件系统调用大约减半,而且子树在遍历中消失时也不再让整个枚举报错; - 技能数缓存 TTL 从 30 秒提到 600 秒,签名变化仍会在下一个刷新周期捕捉到新增/删除的技能;
- 还有两处路由(
/api/profiles/projects/tree、/api/profiles/sessions/pull-requests)本来只需要名字和路径,却付了完整list_profiles()的开销,现在改用profiles_to_serve这份纯目录读取。
你该注意的两件事
refresh=True是故意打破缓存的。如果哪天你发现模型列表里少了一个刚上线的模型,点一次 Refresh models 才是正确的动作 —— 而不是怀疑缓存坏了。- Desktop / dashboard 的 Profiles 面板现在显示「最后已知技能数」。刚安装完一个技能后数字可能晚一个刷新周期才变,这是设计而非 bug;要知道实时数字,用
hermes profile show <name>。
想了解读路径优化的背景,可以看 CLI 命令面板那篇(同一类「输入即过滤」的交互);插件目录的审核与安装见插件目录指南和 hermes plugins 命令参考;Profiles 相关的多实例配置见多 Profile 实例指南,命令细节在 hermes profile 参考。
什么时候能用上
三个 PR 都在 9 月 18 日合入 main,当前最新 tag 是 v0.21.3(tag 名 v2026.9.14,9 月 14 日发布),所以都还没进正式 tag:
hermes --version
hermes update
小结
三个卡顿表面无关,原则只有一条:读路径要能在「网络不通、目录很大」的前提下保持即时。 具体做法是三条可复用的规则 —— 先给缓存再后台刷新(并把并发写串行化)、把失败也当成需要记忆的状态、把「重复计算」提升到正确的粒度而不是每行、每个 profile 各算一遍。下次你看到某个界面「打开就要等几秒」,先问一句:这条读路径上,谁在悄悄访问网络或者遍历文件系统。