Pourquoi l'ouverture d'une liste déroulante vous coûte trois secondes
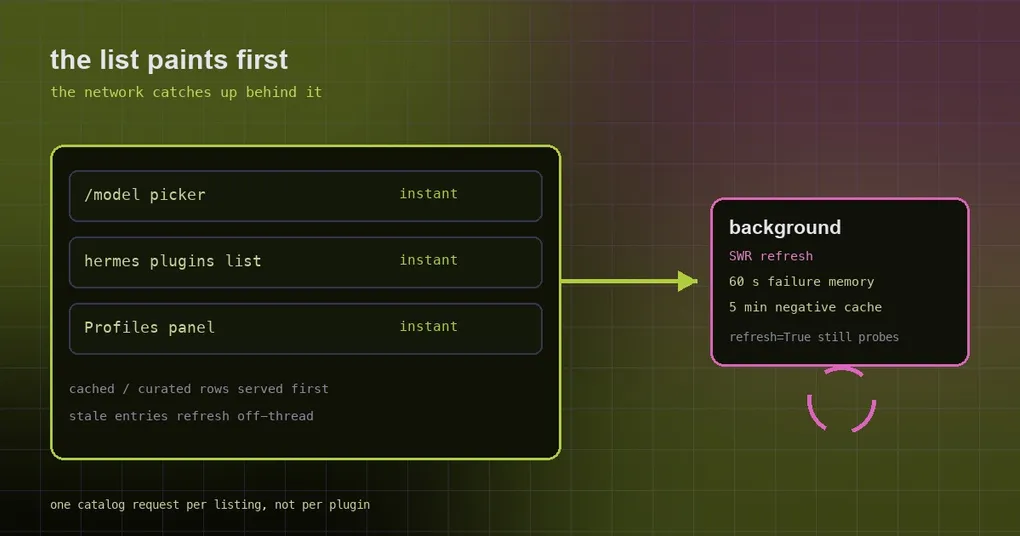
Vous appuyez sur Ctrl+P pour changer de modèle. La liste s’ouvre — vide — et le curseur tourne trois ou quatre secondes avant qu’elle ne se remplisse. Vous accusez le réseau, mais au même moment hermes plugins list reste lui aussi planté sans rien faire, et le panneau Profiles de la barre latérale du desktop perd une frame à chaque refresh. Trois surfaces, trois blocages, et en lisant leurs implémentations on retrouve la même habitude : le chemin qui lit une liste allait aussi chercher sur le réseau et parcourait le système de fichiers.
Trois PR fusionnées le 18 septembre 2026 démêlent cette habitude — #114994 pour le sélecteur de modèle, #114811 pour les listes de plugins, #114879 pour le panneau Profiles. Elles se lisent ensemble, car le principe qui les sous-tend tient en une phrase : le chemin de lecture ne touche que des données locales ; le réseau et le gros du travail passent en arrière-plan.
Trois blocages, une seule cause
| Surface | Ce que chaque lecture faisait auparavant | Ce que cela coûtait vraiment |
|---|---|---|
| Sélecteur de modèle (Desktop / TUI / dashboard) | appeler /v1/models et des sondages d’auth sur chaque provider authentifié |
une requête par provider ; le plus lent fixe votre temps d’attente |
hermes plugins list / page Plugins |
récupérer le catalogue live pour chaque ligne de plugin (et chacun de ses noms candidats) | plugins × candidats × timeout ; quand l’hôte du catalogue est injoignable, le blocage se multiplie |
Panneau Profiles / GET /api/profiles |
rglob("SKILL.md") par profile pour compter les skills |
un parcours complet de l’arbre des skills à chaque poll |
Le troisième est l’archétype : il ne bloque pas une fois, il bloque à chaque poll. L’application desktop tire la liste des profiles toutes les quelques secondes : « compter les skills » — une opération qui devrait avoir lieu une fois par jour — est donc devenue une pression d’I/O continue.
Le sélecteur de modèle : servir le cache, rafraîchir derrière
Le chemin de lecture de model.options (refresh=False) se comporte désormais en stale-while-revalidate : il renvoie immédiatement les lignes mises en cache ou issues de la liste curatée, et rafraîchit les catalogues périmés sur un thread séparé.
Concrètement, un drapeau non_blocking_catalogs descend toute la chaîne d’appels jusqu’à cached_provider_model_ids(non_blocking=True) :
- une ligne du cache disque correspondant aux mêmes identifiants est servie quel que soit son âge, le refresh étant lancé sur un thread séparé ;
- une ligne froide renvoie une liste vide, si bien que l’appelant conserve sa liste curatée — vous n’obtenez jamais une liste déroulante vide ;
- le pool de préchargement parallèle (que l’appelant attendait auparavant sans timeout) est entièrement ignoré sur ce chemin.
Plusieurs correctifs plus modestes, dans la même PR, montrent d’où venaient réellement ces secondes :
- Les écritures concurrentes avaient besoin d’un verrou. Des threads rafraîchissant des providers différents écrasaient mutuellement leurs lignes ; les écritures sont désormais sérialisées sous
_cache_write_lock. - La sonde de 8 secondes d’Ollama Cloud. Le chemin de lecture passe
cache_only=, ce qui saute cette sonde — et il n’écrit plus du tout dans le cache disque (seul un résultat incluant le catalogue live est persisté). - Codex et Copilot retombent sur leur liste curatée en lecture froide (la première version du contributeur affichait une ligne Copilot vide).
- Les échecs Z.AI sont mémorisés. Une clé qui renvoyait un 429 sur chaque endpoint relançait auparavant quatre sondes de chat completion à chaque ouverture du sélecteur, d’où les lignes
POST …/chat/completions -> 429répétées signalées par l’utilisateur. La détection des endpoints en échec est désormais mémorisée dans le processus pendant cinq minutes, comme le cache négatif dont bénéficiait déjà l’échange de token de Copilot. refresh=Truene change pas. Le bouton « Refresh models » vide toujours le cache et sonde chaque provider en direct. La réponse instantanée est ce que vous obtenez par défaut ; la réponse en direct est un clic délibéré.
Les listes de plugins : mémoriser les échecs, remonter le travail répété
Deux problèmes se cachaient derrière hermes plugins list :
- Une récupération ratée du catalogue live n’était jamais mémorisée.
fetch_live_catalog()n’écrivait son cache qu’en cas de succès et ne laissait rien derrière lui en cas d’échec : un hôte de catalogue injoignable signifiait donc attendre un nouveau timeout de connexion à chaque appel. - La kill list était calculée à la mauvaise granularité. Chaque ligne de plugin — et chacun de ses trois candidats maximum (le nom, le nom de catalogue du sidecar, le dépôt du sidecar) — parcourait indépendamment « chercher dans la liste des supprimés » → « récupérer le catalogue live ». Le total faisait
plugins × candidats × timeout.
Le correctif fait deux choses : fetch_live_catalog mémorise désormais une tentative ratée pendant LIVE_CATALOG_FAILURE_TTL_SECONDS (60 secondes), durée pendant laquelle une copie périmée sur disque répond encore et le réseau n’est pas sollicité (force=True court-circuite les deux caches) ; et la kill list est résolue une fois par listing et une fois par reconstruction du hub (resolved_removed_entries()), chaque ligne étant comparée à ce résultat unique (removed_annotation(...)).
Un correctif moins visible a l’effet le plus perceptible : le GET /api/dashboard/plugins/hub du dashboard attend désormais asyncio.to_thread(_merged_plugins_hub). La reconstruction s’exécutait auparavant sur l’event loop, ce qui signifie que les requêtes HTTP et tous les WebSocket se figeaient pendant son déroulement — c’est toute l’interface qui semblait bloquée, pas seulement une page de plugins lente.
Le panneau Profiles : un poll ne devrait pas parcourir d’arbre de skills
Le troisième correctif est le plus propre : le comptage des skills passe d’un calcul à la lecture à une dernière valeur connue, plus un recomptage en arrière-plan.
list_profiles(lazy_skill_count=True)renvoie le dernierskill_countconnu ; une entrée jamais comptée ou périmée planifie un_count_skillsen arrière-plan par profile et par fenêtre de revérification de 60 secondes : le thread de la requête ne fait donc aucune I/O sur l’arbre des skills, et la cadence de refresh est découplée du rythme des polls.- C’est le mode utilisé par
GET /api/profiles, la RPCprofiles.listet l’entrée de repli REST. - Le comportement synchrone par défaut ne change pas :
hermes profile list/showetprofiles.describerapportent toujours des chiffres à jour. Le chemin exact n’a pas été sacrifié — seulement celui qui est soumis au poll. - Le comptage lui-même coûte moins cher :
_walk_skill_countutilise désormais le walker du dépôt (agent.skill_utils.iter_skill_index_files, unos.walkavec élagage) au lieu dePath.rglob— environ deux fois moins d’appels au système de fichiers, et un comportement « au mieux » si un sous-arbre disparaît en cours de parcours, au lieu d’interrompre toute l’énumération. - Le TTL du comptage de skills passe de 30 secondes à 600, l’invalidation par signature continuant de rattraper les ajouts et suppressions de skills au refresh suivant.
- Deux autres routes (
/api/profiles/projects/treeet/api/profiles/sessions/pull-requests) ne consommaient jamais que le nom et le chemin, mais payaient le parcours complet delist_profiles(); elles utilisent désormaisprofiles_to_serve, une simple lecture de répertoire.
Deux points à garder en tête
refresh=Trueest censé invalider le cache. Si un modèle dont vous savez qu’il existe manque dans la liste, cliquer sur « Refresh models » est la bonne réaction — pas suspecter un cache cassé.- Les panneaux Profiles du Desktop et du dashboard affichent désormais le dernier nombre de skills connu. Juste après l’installation d’un skill, le chiffre peut retarder d’un cycle de refresh ; c’est voulu, pas un bug. Pour un chiffre en direct, utilisez
hermes profile show <name>.
Pour situer ce travail sur le chemin de lecture, voyez l’article sur la palette de commandes, qui traite de la même interaction « je tape et je filtre instantanément ». La revue et l’installation depuis le catalogue sont expliquées dans le guide du catalogue de plugins et la référence hermes plugins ; pour les configurations multi-profiles, voyez le guide multi-instance des profiles et la référence hermes profile.
État des versions publiées
Les trois PR ont été fusionnées dans main le 18 septembre 2026, et le tag le plus récent est v0.21.3 (nom de tag v2026.9.14, publié le 14 septembre) : rien de tout cela n’est encore dans une version taguée. Vérifiez votre version :
hermes --version
hermes update
La leçon
Trois blocages qui semblent sans rapport, un seul principe : un chemin de lecture doit rester instantané quand le réseau est en panne et que le répertoire est énorme. Trois règles réutilisables en découlent — servir le cache d’abord et rafraîchir derrière (en sérialisant les écritures concurrentes), traiter un échec comme un état digne d’être mémorisé, et remonter le travail répété à la bonne granularité au lieu de le refaire ligne par ligne ou profile par profile. La prochaine fois qu’un panneau « met quelques secondes à s’ouvrir », demandez-vous d’abord : sur ce chemin de lecture, qui touche discrètement au réseau ou parcourt le système de fichiers ?