Eine langsame Disk, ein eingefrorener Assistent: Hermes hat drei blockierende Jobs in den Hintergrund verlegt
Es ist 2 Uhr nachts, dein Hermes-Gateway läuft auf dem NAS, und gerade ist das Backup angelaufen. Du schickst vom Handy ein „bist du da?“ und starrst auf den Spinner. Nichts. Du hältst das Modell für langsam — aber die Maschine schreibt gerade auf die Disk, und jedes Session-Status-Update auf dieser Kiste muss hinter dem vorherigen Block warten. Auf dem Laptop dasselbe Bild: Die Desktop-App ist noch offen, die Lüfter laufen, und im Activity Monitor ist ein CPU-Kern voll ausgelastet. Das ist ein Idle-Poll, der zweimal pro Sekunde nachfragt.
Beide Hänger haben dieselbe Ursache: Arbeit, die in den Hintergrund gehört, stand im Türrahmen. Ein Bündel von Änderungen, gemergt am 18.–20. September (#117206, #117063, #117066, #117201, #117041, #116967), räumt diese Türrahmen auf, und die Lösung ist jedes Mal dieselbe: Lesepfade bleiben lokal, Writes wandern in einen Hintergrund-Thread, Polls laufen in einem festen Takt statt in jeder Loop-Iteration.
Ein Status-Write fror jede eingehende Nachricht ein
write_runtime_status() schreibt den Runtime-Status des Gateways per Read-Merge-Write in gateway/runtime_status.json. Das klingt billig, lief aber synchron im Event Loop — zweimal pro Turn plus einmal bei jedem Adapter-Statuswechsel.
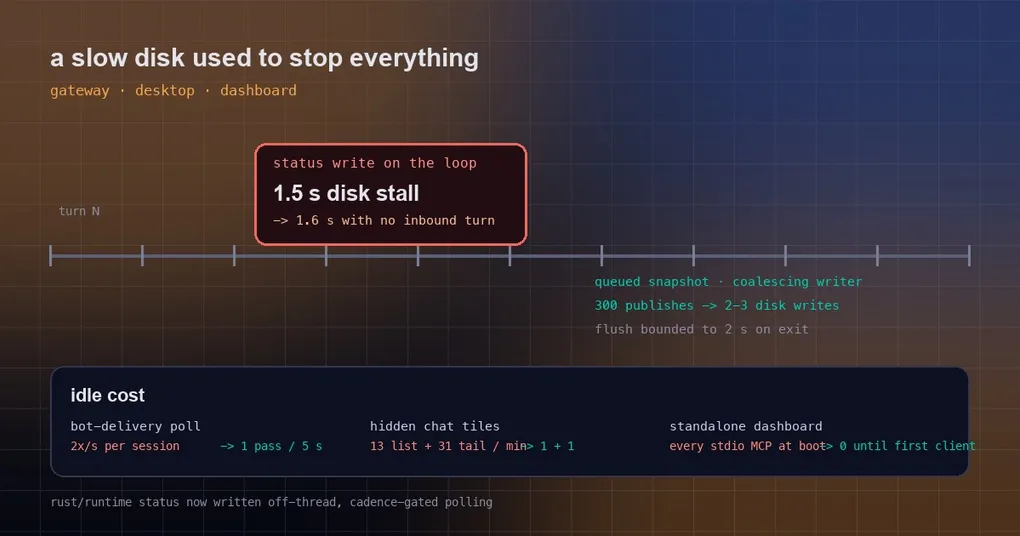
Auf einer langsamen oder umkämpften Disk blockieren diese drei Schritte die gesamte Loop. Die Messung in PR #117206 ist unmissverständlich: Ein Disk-Stall von 1,5 s erzeugte einen Loop-Stall von 1,6 s — und in diesen 1,6 Sekunden steht jede eingehende Nachricht in der Queue, auch das „bist du da?“ vom Handy.
Die Lösung zieht den Write komplett heraus:
- Status-Updates veröffentlichen in einen In-Memory-Snapshot (
publish_runtime_status()) und berühren auf dem Hot Path nie die Disk; - ein koaleszierender Writer-Thread (
_RuntimeStatusWriter) besitzt die Datei und faltet einen Schub von Updates in wenige Writes — gemessen: 300 Publishes kollabieren zu 2-3 Disk-Writes; - Aufrufstellen, die die Bytes wirklich auf der Disk brauchen (Start, Shutdown), nutzen ein begrenztes Warten (
wait_timeout), und der Terminal-Stempel beim Beenden bekommt ein Budget von 2 s, statt unendlich zu blockieren.
Ein Verhalten, das man kennen sollte: Der Writer liest die Datei unmittelbar vor jedem Write erneut und legt seinen Snapshot darüber, sodass von anderen Prozessen geschriebene Felder nicht überschrieben werden (etwa bei hermes gateway migrate --standalone oder einem Container, der beim Boot desired_state setzt). Der Kompromiss ist die Kehrseite des begrenzten Wartens: Hängt die Disk beim Beenden, kann der Stempel „gestoppt“ beim nächsten Boot veraltet sein — dafür hängt das Beenden nicht.
Die Desktop-App: zwei Probes pro Sekunde, und versteckte Tiles, die weiter pollten
hermes serve (das Backend hinter Desktop-App und TUI) betreibt einen Bot-Delivery-Poll. Der einzige blockierende Punkt seiner Loop ist completion_queue.get(timeout=0.5) — das heißt: Jede Loop-Iteration führte eine Delivery-Probe aus, zweimal pro Sekunde und pro Session. Jede Probe lief durch jeden Lease in active_sessions.json und rief psutil auf, um zu prüfen, ob der Prozess noch lebt.
Die Kosten sind Sessions × Leases × 2/s. Die Zahlen aus dem Report: 11 Sessions, 8 Leases, 88 Probes pro Runde bei 102 % eines CPU-Kerns.
PR #117063 legt den Delivery-Poll auf denselben Takt von 5 s wie die /loop-, /heartbeat- und Kanban-Polls und bricht komplett ab, wenn ein Lease zum aktuellen Prozess gehört — keine psutil-Probe auf sich selbst. Die Probes gingen von 10 pro 5 s auf 1 zurück, die psutil-Aufrufe für eigene Leases von rund 80 auf null. Der Short-Circuit behält bewusst den Identitätsvergleich (pid, Prozessstartzeit): Sonst könnte eine recycelte PID, die zufällig deiner entspricht, einen veralteten Lease für immer am Leben halten.
Gleiches Bündel, gleiche Familie: versteckte Keep-alive-Chat-Tiles pollten weiter subagent.list alle 5 s und subagent.tail alle 2 s pro aktivem Subagent. Ihr einziger Schutz war document.visibilityState — und das gesamte Fenster ist sichtbar; Tabs werden mit visibility: hidden versteckt, das Layout bleibt erhalten. Der Guard war also immer wahr. PR #117066 hängt beide Poller an den Pane-Visibility-Kontext und aktiviert sie beim Einblenden neu. Pro verstecktem Tile und Minute sind das „13 List- + 31 Tail-Aufrufe“, reduziert auf „1 + 1“.
hermes dashboard: kein MCP-Spawn-Sturm beim Boot, keine eingefrorene UI bei großer Datenbank
Zwei weitere Hänger stecken in hermes dashboard.
Warm-up beim Boot. Ein eigenständig gestartetes hermes dashboard stieß die MCP-Discovery bisher sofort an — und spawnte jeden konfigurierten stdio-MCP-Server, auch wenn niemand je die UI öffnete. Der Reporter verfolgte das über den Write-Churn in mcp-stderr.log, der auf NAS-/ZFS-Speicher übel auffällt. PR #117201 schärft die Discovery stattdessen nur vor und feuert sie beim ersten /api/ws-Client (oder zieht sie beim ersten Agent-Build vor). Ein vom Desktop gestartetes Dashboard behält seinen eifrigen Start, dort ändert sich nichts.
Eine große state.db blockiert alles. GET /api/sessions/search, /api/sessions/stats und /api/sessions/{id} öffneten SQLite direkt in async def-Handlern. Sobald die Session-Datenbank ein paar hundert Megabyte erreicht, blockiert die FTS5-Query den Event Loop für Sekunden — das Symptom sind eine eingefrorene Sidebar und WebSocket-Wake-Timeouts. PR #117041 leitet die Datenbankarbeit dieser drei Handler durch asyncio.to_thread, passend zu den Geschwister-Handlern im selben Modul. Vorher/Nachher: SQLite-Öffnungen im Loop-Thread über die drei Routen gingen von 3 von 4 auf 0 von 4.
Ist deine Session-Datenbank schon groß, gibt es einen separaten Offline-Lauf, den du heute starten kannst: hermes sessions optimize-storage (mit gestoppten Haltern) baut den FTS-Index neu auf. Dieser Pfad stammt aus dem früheren #65798, nicht aus diesem Bündel.
Database is locked — jetzt nennt das Log den Prozess, der die Sperre hält
Manche Wartezeiten sind harmlos. Eine Write-Sperre, die jemand anderes hält, ist es nicht. Jeder Hermes-Prozess hat state.db offen, also kann ein Scan der offenen Deskriptoren den einen Writer nicht von den Readern unterscheiden — die Timeout-Meldung nach 60 Sekunden konnte nur das Opfer benennen (database is locked (another Hermes process held the state.db write lock for over 60s)), und du hattest keine Ahnung, welchen Prozess du abschießen sollst.
PR #116967 liest unmittelbar vor dem Raise /proc/locks für die Datenbank und ihre -wal- und -shm-Inodes, behält Write-Klasse-Sperren, dekodiert SQLites Byte-Offsets (auf -shm ist 120 ein WAL-Write, 121 ein Checkpoint, 122 ein Recover, 123-127 sind Read-Slots; ein Pending-Byte in der Hauptdatei bedeutet PENDING/RESERVED/SHARED) und ordnet den Halter einer PID zu. Die neue Log-Zeile:
WARNING hermes_state_lockowners: state.db write lock unavailable for 60s (state.db):
PID 594094 (hermes --worktree --yolo) holds WAL write lock on state.db-shm
Zwei Einschränkungen sollte man im Kopf behalten: Das gilt nur unter Linux (es liest /proc/locks), und OFD-Locks exportieren keine PID, weshalb das Log das sagt, statt zu raten. Die Kommandozeile des Halters landet im Log, nicht im Exception-Text — Fehler werden nach Phrase gruppiert, und ein Worktree namens fix-corrupt-db würde den Bucket umwerfen.
Wenn du regelmäßig in Lock-Contention läufst, decken die Beiträge zur state.db-Selbstheilung bei Korruption und zum WAL-Write-Guard die Retry-Budgets und den Reparaturablauf ab.
Updates lassen einen nutzlosen Durchlauf weg
Noch einer aus demselben Bündel, weil er sehr konkret ist: hermes update führte npm ci immer erneut aus, wenn sich die Quellen von Web-UI oder Desktop geändert hatten, und entpackte node_modules doppelt. PR #117110 hängt diese beiden Installationen an denselben Manifests-Digest, der schon den ersten Durchlauf steuerte (plus einer Electron-Präsenzprüfung für den Desktop-Durchlauf). Das Szenario aus dem Report — drei npm-Durchläufe, 117 Sekunden — überspringt jetzt zwei davon, wenn die Lockfile unverändert ist.
Ist davon schon etwas verfügbar?
Ehrlich gesagt: nein. Alle oben genannten Änderungen wurden am 18.–20. September 2026 gemergt, und der neueste Release ist v0.21.3 (Tag v2026.9.14). Sie existieren nur auf main und in keinem Release — hermes update liefert dir weiterhin das alte Verhalten. Du kannst auf den nächsten Release warten oder selbst von main bauen. Um zu sehen, auf welchem Codepfad du heute bist:
hermes --version                          # welcher Release gerade läuft
hermes sessions optimize-storage          # Offline-FTS-Rebuild für eine große state.db
Das Muster
Liest man die sechs Änderungen zusammen, behandeln sie eine Krankheit: I/O auf dem kritischen Pfad. Ein Status-Write, eine Prozess-Probe, ein Warm-up beim Start, eine SQLite-Query, eine npm-Installation — jede sieht allein harmlos aus, aber alles, was zwischen Hermes und „die nächste Nachricht bearbeiten“ steht, liest sich für den Nutzer als „Hermes ist langsam“. Ein schneller Test für jede Hintergrundaufgabe, die du auf der Main Loop lassen willst: Braucht sie das Netzwerk oder eine Disk? Wartet sie auf etwas, worauf sie nicht warten müsste? Könnte sie in einem festen Takt laufen? Ein einziges „ja“, und sie gehört in den Hintergrund.
Wenn dich eher der Stall auf der Leseseite nervt — ein Picker, der dreht, eine Liste, die hängt —, dann steht diese Geschichte im Beitrag zum Read-Path-Cache; für die Live-Ansicht laufender Kinder im Desktop siehe Subagents mitten im Flug steuern.