把 Hermes Agent 跑在 Kubernetes 上:没有官方 Helm chart,副本数必须是 1,容器开机要先当 root
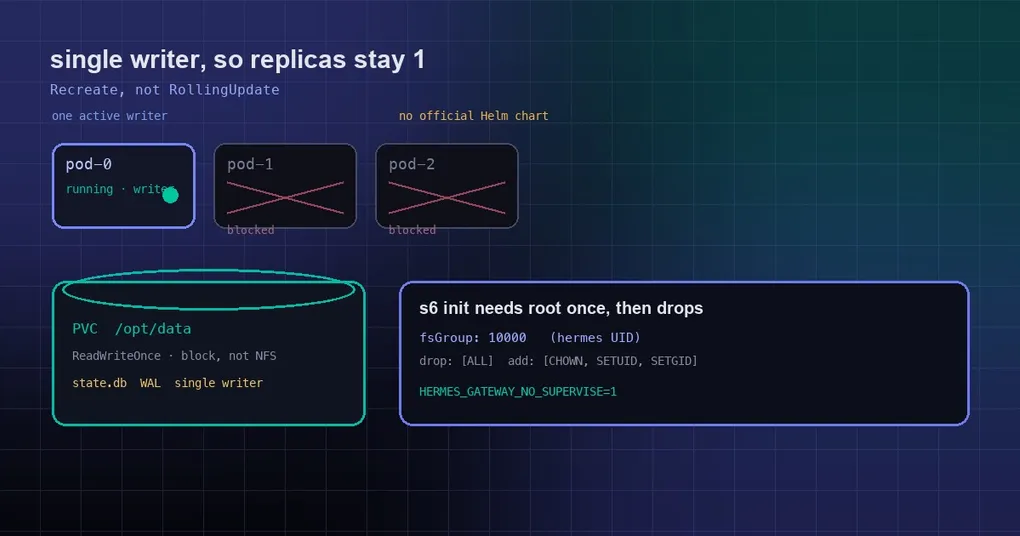
你在笔记本上把 Hermes 调顺手了,记忆、技能、定时任务都跑起来了。然后你把它搬进集群,写了一份看起来很标准的 Deployment:replicas: 3、滚动更新、runAsNonRoot: true、把数据挂在 NFS 上。Pod 起来了,然后开始出各种奇怪的毛病——会话记录对不上、启动直接退出、改了 ConfigMap 却死活不生效。
Hermes 不是不能跑在 Kubernetes 上,而是它的容器里有几处和 Kubernetes 默认姿势正面冲突的设计。这些冲突在官方 Docker 文档里其实都写了,只是没人告诉你在 K8s 语境下哪一句最重要。下面按“会真的出事”的顺序讲。
第一条铁律:一个 HERMES_HOME 只能有一个写者
先记住一件事:Hermes 的可变状态全部在 HERMES_HOME 下——配置、记忆文件、技能,以及用本地 SQLite 保存的会话历史。官方镜像里这个目录是 /opt/data,Docker 文档称它是“所有 Hermes 状态的唯一真相来源”。
官方文档里有一句非常直白的话:永远不要同时让两个 Hermes gateway 容器指向同一个数据目录,会话文件和记忆存储不是为并发写入设计的。同一页也解释了为什么——gateway 的 PID 文件和 systemd 服务名都由 HERMES_HOME 决定,它本身就是隔离单位。
翻译成 Kubernetes 的话:
replicaCount恒等于 1(持久化打开时);- 更新策略必须是
Recreate,不能是RollingUpdate——滚动更新会刻意让新旧两个 Pod 同时活着,那正是你要避免的双写窗口; - PVC 建议用
ReadWriteOnce。RWX不是自动就有罪(真正的不变量是“同时只有一个活跃写者”),但RWO由存储层替你兜底,比信任自己的部署配置更可靠。
想要多租户?那就是一个租户一个 release,各自一个卷,不是给同一个 release 加副本。
第二条:别把 SQLite 放在跨虚拟机的网络盘上
这条比副本数更容易被忽略,因为它的失败是静默的。Hermes 的 state.db 默认以 SQLite 的 WAL 模式打开,WAL 依赖共享内存文件(state.db-shm)在所有打开它的进程之间保持一致。跨虚拟机边界的挂载——macOS 上的 virtiofs、Windows 上的 9p / drvfs——会让并发写者悄悄把 WAL 数据库写坏,而主文件仍然能通过完整性检查。
在集群里对应的就是 NFS / CIFS 这类网络存储类。稳妥的做法是给数据卷用集群本地的块存储(各云厂商的 SSD 块设备类),或者退一步,按这篇教程把日志模式改成 DELETE 并固定下来。不要把“能挂上”当成“能用”。
第三条:容器启动时确实是 root,但 agent 不是
“官方镜像必须跑 root”这句话是错的,但错得不够精确,而精确的版本决定了你能不能说服平台团队给一个安全策略豁免。
官方镜像用 s6-overlay 做初始化。它的 /init 以 root 启动,好在第一次启动时给数据卷 chown,随后通过 s6-setuidgid 把主程序和所有被监管的服务降权到 hermes 用户。镜像里还带了一个 shim,检测到 docker exec 是 root 调用时会自动用 s6-setuidgid hermes 重新执行。
所以真正以 root 跑的只有引导阶段,agent 本身不是。但这足以让受限安全上下文直接崩掉:带 runAsNonRoot: true 或非零 runAsUser 的 Pod 会在 agent 起来之前就失败,日志里大概是这样:
/package/admin/s6-overlay/libexec/preinit: fatal: /run belongs to uid 0 instead of 1000,
has insecure and/or unworkable permissions, and we're lacking the privileges to fix it.
s6-overlay-suexec: fatal: child failed with exit code 100有一个很多示例都写错的细节:hermes 用户的 UID 是 10000,不是 1000。镜像里是 useradd -u 10000 -m -d /opt/data hermes,而且没有 USER 指令——容器按设计以 root 启动,自己降权。你要是设 fsGroup: 1000,卷的属组就是错的。
一个可用的起点是这样(能力列表请当成“待验证清单”,不同镜像版本 s6 的需求会变):
podSecurityContext:
  runAsUser: 0
  runAsNonRoot: false
  fsGroup: 10000
  fsGroupChangePolicy: OnRootMismatch
  seccompProfile:
    type: RuntimeDefault
containers:
  - name: hermes
    securityContext:
      allowPrivilegeEscalation: true
      readOnlyRootFilesystem: false
      runAsNonRoot: false
      capabilities:
        drop: ["ALL"]
        add: ["CHOWN", "SETUID", "SETGID"]
这已经比特权 Pod 窄得多:所有能力先丢掉,只把引导确实需要的加回来。如果你的集群强制 restricted 级别的 Pod 安全标准,这个工作负载需要命名空间级豁免——这不是你漏配了某个开关,而是镜像本来就不是为“非 root 启动”设计的。
第四条:PID 1 被平台包走时,s6 监管会静默失效
镜像的入口是一个分发脚本,而 s6-overlay 的 suexec 要求自己必须是 PID 1。当平台在入口外面又套了一层 init,上游文档明确提到的路径是:分发脚本会直接跑第二阶段引导并 exec 主 wrapper,不带 s6。文档点名的场景包括 docker run --init 和“某些 Nomad / Kubernetes 配置”。
对你要紧的是两点:
- 如果你的技术栈里有人注入 init 进程——
shareProcessNamespace: true的 Pod、某些 sidecar 注入器、给容器加 init 的运行时——你会悄悄失去 s6 的进程监管。agent 照跑,只是不再由 s6 负责重启它。 - 这未必是坏事:在集群里你本来就希望由 Kubernetes 的重启策略当监管者,而不是容器内部的进程管理器。但故障模型变了,所以你要知道自己在哪条路径上。想明确要“无 s6”的行为,就用
--no-supervise或设HERMES_GATEWAY_NO_SUPERVISE=1说出来,别靠平台的 PID 1 行为碰运气。这两个开关在 s6 镜像之外是空操作。
第五条:改配置没有 HTTP 接口可以调
这是 GitOps 流程里最别扭的一点。Hermes 在会话里提供 /reload-mcp(按 config.yaml 重新加载 MCP server)和 /reload-skills(重新扫描技能目录),但在 API Server 侧没有等价的 HTTP 端点。社区的功能请求 issue #52417 到今天仍然是 open 状态,优先级 P3。
所以当你的流水线更新了 ConfigMap,没有原生的 reconciliation 钩子可用。现实的选择只有两个:要么想办法驱动运行时的重载路径(在会话里执行对应的斜杠命令),要么干脆滚动重启工作负载——而重启又回到前面那条“Recreate 而不是 RollingUpdate“的约束上。
顺便说清楚:官方没有 Helm chart
上游文档覆盖了 install.sh、Docker、Docker Compose 和 Nix 包,Kubernetes 从来不是它承诺的部署目标。想让官方出打包方案的功能请求(Dockerfile、Helm chart、RBAC、冒烟测试一整套)是 issue #85474,2026 年 8 月创建,目前仍然 open。
社区里有一些第三方尝试,比如 ultraworkers/hermes-agent-helm-chart(约 140 星,最近一次推送停留在 4 月),以及若干个人写的 operator。它们都不是 Nous Research 维护的,chart 版本和 Hermes 版本各自独立演进。要用就通读模板、自己覆盖安全上下文,并把前面四条约束当成自己的验收清单——第三方 chart 里任何一条没写死,都是数据损坏的隐患。
一份最小可用的部署清单
- 一个 release 一个 PVC,
ReadWriteOnce,挂到/opt/data; replicas: 1、strategy.type: Recreate;- 数据卷落在集群本地块存储上,不要 NFS;
- 接受引导阶段的 root,
fsGroup: 10000,能力先全丢再加回CHOWN/SETUID/SETGID; - 想清楚自己要不要 s6 监管,然后显式用
--no-supervise或HERMES_GATEWAY_NO_SUPERVISE=1表态; - 配置变更靠重启或会话内斜杠命令,不要指望有 HTTP 重载接口;
- 资源按官方 Docker 文档的建议起步,浏览器自动化(Playwright/Chromium)是最吃内存的功能,给它留足余量。
小结
Hermes 在 Kubernetes 上能跑得很稳,前提是承认它是个单写者的有状态服务,而不是无状态的 12-factor 应用。把这四条约束(单写者、本地块存储、引导期 root、无 HTTP 重载)写进你的 manifest 和团队文档,剩下的部分和任何一个有状态工作负载没太大区别。
如果你还在 Docker 单机阶段,先看共享容器的多 Profile 方案会更省事;装机的第一步见安装指南。