Ejecutar Hermes Agent en Kubernetes: sin Helm chart oficial, una sola réplica y un contenedor que arranca como root
Tienes Hermes funcionando de maravilla en tu portátil: memoria, skills, cron jobs y todo lo demás. Ahora lo estás mudando a un clúster, así que escribes un Deployment totalmente razonable: replicas: 3, actualizaciones rolling, runAsNonRoot: true, los datos en NFS. Los pods arrancan y entonces empieza el comportamiento raro. El historial de sesiones no cuadra. Los contenedores salen al arrancar. Cambias un ConfigMap y no pasa nada.
Hermes funciona bien en Kubernetes, en cuanto aceptas que unas cuantas cosas de su contenedor chocan de frente con los valores por defecto estándar de un clúster. La documentación oficial de Docker ya las describe; lo que no hace es decirte qué frase importa en un contexto de Kubernetes. Aquí van, en el orden en que de verdad te van a morder.
Regla uno: un HERMES_HOME, un escritor
Empecemos por el hecho del que cuelga todo lo demás: todo el estado mutable de Hermes vive bajo HERMES_HOME — config, archivos de memoria, skills e historial de sesiones en una base de datos SQLite local. En la imagen oficial eso es /opt/data, que la documentación de Docker llama la única fuente de verdad de todo el estado de Hermes.
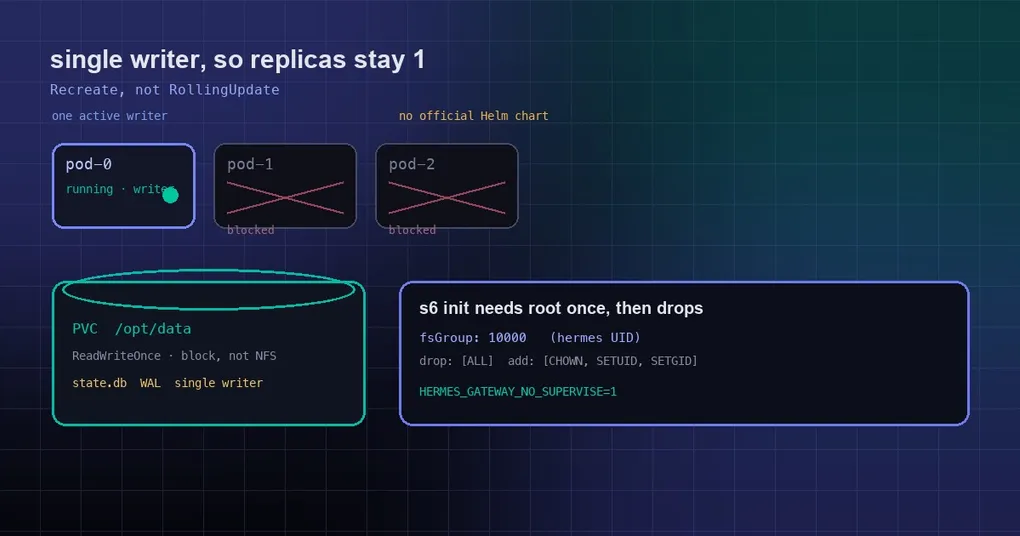
Luego la documentación dice algo sin rodeos: nunca ejecutes dos contenedores de gateway de Hermes contra el mismo directorio de datos a la vez — los archivos de sesión y los almacenes de memoria no están hechos para escrituras concurrentes. La misma página explica por qué: el archivo PID del gateway y el nombre del servicio systemd están ambos acotados por HERMES_HOME, que es la propia señal de upstream de que esa es la unidad de aislamiento.
Traducido a términos de Kubernetes:
replicaCountse queda en 1 siempre que la persistencia esté activada;- la estrategia de actualización debe ser
Recreate, nuncaRollingUpdate— una actualización rolling ejecuta a propósito el pod viejo y el nuevo al mismo tiempo, que es exactamente la ventana de dos escritores que intentas evitar; - prefiere
ReadWriteOnceen el PVC.RWXno es automáticamente inseguro — el invariante real es un solo escritor activo, no un solo montaje — peroRWOlo impone en la capa de almacenamiento en vez de confiar en tu manifiesto.
¿Necesitas más de un equipo? Eso es un release por tenant, cada uno con su propio volumen, no más réplicas por release.
Regla dos: mantén SQLite fuera de un sistema de archivos en red entre VMs
Esta se pasa por alto más a menudo que el número de réplicas, porque falla en silencio. Hermes abre state.db en modo SQLite WAL por defecto, y WAL depende de que un archivo de memoria compartida (state.db-shm) se mantenga coherente entre todos los procesos que tienen la base de datos abierta. Los montajes que cruzan una frontera de VM — virtiofs en macOS, 9p / drvfs en Windows — dejan que escritores concurrentes corrompan en silencio una base de datos WAL mientras el archivo principal aún pasa una comprobación de integridad.
En un clúster, el equivalente es una storage class NFS o CIFS. Usa almacenamiento en bloque local al nodo (las clases de bloque SSD de la nube) para el volumen de datos; si no puedes, sigue la receta de esta guía para convertir el modo de journal a DELETE y fijarlo. No trates “el montaje funciona” como “la base de datos está a salvo”.
Regla tres: el contenedor sí arranca como root — el agente no
Decir “la imagen oficial tiene que ejecutarse como root” es incorrecto, pero es impreciso de una forma que importa cuando estás discutiendo con un equipo de plataforma sobre una excepción al Pod Security Standard.
La imagen usa s6-overlay como sistema de init. Su /init corre como root para poder hacer chown del volumen en el primer arranque, y luego baja al usuario hermes mediante s6-setuidgid para el programa principal y cada servicio supervisado. La imagen incluso incluye un shim que detecta llamadas como root en docker exec y se re-ejecuta a través de s6-setuidgid hermes.
Así que solo el bootstrap es root; el agente no. Aun así basta para romper un security context restringido: un pod con runAsNonRoot: true o un runAsUser distinto de cero falla antes de que el agente llegue a arrancar, con algo como:
/package/admin/s6-overlay/libexec/preinit: fatal: /run belongs to uid 0 instead of 1000,
has insecure and/or unworkable permissions, and we're lacking the privileges to fix it.
s6-overlay-suexec: fatal: child failed with exit code 100
Un detalle que los ejemplos publicados suelen equivocar: el usuario hermes es UID 10000, no 1000. La imagen lo crea con useradd -u 10000 -m -d /opt/data hermes y no define ninguna instrucción USER — el contenedor arranca como root por diseño y baja privilegios por sí mismo. Pon fsGroup: 1000 y tu volumen acaba siendo de un grupo equivocado.
Un punto de partida viable (trata la lista de capabilities como una checklist, porque las necesidades de s6 cambian entre versiones de la imagen):
podSecurityContext:
  runAsUser: 0
  runAsNonRoot: false
  fsGroup: 10000
  fsGroupChangePolicy: OnRootMismatch
  seccompProfile:
    type: RuntimeDefault
containers:
  - name: hermes
    securityContext:
      allowPrivilegeEscalation: true
      readOnlyRootFilesystem: false
      runAsNonRoot: false
      capabilities:
        drop: ["ALL"]
        add: ["CHOWN", "SETUID", "SETGID"]
Eso es bastante más estrecho que un pod privilegiado: quita todo y vuelve a añadir solo lo que el bootstrap necesita. Si tu clúster aplica el Pod Security Standard restricted, esta carga de trabajo necesita una excepción de namespace — no te has perdido ningún ajuste, simplemente la imagen no se construyó para arrancar como no-root.
Regla cuatro: cuando la plataforma envuelve el PID 1, la supervisión de s6 se queda muda
El entrypoint de la imagen es un dispatcher, y el suexec de s6-overlay requiere ser PID 1. Cuando una plataforma envuelve el entrypoint bajo su propio init, la ruta documentada por upstream es que el dispatcher ejecute directamente el bootstrap de la stage two y haga exec del wrapper principal sin s6. La documentación señala docker run --init y “algunas configuraciones de Nomad/Kubernetes” como los casos que caen en esto.
Importan dos consecuencias:
- Si algo en tu stack inyecta un proceso init — un pod con
shareProcessNamespace: true, ciertos inyectores de sidecar, un runtime configurado para añadir uno — pierdes la supervisión de s6 en silencio. El agente sigue corriendo; simplemente ya no lo reinicia s6. - Eso no es necesariamente malo. En un clúster normalmente quieres que la política de reinicio de Kubernetes sea el supervisor en lugar de un gestor de procesos dentro del contenedor. Pero el modelo de fallos cambia, así que ten claro en qué camino estás. Si quieres el comportamiento sin s6 a propósito, pídelo con
--no-superviseoHERMES_GATEWAY_NO_SUPERVISE=1en vez de depender de un accidente del manejo del PID 1. Ambos son no-ops fuera de la imagen con s6.
Regla cinco: los cambios de config no tienen endpoint HTTP de recarga
Esta es la incómoda para GitOps. Hermes te da /reload-mcp (recarga los servidores MCP desde config.yaml) y /reload-skills (vuelve a escanear el directorio de skills) dentro de una conversación, pero el servidor de API no expone ningún endpoint HTTP equivalente. La petición de función de la comunidad para exactamente eso, el issue #52417, sigue abierta con prioridad baja.
Así que cuando tu pipeline actualiza un ConfigMap, no hay ningún hook de reconciliación nativo. Tus opciones realistas son accionar la ruta de recarga del runtime (ejecutar el slash command en una sesión) o reiniciar la carga de trabajo — y reiniciar te devuelve justo a la restricción de Recreate, no RollingUpdate.
Y sí: no hay Helm chart oficial
La documentación de upstream cubre install.sh, Docker, Docker Compose y paquetes Nix. Kubernetes simplemente no es un destino de despliegue prometido, y la petición de función para una historia de empaquetado oficial — Dockerfile, Helm chart, RBAC y smoke tests de una vez — es el issue #85474, abierto en agosto de 2026 y todavía abierto.
Existen intentos de la comunidad, como ultraworkers/hermes-agent-helm-chart (unos 140 stars, último push en abril), más unos pocos operators personales. Ninguno está mantenido por Nous Research, y las versiones de los charts se mueven independientemente de Hermes. Si usas uno, lee las plantillas de principio a fin, sobrescribe tú mismo el security context y compruébalo contra las cinco reglas de arriba — que falte una sola en silencio es un riesgo de corrupción de datos esperando un rollout malo.
Checklist de un despliegue mínimo
- Un release, un PVC,
ReadWriteOnce, montado en/opt/data; replicas: 1ystrategy.type: Recreate;- el volumen de datos en almacenamiento en bloque local al nodo, nunca NFS;
- acepta root en el bootstrap, usa
fsGroup: 10000, quita todas las capabilities y vuelve a añadir soloCHOWN,SETUID,SETGID; - decide a propósito si quieres supervisión de s6, y dilo con
--no-superviseoHERMES_GATEWAY_NO_SUPERVISE=1; - trata los cambios de config como reinicio o slash command, nunca como recarga en caliente por HTTP;
- dimensiona los recursos según la guía oficial de Docker y deja margen para la automatización de navegador (Playwright/Chromium), que es lo que más recursos consume de todo lo que hace Hermes.
La versión corta
Hermes corre estable en Kubernetes siempre que lo trates como un servicio con estado de un solo escritor, no como una app sin estado doce factor. Escribe esas restricciones en tus manifiestos y en los docs de tu equipo — un solo escritor, almacenamiento local al nodo, root en el bootstrap, sin recarga por HTTP — y el resto es como cualquier otra carga de trabajo con estado.
Si todavía estás en un solo host Docker, compartir un contenedor entre profiles es menos trabajo. Y si aún no lo has instalado, empieza por la guía de instalación.