Hermes Agent auf Kubernetes betreiben: kein offizielles Helm chart, eine Replica und ein Container, der als root startet
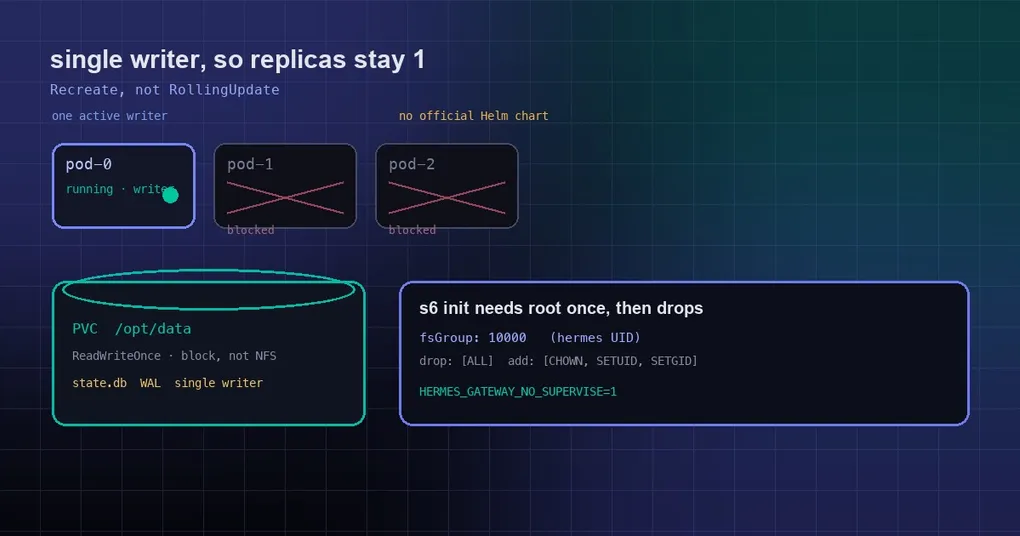
Du hast Hermes auf deinem Laptop schön zum Laufen gebracht – Memory, Skills, Cron-Jobs, das ganze Programm. Jetzt ziehst du es in einen Cluster um und schreibst ein völlig vernünftiges Deployment: replicas: 3, Rolling Updates, runAsNonRoot: true, Daten auf NFS. Die Pods starten, und dann beginnt das seltsame Verhalten. Die Session-History passt nicht zusammen. Container beenden sich beim Boot. Du änderst eine ConfigMap und nichts passiert.
Hermes läuft problemlos auf Kubernetes – sobald du akzeptierst, dass ein paar Dinge in seinem Container frontal mit den Standard-Defaults eines Clusters kollidieren. Die offizielle Docker-Doku beschreibt sie bereits; sie sagt dir nur nicht, welcher Satz im Kubernetes-Kontext zählt. Hier kommen sie in der Reihenfolge, in der sie dich tatsächlich beißen werden.
Regel eins: ein HERMES_HOME, ein Writer
Fangen wir mit dem Fakt an, an dem alles andere hängt: Der gesamte veränderliche Hermes-State liegt unter HERMES_HOME – Config, Memory-Dateien, Skills und Session-History in einer lokalen SQLite-Datenbank. Im offiziellen Image ist das /opt/data, das die Docker-Doku als einzige Quelle der Wahrheit für den gesamten Hermes-State bezeichnet.
Die Doku sagt dann etwas unverblümt: Betreibe niemals zwei Hermes-Gateway-Container gleichzeitig auf demselben Datenverzeichnis – Session-Dateien und Memory-Stores sind nicht für gleichzeitige Schreibzugriffe gebaut. Dieselbe Seite erklärt auch warum: Die PID-Datei des Gateways und der systemd-Service-Name sind beide auf HERMES_HOME beschränkt, was das eigene Signal des Upstreams dafür ist, dass dies die Einheit der Isolation ist.
In Kubernetes-Begriffe übersetzt:
replicaCountbleibt bei 1, sobald Persistenz aktiv ist;- die Update-Strategie muss
Recreatesein, niemalsRollingUpdate– ein Rolling Update betreibt absichtlich den alten und den neuen Pod gleichzeitig, was genau das Zwei-Writer-Fenster ist, das du vermeiden willst; - bevorzuge
ReadWriteOncebeim PVC.RWXist nicht automatisch unsicher – die eigentliche Invariante ist ein aktiver Writer, nicht ein Mount – aberRWOerzwingt sie auf der Storage-Ebene, statt deinem Manifest zu vertrauen.
Brauchst du mehr als ein Team? Dann gilt: ein Release pro Tenant, jedes mit eigenem Volume, nicht mehr Replicas pro Release.
Regel zwei: Halte SQLite von einem VM-übergreifenden Netzwerk-Dateisystem fern
Dieser Punkt wird häufiger übersehen als Replica-Zahlen, weil er still fehlschlägt. Hermes öffnet state.db standardmäßig im SQLite-WAL-Modus, und WAL hängt davon ab, dass eine Shared-Memory-Datei (state.db-shm) zwischen allen Prozessen, die die Datenbank offen halten, konsistent bleibt. Mounts, die eine VM-Grenze überschreiten – virtiofs unter macOS, 9p / drvfs unter Windows – lassen gleichzeitige Writer eine WAL-Datenbank still korrumpieren, während die Hauptdatei noch einen Integritätscheck besteht.
In einem Cluster ist das Äquivalent eine NFS- oder CIFS-Storage-Class. Nutze Block-Storage, der lokal am Node hängt (die SSD-Block-Klassen der Cloud), für das Daten-Volume; wenn das nicht geht, folge dem Rezept in diesem Leitfaden, um den Journal-Modus auf DELETE umzustellen und ihn festzuschreiben. Behandle „der Mount funktioniert“ nicht als „die Datenbank ist sicher“.
Regel drei: Der Container startet tatsächlich als root – der Agent nicht
Zu sagen „das offizielle Image muss als root laufen“ ist falsch, aber es ist auf eine Weise ungenau, die zählt, wenn du mit einem Platform-Team über eine Ausnahme vom Pod Security Standard diskutierst.
Das Image nutzt s6-overlay als Init-System. Sein /init läuft als root, damit es das Volume beim ersten Boot chownen kann, und fällt dann über s6-setuidgid auf den hermes-User zurück – für das Hauptprogramm und jeden überwachten Service. Das Image liefert sogar einen Shim mit, der root-Aufrufer bei docker exec erkennt und über s6-setuidgid hermes neu ausführt.
Nur der Bootstrap ist also root; der Agent nicht. Das reicht trotzdem, um einen eingeschränkten Security-Context zu brechen: Ein Pod mit runAsNonRoot: true oder einer runAsUser ungleich null scheitert, bevor der Agent überhaupt startet – mit etwas wie:
/package/admin/s6-overlay/libexec/preinit: fatal: /run belongs to uid 0 instead of 1000,
has insecure and/or unworkable permissions, and we're lacking the privileges to fix it.
s6-overlay-suexec: fatal: child failed with exit code 100
Ein Detail, das veröffentlichte Beispiele regelmäßig falsch machen: Der hermes-User hat UID 10000, nicht 1000. Das Image legt ihn mit useradd -u 10000 -m -d /opt/data hermes an und setzt keine USER-Instruktion – der Container startet absichtlich als root und gibt die Privilegien selbst ab. Setzt du fsGroup: 1000, gehört dein Volume der falschen Gruppe.
Ein brauchbarer Ausgangspunkt (behandle die Capability-Liste als Checkliste, da sich die Bedürfnisse von s6 zwischen Image-Versionen verschieben):
podSecurityContext:
  runAsUser: 0
  runAsNonRoot: false
  fsGroup: 10000
  fsGroupChangePolicy: OnRootMismatch
  seccompProfile:
    type: RuntimeDefault
containers:
  - name: hermes
    securityContext:
      allowPrivilegeEscalation: true
      readOnlyRootFilesystem: false
      runAsNonRoot: false
      capabilities:
        drop: ["ALL"]
        add: ["CHOWN", "SETUID", "SETGID"]
Das ist deutlich enger gefasst als ein privilegierter Pod: alles droppen, nur das zurückgeben, was der Bootstrap braucht. Wenn dein Cluster den restricted Pod Security Standard erzwingt, braucht dieser Workload eine Namespace-Ausnahme – du hast keine Einstellung übersehen, das Image wurde einfach nicht dafür gebaut, als non-root zu starten.
Regel vier: Wenn die Plattform PID 1 umhüllt, wird die s6-Supervision still
Der Entrypoint des Images ist ein Dispatcher, und das suexec von s6-overlay erfordert, PID 1 zu sein. Wenn eine Plattform den Entrypoint unter ihren eigenen Init hüllt, ist der dokumentierte Pfad des Upstreams, dass der Dispatcher den Stage-Two-Bootstrap direkt ausführt und den Main-Wrapper ohne s6 exect. Die Doku nennt docker run --init und „manche Nomad/Kubernetes-Setups“ als die Fälle, die das treffen.
Zwei Konsequenzen sind wichtig:
- Wenn etwas in deinem Stack einen Init-Prozess injiziert – ein Pod mit
shareProcessNamespace: true, bestimmte Sidecar-Injectoren, eine Runtime, die einen hinzufügen soll –, verlierst du still die s6-Supervision. Der Agent läuft weiter; er wird nur nicht mehr von s6 neu gestartet. - Das ist nicht zwangsläufig schlecht. In einem Cluster willst du in der Regel, dass die Restart-Policy von Kubernetes der Supervisor ist und nicht ein Process Manager im Container. Aber das Fehlermodell ändert sich, also wisse, auf welchem Pfad du bist. Willst du das No-s6-Verhalten bewusst, fordere es mit
--no-superviseoderHERMES_GATEWAY_NO_SUPERVISE=1an, statt dich auf einen Zufall der PID-1-Behandlung zu verlassen. Beides ist außerhalb des s6-Images ein No-op.
Regel fünf: Config-Änderungen haben keinen HTTP-Reload-Endpoint
Das ist der unangenehme Punkt für GitOps. Hermes gibt dir /reload-mcp (lädt MCP-Server aus config.yaml neu) und /reload-skills (scannt das Skills-Verzeichnis neu) innerhalb einer Konversation, aber der API-Server stellt keinen äquivalenten HTTP-Endpoint bereit. Der Community-Feature-Request genau dafür, Issue #52417, ist weiterhin offen – bei niedriger Priorität.
Wenn deine Pipeline also eine ConfigMap aktualisiert, gibt es keinen nativen Reconciliation-Hook. Deine realistischen Optionen sind, den Runtime-Reload-Pfad zu fahren (den Slash-Befehl in einer Session ausführen) oder den Workload neu zu starten – und ein Neustart bringt dich direkt zur Einschränkung Recreate, nicht RollingUpdate, zurück.
Und ja: Es gibt kein offizielles Helm chart
Die Upstream-Doku behandelt install.sh, Docker, Docker Compose und Nix-Pakete. Kubernetes ist schlicht kein zugesagtes Deployment-Ziel, und der Feature-Request für eine offizielle Packaging-Story – Dockerfile, Helm chart, RBAC und Smoke-Tests in einem Rutsch – ist Issue #85474, eröffnet im August 2026 und weiterhin offen.
Es gibt Community-Versuche, etwa ultraworkers/hermes-agent-helm-chart (rund 140 Stars, zuletzt im April gepusht), sowie ein paar persönliche Operatoren. Keiner davon wird von Nous Research gepflegt, und Chart-Versionen entwickeln sich unabhängig von Hermes. Wenn du einen nutzt, lies die Templates von Anfang bis Ende, überschreibe den Security-Context selbst und prüfe ihn gegen die fünf Regeln oben – jede einzelne, die still fehlt, ist ein Datenkorruptions-Risiko, das auf ein schlechtes Rollout wartet.
Eine minimale Deployment-Checkliste
- ein Release, ein PVC,
ReadWriteOnce, gemountet unter/opt/data; replicas: 1undstrategy.type: Recreate;- das Daten-Volume auf node-lokalem Block-Storage, niemals NFS;
- akzeptiere root beim Bootstrap, nutze
fsGroup: 10000, droppe alle Capabilities und gib nurCHOWN,SETUID,SETGIDzurück; - entscheide bewusst, ob du s6-Supervision willst, und sag es mit
--no-superviseoderHERMES_GATEWAY_NO_SUPERVISE=1; - behandle Config-Änderungen als Neustart-oder-Slash-Befehl, niemals als Hot Reload über HTTP;
- dimensioniere Ressourcen nach der offiziellen Docker-Empfehlung und lass Luft für Browser-Automation (Playwright/Chromium), das Hungrigste, was Hermes tut.
Die Kurzfassung
Hermes läuft stabil auf Kubernetes, solange du es als Single-Writer-Stateful-Service behandelst und nicht als zustandslose Twelve-Factor-App. Schreibe diese Einschränkungen in deine Manifeste und in die Doku deines Teams – Single Writer, node-lokaler Storage, root beim Bootstrap, kein HTTP-Reload –, dann ist der Rest wie bei jedem anderen Stateful Workload.
Wenn du noch auf einem einzelnen Docker-Host unterwegs bist, ist einen Container über Profile hinweg teilen weniger Arbeit. Und wenn du es noch nicht installiert hast, fang mit dem Installationsleitfaden an.