Faire tourner Hermes Agent sur Kubernetes : pas de Helm chart officiel, un seul replica, et un conteneur qui démarre en root
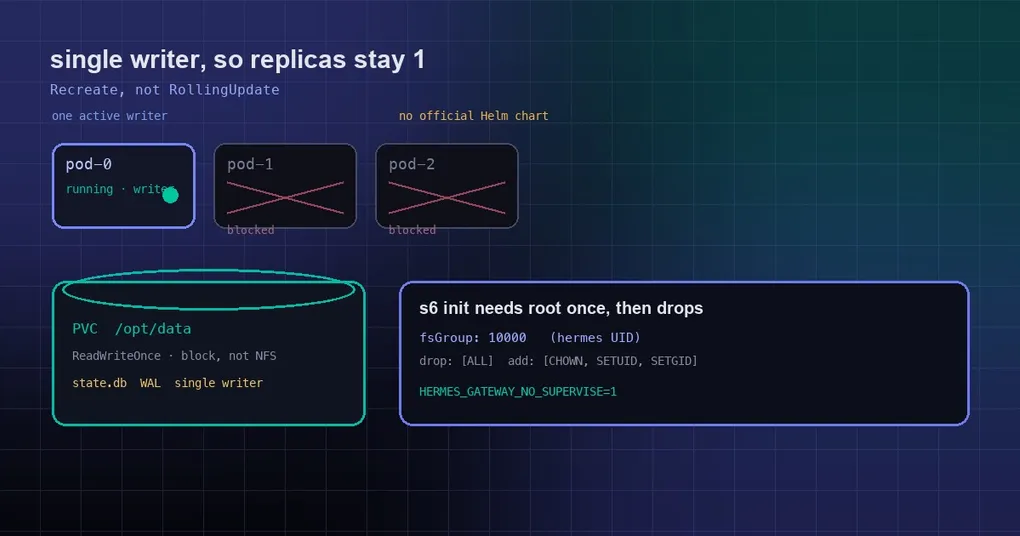
Vous avez réussi à faire tourner Hermes proprement sur votre portable — mémoire, skills, cron jobs, tout y est. Maintenant vous le déplacez dans un cluster, alors vous écrivez un Deployment parfaitement raisonnable : replicas: 3, mises à jour progressives, runAsNonRoot: true, données sur NFS. Les Pods démarrent, et c’est là que les bizarreries commencent. L’historique des sessions ne concorde pas. Les conteneurs s’arrêtent au boot. Vous modifiez une ConfigMap et rien ne se passe.
Hermes tourne très bien sur Kubernetes — à condition d’accepter que quelques éléments de son conteneur entrent frontalement en collision avec les valeurs par défaut d’un cluster. La documentation Docker officielle les décrit déjà ; ce qu’elle ne fait pas, c’est vous dire quelle phrase compte dans un contexte Kubernetes. Les voici, dans l’ordre où elles vont réellement vous mordre.
Règle un : un seul HERMES_HOME, un seul writer
Commençons par le fait dont tout le reste découle : tout l’état modifiable de Hermes vit sous HERMES_HOME — config, fichiers de mémoire, skills, et historique de session dans une base SQLite locale. Dans l’image officielle, c’est /opt/data, que la doc Docker présente comme la seule source de vérité pour tout l’état de Hermes.
La doc ajoute ensuite quelque chose de très direct : ne faites jamais tourner deux conteneurs de gateway Hermes sur le même répertoire de données en même temps — les fichiers de session et les stores de mémoire ne sont pas conçus pour des écritures concurrentes. La même page explique pourquoi : le fichier PID de la gateway et le nom du service systemd sont tous deux cadrés par HERMES_HOME, ce qui est le signal d’upstream lui-même : c’est l’unité d’isolation.
Traduit en termes Kubernetes :
replicaCountreste à 1 dès que la persistance est activée ;- la stratégie de mise à jour doit être
Recreate, jamaisRollingUpdate— une rolling update fait délibérément tourner l’ancien et le nouveau pod en même temps, soit exactement la fenêtre à deux writers que vous cherchez à éviter ; - préférez
ReadWriteOncesur le PVC.RWXn’est pas forcément dangereux — le vrai invariant, c’est un seul writer actif, pas un seul montage — maisRWOl’impose au niveau du stockage au lieu de faire confiance à votre manifest.
Besoin de plus d’une équipe ? C’est une release par tenant, chacune avec son propre volume, pas plus de replicas par release.
Règle deux : gardez SQLite hors d’un système de fichiers réseau inter-VM
Cette règle passe plus souvent à la trappe que le nombre de replicas, parce qu’elle échoue en silence. Hermes ouvre state.db en mode WAL de SQLite par défaut, et le WAL dépend d’un fichier de mémoire partagée (state.db-shm) qui doit rester cohérent entre tous les processus qui gardent la base ouverte. Les montages qui franchissent une frontière de VM — virtiofs sur macOS, 9p / drvfs sur Windows — laissent des writers concurrents corrompre silencieusement une base WAL alors que le fichier principal passe encore un contrôle d’intégrité.
Dans un cluster, l’équivalent est une storage class NFS ou CIFS. Utilisez du block storage local au node (les classes block SSD du cloud) pour le volume de données ; si vous ne pouvez pas, suivez la recette de ce guide pour convertir le mode journal en DELETE et le figer. Ne prenez pas « le montage fonctionne » pour « la base est sûre ».
Règle trois : le conteneur démarre bien en root — l’agent, non
Dire que « l’image officielle doit tourner en root » est faux, mais c’est imprécis d’une manière qui compte quand vous négociez avec une équipe platform une exemption du Pod Security Standard.
L’image utilise s6-overlay comme système d’init. Son /init tourne en root afin de pouvoir chown le volume au premier boot, puis redescend vers l’utilisateur hermes via s6-setuidgid pour le programme principal et chaque service supervisé. L’image fournit même un shim qui détecte les appelants root lors d’un docker exec et ré-exécute via s6-setuidgid hermes.
Donc seul le bootstrap est en root ; l’agent, non. C’est malgré tout suffisant pour casser un security context restreint : un pod avec runAsNonRoot: true ou un runAsUser non nul échoue avant même que l’agent démarre, avec quelque chose comme :
/package/admin/s6-overlay/libexec/preinit: fatal: /run belongs to uid 0 instead of 1000,
has insecure and/or unworkable permissions, and we're lacking the privileges to fix it.
s6-overlay-suexec: fatal: child failed with exit code 100
Un détail que les exemples publiés se trompent régulièrement à écrire : l’utilisateur hermes est UID 10000, pas 1000. L’image le crée avec useradd -u 10000 -m -d /opt/data hermes et ne définit aucune instruction USER — le conteneur démarre en root par conception et abandonne lui-même ses privilèges. Mettez fsGroup: 1000 et votre volume finit par appartenir au mauvais groupe.
Un point de départ qui fonctionne (traitez la liste de capabilities comme une checklist, car les besoins de s6 évoluent entre les versions d’image) :
podSecurityContext:
  runAsUser: 0
  runAsNonRoot: false
  fsGroup: 10000
  fsGroupChangePolicy: OnRootMismatch
  seccompProfile:
    type: RuntimeDefault
containers:
  - name: hermes
    securityContext:
      allowPrivilegeEscalation: true
      readOnlyRootFilesystem: false
      runAsNonRoot: false
      capabilities:
        drop: ["ALL"]
        add: ["CHOWN", "SETUID", "SETGID"]
C’est sensiblement plus étroit qu’un pod privilégié : on abandonne tout, puis on rajoute uniquement ce dont le bootstrap a besoin. Si votre cluster applique le Pod Security Standard restricted, ce workload a besoin d’une exemption de namespace — vous n’avez pas raté un réglage, l’image n’a simplement pas été conçue pour démarrer en non-root.
Règle quatre : quand la platform englobe le PID 1, la supervision s6 se tait
L’entrypoint de l’image est un dispatcher, et le suexec de s6-overlay exige d’être PID 1. Quand une platform englobe l’entrypoint sous son propre init, le chemin documenté par upstream est que le dispatcher exécute directement le bootstrap de deuxième étape et exec le wrapper principal sans s6. La doc cite docker run --init et « certains setups Nomad/Kubernetes » comme les cas concernés.
Deux conséquences comptent :
- Si quelque chose dans votre stack injecte un processus init — un pod
shareProcessNamespace: true, certains injecteurs de sidecar, un runtime configuré pour en ajouter un — vous perdez silencieusement la supervision s6. L’agent continue de tourner ; il n’est simplement plus redémarré par s6. - Ce n’est pas forcément mauvais. Dans un cluster, vous voulez en général que la restart policy de Kubernetes soit le superviseur, plutôt qu’un process manager à l’intérieur du conteneur. Mais le modèle de défaillance change, donc sachez sur quel chemin vous êtes. Si vous voulez délibérément le comportement sans s6, demandez-le avec
--no-superviseouHERMES_GATEWAY_NO_SUPERVISE=1au lieu de compter sur un accident de la gestion du PID 1. Les deux ne font rien en dehors de l’image s6.
Règle cinq : les changements de config n’ont aucun endpoint de rechargement HTTP
C’est la règle gênante pour GitOps. Hermes vous donne /reload-mcp (recharger les serveurs MCP depuis config.yaml) et /reload-skills (re-scanner le répertoire de skills) dans une conversation, mais le serveur API n’expose aucun endpoint HTTP équivalent. La demande de fonctionnalité de la communauté pour exactement ça, l’issue #52417, est toujours ouverte en priorité basse.
Donc quand votre pipeline met à jour une ConfigMap, il n’y a aucun hook de réconciliation natif. Vos options réalistes sont de déclencher le chemin de rechargement du runtime (lancer la slash command dans une session) ou de redémarrer le workload — et redémarrer vous ramène directement à la contrainte Recreate, pas RollingUpdate.
Et oui : il n’y a pas de Helm chart officiel
La documentation upstream couvre install.sh, Docker, Docker Compose et les paquets Nix. Kubernetes n’est tout simplement pas une cible de déploiement promise, et la demande de fonctionnalité pour une histoire de packaging officielle — Dockerfile, Helm chart, RBAC et smoke tests d’un coup — est l’issue #85474, ouverte en août 2026 et toujours ouverte.
Il existe des tentatives communautaires, comme ultraworkers/hermes-agent-helm-chart (environ 140 stars, dernier push en avril), plus quelques operators personnels. Aucune n’est maintenue par Nous Research, et les versions de chart évoluent indépendamment de Hermes. Si vous en utilisez une, lisez les templates de bout en bout, surchargez vous-même le security context, et confrontez-la aux cinq règles ci-dessus — qu’une seule manque en silence et vous avez un risque de corruption de données qui attend un mauvais rollout.
Une checklist de déploiement minimale
- une release, un PVC,
ReadWriteOnce, monté sur/opt/data; replicas: 1etstrategy.type: Recreate;- le volume de données sur du block storage local au node, jamais NFS ;
- accepter root au bootstrap, utiliser
fsGroup: 10000, abandonner toutes les capabilities et ne rajouter queCHOWN,SETUID,SETGID; - décider délibérément si vous voulez la supervision s6, et le dire avec
--no-superviseouHERMES_GATEWAY_NO_SUPERVISE=1; - traiter les changements de config comme un restart-ou-slash-command, jamais comme un hot reload via HTTP ;
- dimensionner les ressources selon les recommandations Docker officielles et laisser de la marge pour l’automatisation navigateur (Playwright/Chromium), la chose la plus gourmande que fait Hermes.
En bref
Hermes tourne de manière stable sur Kubernetes tant que vous le traitez comme un service stateful single-writer, et non comme une app twelve-factor sans état. Écrivez ces contraintes dans vos manifests et dans la doc de votre équipe — single writer, stockage local au node, root au bootstrap, pas de rechargement HTTP — et le reste se passe comme pour n’importe quel autre workload stateful.
Si vous êtes encore sur un seul hôte Docker, partager un conteneur entre profiles demande moins de travail. Et si vous ne l’avez pas encore installé, commencez par le guide d’installation.