Pourquoi state.db se corrompt dans les montages Docker Desktop, OrbStack et WSL2
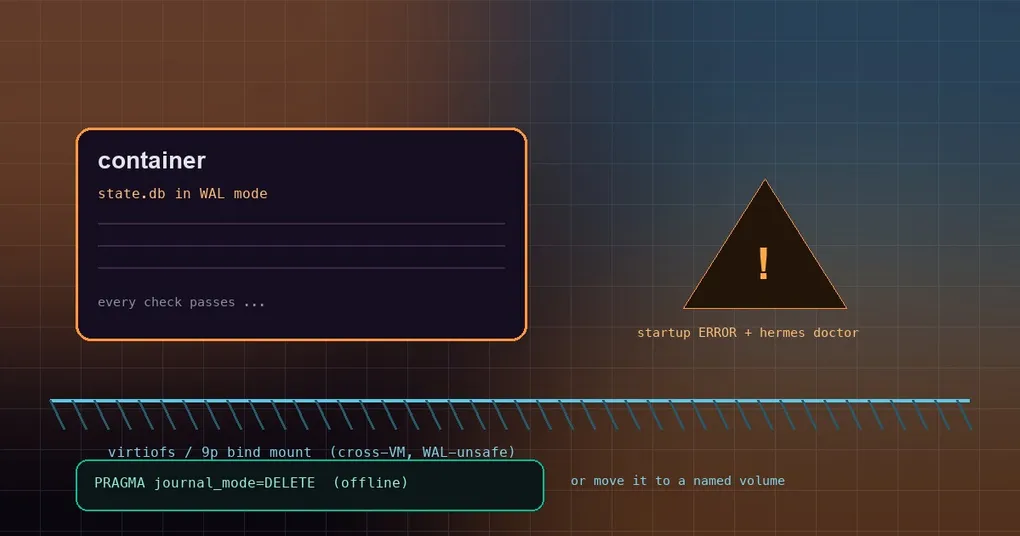
Vous avez mis Hermes Agent dans un container et fait ce qui était sensé avec le répertoire de données : un bind mount vers l’hôte, pour qu’une image reconstruite n’emporte pas vos sessions et votre config avec elle. Pendant quelques semaines, tout a marché. Les sessions étaient sauvegardées, hermes doctor n’affichait que des flèches cyan, les redémarrages de container étaient banals. Puis un matin, Hermes refuse de démarrer avec database disk image is malformed, ou la moitié de la liste des sessions a simplement disparu. Vous ouvrez le fichier sur l’hôte, lancez PRAGMA integrity_check dessus, et il déclare que la base est parfaitement saine. Cette contradiction, c’est tout le problème, et depuis la PR #111433 Hermes ne vous laisse plus l’affronter seul.
Trois termes d’abord : WAL, bind mount, virtiofs
WAL (write-ahead log) est un journal mode de SQLite dans lequel les écritures sont d’abord ajoutées à un fichier .db-wal, puis fusionnées plus tard dans la base principale. C’est bien plus rapide que le rollback journal par défaut, et le prix à payer est un index partagé en mémoire (state.db-shm) sur lequel chaque processus ayant la base ouverte doit s’accorder pour mettre les écrivains en file d’attente.
Un bind mount fait entrer directement un répertoire de l’hôte dans le container : les fichiers écrits à l’intérieur sont les mêmes fichiers que voit l’hôte, pas une copie.
virtiofs est le système de fichiers que Docker Desktop et OrbStack sous macOS utilisent pour exposer des répertoires de l’hôte à leur VM Linux ; Docker Desktop sous Windows passe par 9p / drvfs. Les deux donnent l’impression que les fichiers sont simplement là, mais chaque accès traverse une frontière de VM.
Pourquoi « tous les contrôles sont passés » est la partie dangereuse
La frontière de VM est exactement là où cela casse. WAL a besoin d’un vrai verrou partagé : deux processus qui écrivent dans la même base doivent voir le même état de verrou, pour pouvoir écrire chacun à leur tour au lieu de se chevaucher. Un montage inter-VM comme virtiofs ou 9p ne l’offre pas. Le côté hôte et le côté VM gardent leurs propres caches et leur propre vision des verrous, et les deux côtés croient détenir l’accès en écriture.
Résultat : deux écrivains peuvent entrer dans le chemin d’écriture au même moment, entrelacer leurs écritures dans le même fichier WAL et marcher sur les pages l’un de l’autre. Rien ne renvoie d’erreur, rien ne bloque, et la structure du fichier de base principal reste légale longtemps — jusqu’au moment où elle ne l’est plus, et où SQLite lève malformed à la prochaine ouverture.
C’est pourquoi cette défaillance est si systématiquement mal diagnostiquée. PRAGMA integrity_check lit la structure du fichier principal telle qu’elle existe maintenant, et elle passe. Les permissions de fichiers, l’espace disque et la vue côté hôte semblent sains eux aussi. Vous ne voyez une erreur qu’après que les dégâts ont eu lieu. Pour reprendre la documentation officielle : des écrivains concurrents peuvent corrompre silencieusement une base WAL pendant que le fichier principal passe encore son contrôle d’intégrité.
Une dernière chose à savoir : cette classification ne concerne que Linux. Hermes lit /proc/self/mountinfo à l’intérieur du container pour déterminer le type de montage, donc un hôte macOS ou Windows n’est jamais inspecté directement — le contrôle s’exécute dans le container Linux où Hermes s’exécute réellement, c’est-à-dire précisément là où la corruption se produit.
Ce que Hermes fait désormais : un log au démarrage plus hermes doctor
Depuis la v2026.9.14, Hermes classifie le montage à l’ouverture de la base et traite deux cas différemment :
- Une base neuve (aucun fichier encore, ou un fichier vide de 0 page) : si son répertoire se trouve sur virtiofs ou 9p, Hermes la crée en mode
DELETEet consigne un WARNING unique. Rien à faire de votre côté. - Une base déjà en mode WAL : Hermes ne la rétrograde pas à chaud. Les processus gateway, cron et worker peuvent la garder ouverte, et la basculer en
DELETEsous leur nez détruirait leurs écritures non validées. Hermes conserve donc WAL — et le dit. C’est ce qu’ajoute la PR #111433 : une ERROR une fois par processus au démarrage, plus un avertissement correspondant danshermes doctoravec le correctif explicité.
Sur une base saine, doctor affiche une ligne d’information du type → state.db: WAL journal mode (264.0 KB). Dès que la base se trouve sur un montage inter-VM, cette ligne devient un avertissement qui porte les deux remèdes mot pour mot :
$ hermes doctor
  ⚠ state.db is in WAL mode on a cross-VM filesystem (virtiofs/9p, 264.0 KB) (WAL can silently
    corrupt across the VM boundary; stop every Hermes process and run a one-time offline
    'PRAGMA journal_mode=DELETE' on the file, then set `database.journal_mode: delete` — or move
    the database onto a native/named volume)
Cet avertissement prime sur la notification d’exposition à la réinitialisation WAL, au motif qu’une corruption active passe avant une classe de bug latente. La déduplication est indexée sur le chemin de la base, donc un gateway qui sert plusieurs profiles signale chaque base touchée, pas seulement la première.
Correctif un : convertir hors ligne en DELETE et l’épingler
Commencez par arrêter tous les processus Hermes qui utilisent cette base — gateway, cron et sessions interactives comptent tous. Une conversion à chaud écarterait les écritures non validées des autres ouvreurs, c’est pourquoi Hermes refuse délibérément de le faire à votre place.
Lancez ensuite la conversion hors ligne, une seule fois. L’image publiée embarque libsqlite3 mais aucun shell sqlite3, utilisez donc le Python déjà présent dans l’image :
docker exec hermes python3 -c "import sqlite3; print(sqlite3.connect('/opt/data/state.db').execute('PRAGMA journal_mode=DELETE').fetchone()[0])"Un delete dans la sortie signifie que le basculement a fonctionné. Épinglez-le maintenant dans config.yaml, sinon la prochaine ouverture le remettra en WAL selon la valeur par défaut :
database:
  # La valeur par défaut est wal. Utilisez delete sur les bind mounts inter-VM, NFS ou SMB.
  journal_mode: delete
Le compromis porte sur la concurrence : le mode rollback-journal n’autorise qu’un seul écrivain à la fois et fait attendre lecteurs et écrivains les uns derrière les autres. Un agent mono-utilisateur ne le remarquera pas. Un déploiement qui fait tourner un gateway aux côtés de plusieurs workers rencontrera plus souvent database is locked.
Correctif deux : déplacer la base sur un volume natif ou nommé
Si vous préférez conserver la concurrence de WAL, remplacez le bind mount de l’hôte par un volume nommé Docker — docker run -v hermes-data:/opt/data. Un volume nommé vit sur le système de fichiers ext4 de la VM elle-même, où WAL est parfaitement sûr. Le problème n’a jamais été « WAL dans un container », mais un répertoire à cheval sur une frontière de VM.
Aide-mémoire des types de montage
| Type de montage | WAL sûr ? | Ce que fait Hermes |
|---|---|---|
Bind mount de l’hôte depuis Docker Desktop / OrbStack (virtiofs) |
Non | Les bases neuves passent en DELETE ; une base WAL existante consigne une ERROR au démarrage et doctor la signale |
Docker Desktop sous Windows (9p / drvfs) |
Non | Idem |
Volume nommé Docker, répertoire natif (ext4, btrfs, xfs, zfs, tmpfs, overlay) |
Oui | Conserve WAL et ne dit rien |
| NFS / SMB / FUSE générique | Pas de classification automatique | Pas détecté du tout ; définissez vous-même database.journal_mode: delete |
Pourquoi Hermes ne se contente pas de le corriger pour vous
Quelques compromis délibérés méritent d’être connus, car ils expliquent le comportement que vous observerez réellement.
Pas de rétrogradation à chaud. Basculer sur-le-champ en DELETE une base WAL que d’autres processus gardent ouverte revient à jeter leurs écritures non validées. Hermes préfère consigner une erreur et vous laisser choisir une fenêtre de maintenance.
Pas de locking_mode=EXCLUSIVE. Cela ressemble à la porte de sortie évidente, et c’en est une mauvaise : un verrou exclusif contournerait le problème de cohérence des verrous inter-VM, mais les processus gateway, cron et worker ouvrent state.db en parallèle par conception, donc cela échangerait une corruption occasionnelle contre database is locked sur toutes les surfaces.
Pas de détection automatique de NFS ou SMB. La classification automatique ne couvre que les familles virtiofs et 9p ; NFS, SMB et FUSE générique n’en font pas partie. Si votre répertoire de données vit sur NFS ou SMB, définissez database.journal_mode: delete vous-même.
Ces correctifs sont arrivés en une seule série de travaux : #98965 a empêché state.db de se corrompre silencieusement sur les bind mounts Docker Desktop / OrbStack, #110544 a fait survivre WAL aux fermetures de voisins et aux annulations de verrou parasites, #109541 a fait passer chaque petit store par une transaction open_db unique avec les bases de plugins sur le même repli WAL — et #111433 a ajouté le signal destiné à l’opérateur, l’erreur au démarrage et le contrôle doctor.
Si votre state.db a déjà été endommagé une fois, commencez par comment state.db se répare tout seul. Si le symptôme est « database is locked » plutôt que « database is corrupt », c’est une défaillance différente avec des correctifs différents — voir les correctifs de verrou de state.db. Pour les pièges liés à l’utilisation de plusieurs containers sur le même répertoire de données, le guide du container partagé va plus loin. Et le premier arrêt de tout contrôle de santé reste toujours la référence de hermes doctor.