Por que o state.db se corrompe dentro de mounts do Docker Desktop, OrbStack e WSL2
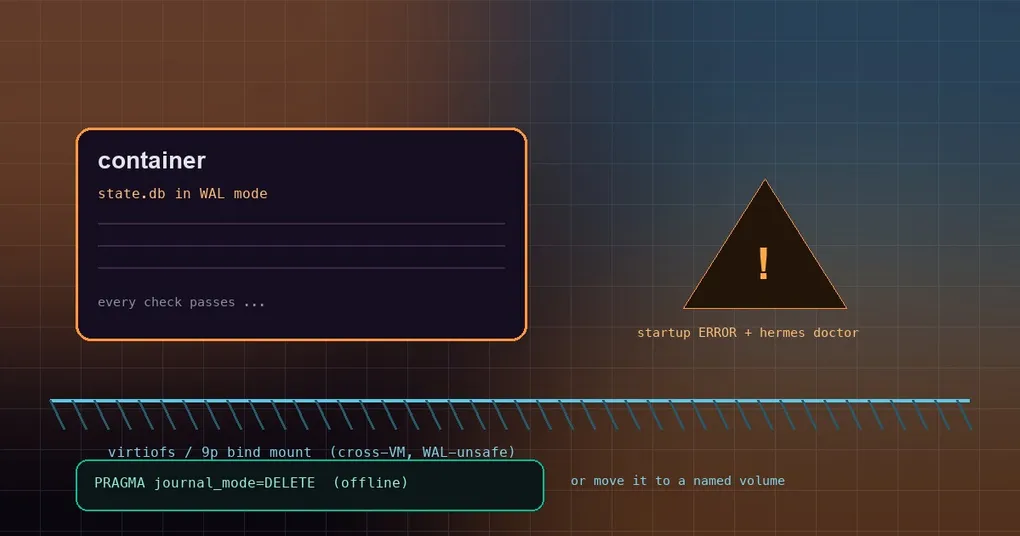
Você colocou o Hermes Agent em um container e fez o que fazia sentido com o diretório de dados: bind mount para o host, para que uma imagem reconstruída não levasse suas sessões e sua config embora. Durante algumas semanas funcionou. Sessões salvas, hermes doctor não imprimia nada além de setas ciano, reinícios de container eram entediantes. Até que uma manhã o Hermes se recusa a iniciar com database disk image is malformed, ou metade da lista de sessões simplesmente sumiu. Você abre o arquivo no host, roda PRAGMA integrity_check nele, e ele reporta que o banco está perfeitamente bem. Essa contradição é o problema inteiro, e desde a PR #111433 o Hermes não deixa mais você enfrentá-la sozinho.
Três termos antes de tudo: WAL, bind mount, virtiofs
WAL (write-ahead log) é um journal mode do SQLite em que as escritas são anexadas primeiro a um arquivo .db-wal e mescladas de volta ao banco principal depois. Ele é bem mais rápido que o rollback journal padrão, e o preço é um índice compartilhado em memória (state.db-shm) com o qual todo processo que tem o banco aberto precisa concordar para enfileirar writers.
Um bind mount entrega um diretório do host direto ao container: os arquivos escritos lá dentro são os mesmos arquivos que o host vê, não uma cópia.
virtiofs é o filesystem que o Docker Desktop e o OrbStack no macOS usam para expor diretórios do host à VM Linux deles; o Docker Desktop no Windows passa por 9p / drvfs. Os dois fazem os arquivos parecerem simplesmente estar lá, mas todo acesso atravessa uma fronteira de VM.
Por que “toda checagem passou” é a parte perigosa
A fronteira da VM é exatamente onde isso quebra. O WAL precisa de um lock compartilhado de verdade: dois processos escrevendo no mesmo banco precisam ver o mesmo estado de lock, para poderem se revezar em vez de se atropelarem. Um mount entre VMs como virtiofs ou 9p não oferece isso. O lado do host e o lado da VM mantêm seus próprios caches e sua própria visão dos locks, e os dois lados acreditam deter acesso de escrita.
O resultado: dois writers podem entrar no caminho de escrita ao mesmo tempo, intercalar escritas no mesmo arquivo WAL e pisar nas páginas um do outro. Nada dá erro, nada bloqueia, e a estrutura do arquivo principal do banco continua legal por um bom tempo — até o momento em que não continua, e o SQLite lança malformed na abertura seguinte.
É por isso que essa falha é tão consistentemente mal diagnosticada. PRAGMA integrity_check lê a estrutura do arquivo principal como ela está naquele instante, e passa. Permissões de arquivo, espaço em disco e a visão do lado do host também parecem saudáveis. Você só vê um erro depois que o dano já aconteceu. Nas palavras da documentação oficial, writers concorrentes podem corromper silenciosamente um banco WAL enquanto o arquivo principal ainda passa na checagem de integridade.
Mais uma coisa que vale saber: essa classificação é exclusiva de Linux. O Hermes lê /proc/self/mountinfo dentro do container para determinar o tipo de mount, então um host macOS ou Windows nunca é inspecionado diretamente — a checagem roda dentro do container Linux onde o Hermes de fato executa, que é justamente onde a corrupção acontece.
O que o Hermes faz agora: um log de inicialização mais o hermes doctor
Desde a v2026.9.14, o Hermes classifica o mount quando abre o banco e trata dois casos de forma diferente:
- Um banco novo (sem arquivo ainda, ou um arquivo vazio de 0 páginas): se o diretório dele estiver em virtiofs ou 9p, o Hermes o cria em modo
DELETEe registra um WARNING único. Nada para você fazer. - Um banco que já está em modo WAL: o Hermes não faz downgrade dele ao vivo. Os processos gateway, cron e worker podem mantê-lo aberto, e trocá-lo para
DELETEembaixo deles destruiria as escritas não confirmadas deles. Então o Hermes mantém WAL — e diz isso. É o que a PR #111433 adiciona: um ERROR uma vez por processo na inicialização, mais um aviso correspondente nohermes doctorcom a correção escrita por extenso.
Em um banco saudável, o doctor imprime uma linha informativa como → state.db: WAL journal mode (264.0 KB). Assim que o banco está em um mount entre VMs, essa linha vira um aviso que traz os dois remédios na íntegra:
$ hermes doctor
  ⚠ state.db is in WAL mode on a cross-VM filesystem (virtiofs/9p, 264.0 KB) (WAL can silently
    corrupt across the VM boundary; stop every Hermes process and run a one-time offline
    'PRAGMA journal_mode=DELETE' on the file, then set `database.journal_mode: delete` — or move
    the database onto a native/named volume)
Esse aviso tem prioridade sobre a notificação de exposição ao reset de WAL, com o argumento de que corrupção ativa vence uma classe de bug latente. A deduplicação é indexada pelo caminho do banco, então um gateway que serve vários profiles reporta todos os bancos afetados, e não apenas o primeiro.
Correção um: converter offline para DELETE e fixar isso com pin
Comece parando todo processo Hermes que usa esse banco — gateway, cron e sessões interativas contam todos. Uma conversão ao vivo descartaria as escritas não confirmadas dos outros que têm o banco aberto, e é por isso que o Hermes se recusa de propósito a fazer isso por você.
Depois rode a conversão offline, uma única vez. A imagem publicada traz libsqlite3 mas nenhum shell sqlite3, então use o Python que já está na imagem:
docker exec hermes python3 -c "import sqlite3; print(sqlite3.connect('/opt/data/state.db').execute('PRAGMA journal_mode=DELETE').fetchone()[0])"Um delete na saída significa que a troca funcionou. Agora fixe isso no config.yaml, senão a próxima abertura vai voltar para WAL conforme o default:
database:
  # O default é wal. Use delete em bind mounts entre VMs, NFS ou SMB.
  journal_mode: delete
O trade-off é a concorrência: o modo rollback-journal permite um único writer por vez e faz readers e writers esperarem uns pelos outros. Um agent de um único usuário não vai notar. Um deployment que roda um gateway junto de vários workers vai encontrar database is locked com mais frequência.
Correção dois: mover o banco para um volume nativo ou nomeado
Se você prefere manter a concorrência do WAL, troque o bind mount do host por um volume nomeado do Docker — docker run -v hermes-data:/opt/data. Um volume nomeado vive no próprio filesystem ext4 da VM, onde WAL é perfeitamente seguro. O problema nunca foi “WAL dentro de um container”; era um diretório que fica a cavalo de uma fronteira de VM.
Guia rápido dos tipos de mount
| Tipo de mount | WAL é seguro? | O que o Hermes faz |
|---|---|---|
Bind mount do host a partir do Docker Desktop / OrbStack (virtiofs) |
Não | Bancos novos recebem DELETE; um banco WAL existente registra um ERROR na inicialização e o doctor sinaliza |
Docker Desktop no Windows (9p / drvfs) |
Não | O mesmo |
Volume nomeado do Docker, diretório nativo (ext4, btrfs, xfs, zfs, tmpfs, overlay) |
Sim | Mantém WAL e não diz nada |
| NFS / SMB / FUSE genérico | Não é classificado automaticamente | Não é detectado de forma alguma; defina database.journal_mode: delete você mesmo |
Por que o Hermes não simplesmente corrige isso para você
Alguns trade-offs deliberados vale conhecer, porque explicam o comportamento que você vai de fato observar.
Nenhum downgrade ao vivo. Trocar na hora para DELETE um banco WAL que outros processos mantêm aberto significa jogar fora as escritas não confirmadas deles. O Hermes prefere registrar um erro e deixar você escolher uma janela de manutenção.
Nada de locking_mode=EXCLUSIVE. Parece a saída óbvia e é uma saída ruim: um lock exclusivo contornaria o problema de coerência de lock entre VMs, mas os processos gateway, cron e worker abrem o state.db em paralelo por design, então isso trocaria uma corrupção ocasional por database is locked em todas as superfícies.
Nenhuma detecção automática de NFS ou SMB. A classificação automática cobre apenas as famílias virtiofs e 9p; NFS, SMB e FUSE genérico não estão nela. Se o seu diretório de dados vive em NFS ou SMB, defina database.journal_mode: delete você mesmo.
Essas correções chegaram como uma sequência de trabalho: a #98965 impediu o state.db de se corromper em silêncio em bind mounts do Docker Desktop / OrbStack, a #110544 fez o WAL sobreviver a fechamentos de processos irmãos e ao cancelamento de locks perdidos, a #109541 roteou todo store pequeno por uma única transação open_db, com os bancos de plugin no mesmo fallback de WAL — e a #111433 adicionou o sinal voltado ao operador, o erro de inicialização e a checagem do doctor.
Se o seu state.db já foi danificado uma vez, comece por como o state.db se cura sozinho. Se o sintoma é “database is locked” em vez de “database is corrupt”, trata-se de uma falha diferente, com correções diferentes — veja as correções de lock do state.db. Para as armadilhas de rodar mais de um container contra o mesmo diretório de dados, o guia de containers compartilhados vai mais fundo. E a primeira parada de qualquer health check é sempre a referência do hermes doctor.