Por qué state.db se corrompe dentro de Docker Desktop, OrbStack y montajes WSL2
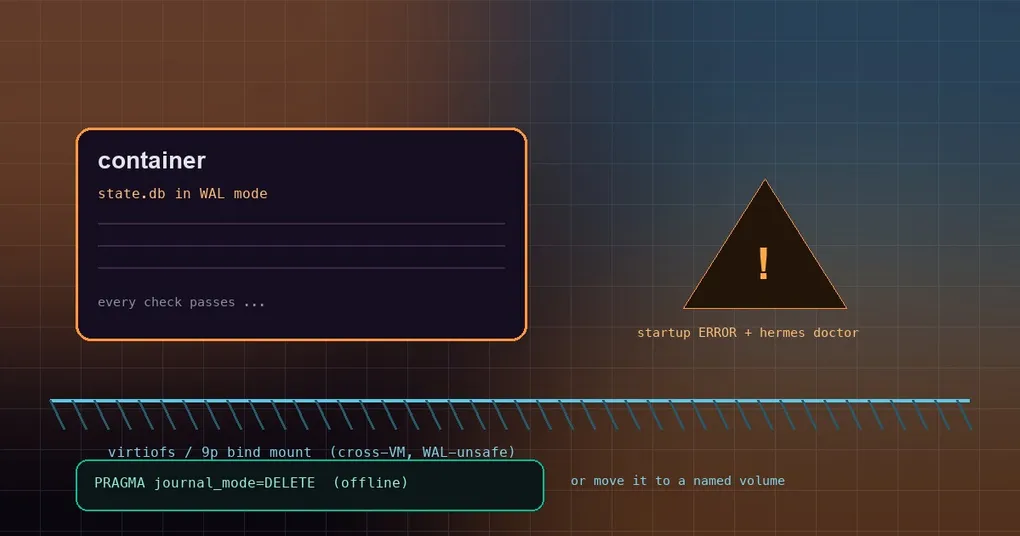
Containerizaste Hermes Agent e hiciste lo sensato con el directorio de datos: un bind mount al host para que rehacer la imagen no se llevara por delante tus sesiones y tu config. Durante unas semanas funcionó. Las sesiones se guardaban, hermes doctor no imprimía más que flechas cian, reiniciar el container era aburrido. Y una mañana Hermes se niega a arrancar con database disk image is malformed, o la mitad de la lista de sesiones simplemente ha desaparecido. Abres el archivo en el host, ejecutas PRAGMA integrity_check contra él, y te dice que la base de datos está perfectamente bien. Esa contradicción es todo el problema, y desde el PR #111433 Hermes ya no te deja pelear con ella a solas.
Tres términos primero: WAL, bind mount, virtiofs
WAL (write-ahead log) es un modo de journal de SQLite en el que las escrituras se añaden primero a un archivo .db-wal y se fusionan después con la base de datos principal. Es mucho más rápido que el rollback journal por defecto, y el precio es un índice compartido en memoria (state.db-shm) con el que todos los procesos que tienen la base de datos abierta tienen que estar de acuerdo para encolar escritores.
Un bind mount entrega un directorio del host directamente dentro del container: los archivos escritos dentro son los mismos que ve el host, no una copia.
virtiofs es el sistema de archivos que Docker Desktop y OrbStack en macOS usan para exponer directorios del host a su VM de Linux; Docker Desktop en Windows pasa por 9p / drvfs. Los dos hacen que los archivos parezcan estar simplemente ahí, pero cada acceso cruza una frontera de VM.
Por qué “todas las comprobaciones pasaron” es la parte peligrosa
La frontera de la VM es exactamente donde esto se rompe. WAL necesita un lock compartido de verdad: dos procesos que escriben en la misma base de datos deben ver el mismo estado de locks, para poder turnarse en lugar de atropellarse. Un montaje que cruza VMs como virtiofs o 9p no lo ofrece. El lado del host y el lado de la VM mantienen sus propias cachés y su propia visión de los locks, y los dos lados creen tener acceso de escritura.
El resultado: dos escritores pueden entrar en la ruta de escritura al mismo tiempo, intercalar escrituras en el mismo archivo WAL y pisarse las páginas entre sí. Nada da error, nada se bloquea, y la estructura del archivo principal sigue siendo legal durante un buen rato — hasta que en un momento deja de serlo, y SQLite lanza malformed en la siguiente apertura.
Por eso este fallo se diagnostica mal con tanta consistencia. PRAGMA integrity_check lee la estructura del archivo principal tal como está ahora mismo, y pasa. Los permisos de archivo, el espacio en disco y la vista del host también parecen sanos. Solo ves un error después de que el daño ya ha ocurrido. En palabras de la documentación oficial, los escritores concurrentes pueden corromper una base de datos WAL en silencio mientras el archivo principal sigue pasando su integrity check.
Una cosa más que conviene saber: esta clasificación es solo para Linux. Hermes lee /proc/self/mountinfo dentro del container para determinar el tipo de montaje, así que un host macOS o Windows nunca se inspecciona directamente — la comprobación corre dentro del container Linux donde Hermes se ejecuta de verdad, que es precisamente donde ocurre la corrupción.
Lo que hace Hermes ahora: un log al arrancar más hermes doctor
Desde v2026.9.14, Hermes clasifica el montaje cuando abre la base de datos y trata dos casos de forma distinta:
- Una base de datos nueva (sin archivo todavía, o uno vacío de 0 páginas): si su directorio está en virtiofs o 9p, Hermes la crea en modo
DELETEy registra un WARNING una sola vez. No tienes que hacer nada. - Una base de datos que ya está en modo WAL: Hermes no la degrada en caliente. Los procesos de gateway, cron y worker pueden tenerla abierta, y cambiarla a
DELETEbajo sus pies destruiría sus escrituras no confirmadas. Así que Hermes mantiene WAL — y lo dice. Eso es lo que añade el PR #111433: un ERROR una vez por proceso al arrancar, más un warning equivalente enhermes doctorcon el arreglo bien explicado.
En una base de datos sana, doctor imprime una línea informativa como → state.db: WAL journal mode (264.0 KB). En cuanto la base de datos está en un montaje que cruza VMs, esa línea se convierte en un warning que lleva los dos remedios palabra por palabra:
$ hermes doctor
  ⚠ state.db is in WAL mode on a cross-VM filesystem (virtiofs/9p, 264.0 KB) (WAL can silently
    corrupt across the VM boundary; stop every Hermes process and run a one-time offline
    'PRAGMA journal_mode=DELETE' on the file, then set `database.journal_mode: delete` — or move
    the database onto a native/named volume)
Este warning tiene prioridad sobre el aviso de exposición al reset de WAL, con el argumento de que la corrupción activa gana a una clase de bug latente. La deduplicación va por ruta de base de datos, así que un gateway que sirve varios profiles reporta todas las bases de datos afectadas y no solo la primera.
Arreglo uno: convertir a DELETE en frío y fijarlo
Empieza por parar todos los procesos de Hermes que usen esta base de datos — gateway, cron y sesiones interactivas cuentan todos. Una conversión en caliente descartaría las escrituras no confirmadas de otros que la tienen abierta, y por eso Hermes se niega deliberadamente a hacerlo por ti.
Luego ejecuta la conversión offline puntual. La imagen publicada incluye libsqlite3 pero no un shell sqlite3, así que usa el Python que ya está en la imagen:
docker exec hermes python3 -c "import sqlite3; print(sqlite3.connect('/opt/data/state.db').execute('PRAGMA journal_mode=DELETE').fetchone()[0])"Un delete en la salida significa que el cambio funcionó. Ahora fíjalo en config.yaml, o la siguiente apertura lo devolverá a WAL según el default:
database:
  # El default es wal. Usa delete en bind mounts que cruzan VMs, NFS o SMB.
  journal_mode: delete
El trade-off es la concurrencia: el modo rollback-journal permite un solo escritor a la vez y hace que lectores y escritores se esperen unos a otros. Un agente de un solo usuario no lo notará. Un despliegue con un gateway junto a varios workers se topará con database is locked más a menudo.
Arreglo dos: mover la base de datos a un volumen nativo o con nombre
Si prefieres conservar la concurrencia de WAL, sustituye el bind mount del host por un volumen con nombre de Docker — docker run -v hermes-data:/opt/data. Un volumen con nombre vive en el propio sistema de archivos ext4 de la VM, donde WAL es perfectamente seguro. El problema nunca fue “WAL dentro de un container”; era un directorio a caballo entre dos VMs.
Chuleta de tipos de montaje
| Tipo de montaje | ¿Seguro con WAL? | Qué hace Hermes |
|---|---|---|
Bind mount del host desde Docker Desktop / OrbStack (virtiofs) |
No | Las BD nuevas pasan a DELETE; una BD ya en WAL registra un ERROR al arrancar y doctor lo señala |
Docker Desktop en Windows (9p / drvfs) |
No | Lo mismo |
Volumen con nombre de Docker, directorio nativo (ext4, btrfs, xfs, zfs, tmpfs, overlay) |
Sí | Mantiene WAL y no dice nada |
| NFS / SMB / FUSE genérico | No se clasifica automáticamente | No se detecta en absoluto; fija tú database.journal_mode: delete |
Por qué Hermes no lo arregla simplemente por ti
Hay unos cuantos trade-offs deliberados que conviene conocer, porque explican el comportamiento que vas a observar de verdad.
Sin degradación en caliente. Cambiar a DELETE al momento una base de datos WAL que otros procesos tienen abierta significa tirar sus escrituras no confirmadas. Hermes prefiere registrar un error y dejarte elegir una ventana de mantenimiento.
Sin locking_mode=EXCLUSIVE. Parece la salida obvia y es mala: un lock exclusivo esquivaría el problema de coherencia de locks entre VMs, pero los procesos de gateway, cron y worker abren state.db de forma concurrente por diseño, así que cambiaría corrupción ocasional por database is locked en todas las superficies.
Sin detección automática de NFS o SMB. La clasificación automática cubre solo las familias virtiofs y 9p; NFS, SMB y FUSE genérico no están en ella. Si tu directorio de datos vive en NFS o SMB, fija database.journal_mode: delete tú mismo.
Estos arreglos llegaron como una sola tanda de trabajo: #98965 evitó que state.db se corrompiera en silencio en bind mounts de Docker Desktop / OrbStack, #110544 hizo que WAL sobreviviera a cierres de procesos hermanos y a la cancelación de locks huérfanos, #109541 enrutó todos los almacenes pequeños por una única transacción open_db con las bases de datos de plugins en el mismo fallback de WAL — y #111433 añadió la señal para el operador, el error al arrancar y la comprobación de doctor.
Si tu state.db ya se ha dañado una vez, empieza por cómo se cura solo state.db. Si el síntoma es “database is locked” en lugar de “database is corrupt”, es un fallo distinto con arreglos distintos — mira los arreglos de bloqueo de state.db. Para las trampas de correr más de un container contra el mismo directorio de datos, la guía de containers compartidos entra más a fondo. Y la primera parada de cualquier health check es siempre la referencia de hermes doctor.