为什么 state.db 会在 Docker Desktop / OrbStack / WSL2 的挂载目录里损坏
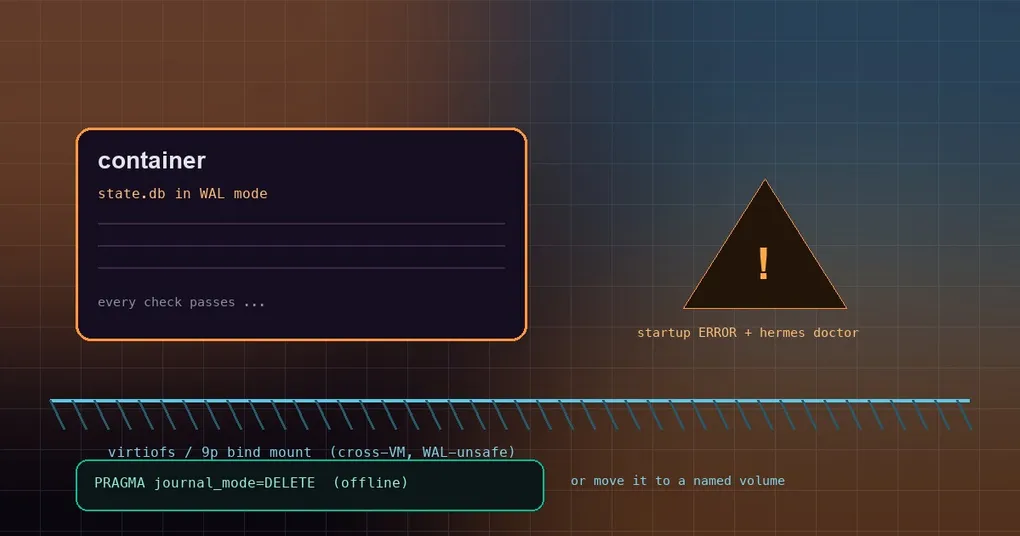
把 Hermes Agent 装进容器之后,大多数人做的第一件事就是把数据目录 bind mount 到宿主机上,这样重建镜像不会连会话和配置一起冲掉。头几周一切正常:会话存得下,hermes doctor 全是青色的箭头,重启容器也没事。然后某天启动时突然弹出 database disk image is malformed,或者会话列表里凭空少掉一截。你在宿主机上打开那个文件检查,PRAGMA integrity_check 却说它完好无损——这正是这类故障最让人抓不住的地方。
三个名词,先说人话
WAL(write-ahead log,预写日志)是 SQLite 的一种日志模式:写入先追加到一个 .db-wal 文件,之后再择机合并回主库。它比默认的 rollback journal 快得多,代价是需要一块由所有打开这个数据库的进程共享的内存索引(state.db-shm)来做排队。
bind mount(绑定挂载)指把宿主机上的一个目录直接挂进容器:容器里写文件,写的其实就是宿主机上那批文件,而不是复制一份进来。
virtiofs 是 macOS 上 Docker Desktop、OrbStack 这类工具把宿主机目录交给 Linux 虚拟机时使用的文件系统;Windows 上的 Docker Desktop 走的是 9p / drvfs。它们都能让文件看起来“就在那儿”,但每次访问都跨过一条虚拟机边界。
为什么“每项检查都通过”反而是危险信号
问题就出在这条虚拟机边界上。WAL 需要的是真正的共享锁:两个进程同时写同一个库时,它们必须看到同一份锁状态,才能排队、才不至于互相覆盖。virtiofs 和 9p 这类跨 VM 的挂载做不到这一点——宿主机一侧和虚拟机一侧各有自己的缓存与锁视图,两边都以为自己握有写权限。
后果是:两个写进程可以同时进入写入路径,交替写进同一个 WAL 文件,互相踩掉对方刚写下的页。整个过程不报错、不阻塞,主库文件的结构在相当长一段时间里依然合法——直到某一刻它不再合法,SQLite 才在下一次打开时抛出 malformed。
这也解释了为什么这个故障这么容易被误诊:PRAGMA integrity_check 读的是主库文件当下的结构,它通过了;在宿主机上看文件、看权限、看磁盘空间,也全都正常;只有等损坏真的发生,你才会看到报错。用官方文档的说法,并发写入者可以在主库仍然通过完整性检查的情况下,悄悄写坏一个 WAL 数据库。
还有一点要留意:这个判断只在 Linux 里生效。Hermes 通过读容器内的 /proc/self/mountinfo 判断挂载类型,所以 macOS 或 Windows 宿主机本身不会被检测——检测发生在真正跑 Hermes 的那个 Linux 容器内部,而那恰好就是出问题的位置。
Hermes 现在做了什么:启动日志加 hermes doctor
从 v2026.9.14 起,Hermes 打开数据库时会识别挂载类型,并分两种情况处理:
- 全新的数据库(文件还不存在,或者是个 0 页的空文件):如果所在目录在 virtiofs/9p 上,就直接建成
DELETE模式,并打一条一次性的 WARNING。这种情况你什么都不用做。 - 已经处于 WAL 模式的数据库:Hermes 不会在线降级。网关、cron、worker 可能同时持有这个库,现场把它切成
DELETE会毁掉它们尚未落盘的提交。所以它选择保留 WAL,但把问题明确说出来——PR #111433 补的正是这一条:每个进程启动时打一条一次性的 ERROR,hermes doctor同步给出警告和修法。
数据库健康的时候,doctor 里是这么一行:→ state.db: WAL journal mode (264.0 KB)。一旦这个库躺在跨 VM 挂载上,它会变成警告,并把两条修法直接写进输出:
$ hermes doctor
  ⚠ state.db is in WAL mode on a cross-VM filesystem (virtiofs/9p, 264.0 KB) (WAL can silently
    corrupt across the VM boundary; stop every Hermes process and run a one-time offline
    'PRAGMA journal_mode=DELETE' on the file, then set `database.journal_mode: delete` — or move
    the database onto a native/named volume)
这条警告排在 WAL 重置 bug 的曝光提示之前,理由是正在发生的损坏比一个潜在的 bug 类别更要紧。去重是按数据库路径做的,所以一个管着多个 profile 的网关会把每个受影响的库都报一遍,而不是只报第一个。
修法一:离线转成 DELETE 模式,并把它固定住
第一步是停掉所有使用这个数据库的 Hermes 进程——网关、cron、交互式会话都算在内。在线转换会毁掉其他打开者的未提交数据,Hermes 故意不替你做这件事。
然后做一次性离线转换。官方镜像里带的是 libsqlite3,没有 sqlite3 命令行工具,所以要用镜像自带的 Python:
docker exec hermes python3 -c "import sqlite3; print(sqlite3.connect('/opt/data/state.db').execute('PRAGMA journal_mode=DELETE').fetchone()[0])"输出 delete 就说明切换成功。接着在 config.yaml 里把它钉住,否则下一次打开数据库时,Hermes 会按默认值把它再切回 WAL:
database:
  # 默认是 wal。跨 VM 的 bind mount、NFS、SMB 这类文件系统上要写成 delete。
  journal_mode: delete
代价是并发能力:rollback journal 模式同一时刻只允许一个写者,读写之间也会互相等待。对单人使用的 agent 来说通常察觉不到,但对同时跑网关和多个 worker 的部署,写入会更容易撞上 database is locked。
修法二:把数据库搬到原生卷或命名卷
如果你不想放弃 WAL 的并发能力,就把数据目录从宿主机 bind mount 换成 Docker 命名卷——docker run -v hermes-data:/opt/data。命名卷落在虚拟机自己的 ext4 上,那里 WAL 是完全安全的。说到底,问题从来不是“容器里不能跑 WAL”,而是“这个目录跨着一条 VM 边界”。
挂载类型速查表
| 挂载类型 | WAL 安全? | Hermes 的处理 |
|---|---|---|
Docker Desktop / OrbStack 的宿主机 bind mount(virtiofs) |
否 | 新库自动用 DELETE;已存在的 WAL 库启动时报一次 ERROR,doctor 标警告 |
Windows 上 Docker Desktop 的挂载(9p / drvfs) |
否 | 同上 |
Docker 命名卷、原生目录(ext4、btrfs、xfs、zfs、tmpfs、overlay) |
是 | 照常用 WAL,不做任何提示 |
| NFS / SMB / 通用 FUSE | 未做自动判定 | 不检测,需要在 config.yaml 里手动设 database.journal_mode: delete |
为什么 Hermes 不干脆自己动手
几个刻意的取舍值得知道,因为它们直接解释了你看到的行为。
不做在线降级。 现场把一个正被多个进程打开的 WAL 库切成 DELETE,等于把那些进程还没提交的写入丢掉。宁可报错让你自己挑时间停机处理。
不采用 locking_mode=EXCLUSIVE。 这是个看着很美、实际很糟的选项:独占锁确实能绕开跨 VM 的锁一致性问题,但 Hermes 的网关、cron、worker 本来就是并发打开 state.db 的,独占锁会把“偶发损坏”换成“到处 database is locked”。
也不自动判定 NFS 和 SMB。 自动分类只覆盖 virtiofs/9p 系列,NFS、SMB 和通用 FUSE 不在其中。如果你把数据目录放在 NFS 或 SMB 上,请自己设 database.journal_mode: delete。
这一批修复是连着来的:#98965 让 state.db 在 Docker Desktop / OrbStack 的 bind mount 上不再悄悄损坏,#110544 让 WAL 在兄弟连接关闭和野锁被取消时还能撑住,#109541 把各个小存储统一到一个 open_db 事务入口,插件数据库也走同一套 WAL 回退逻辑;#111433 补上的则是给运维者的那个信号——启动报错加 doctor 检查。
如果你的 state.db 已经坏过一次,先看 state.db 自愈那一篇;如果症状是“数据库被锁”而不是“数据库损坏”,那是另一个问题,处理方式见 state.db 锁问题修复。多个容器共享同一份数据目录的坑,多容器共享部署那一篇讲得更细。日常体检的第一站永远是 hermes doctor 命令参考。