Warum state.db in Docker Desktop, OrbStack- und WSL2-Mounts beschädigt wird
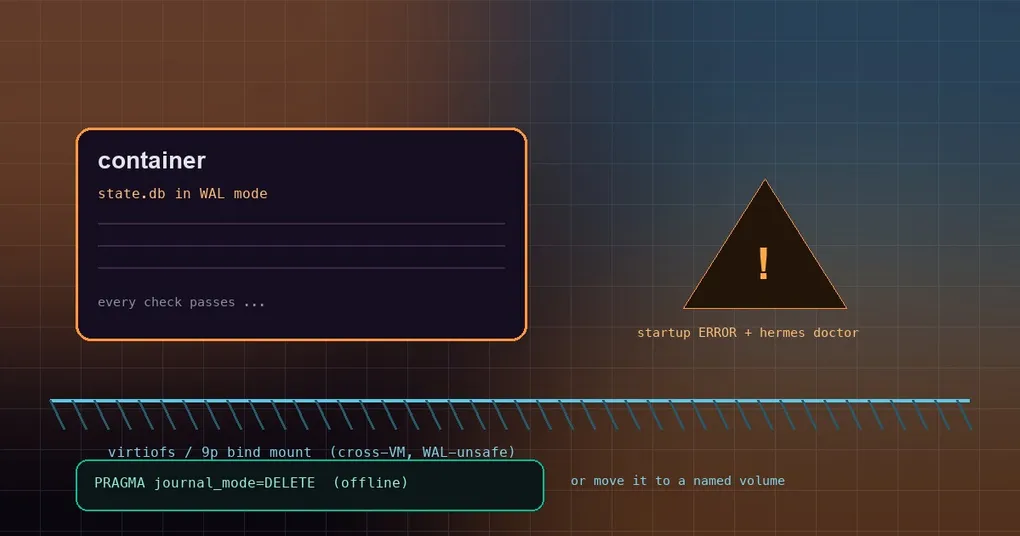
Du hast Hermes Agent containerisiert und mit dem Datenverzeichnis das Vernünftige getan: per Bind Mount auf den Host gelegt, damit ein neu gebautes Image nicht deine Sessions und deine Config mitnimmt. Ein paar Wochen funktionierte es. Sessions wurden gespeichert, hermes doctor gab nichts als cyanfarbene Pfeile aus, Container-Neustarts waren langweilig. Dann verweigert Hermes eines Morgens den Start mit database disk image is malformed, oder die halbe Session-Liste ist einfach weg. Du öffnest die Datei auf dem Host, führst PRAGMA integrity_check darauf aus, und sie meldet, die Datenbank sei vollkommen in Ordnung. Dieser Widerspruch ist das ganze Problem, und seit PR #111433 lässt Hermes dich damit nicht mehr allein.
Zuerst drei Begriffe: WAL, bind mount, virtiofs
WAL (write-ahead log) ist ein SQLite-Journal-Modus, bei dem Schreibvorgänge zuerst an eine .db-wal-Datei angehängt und später in die Hauptdatenbank zurückgemerged werden. Er ist deutlich schneller als das Standard-Rollback-Journal, und der Preis dafür ist ein geteilter In-Memory-Index (state.db-shm), auf den sich jeder Prozess mit geöffneter Datenbank einigen muss, um Writer in eine Warteschlange zu bringen.
Ein bind mount reicht ein Host-Verzeichnis direkt in den Container: Dateien, die darin geschrieben werden, sind dieselben Dateien, die der Host sieht, keine Kopie.
virtiofs ist das Dateisystem, mit dem Docker Desktop und OrbStack unter macOS Host-Verzeichnisse für ihre Linux-VM bereitstellen; Docker Desktop unter Windows geht über 9p / drvfs. Beide lassen die Dateien so aussehen, als wären sie einfach da, aber jeder Zugriff überschreitet eine VM-Grenze.
Warum „jede Prüfung bestanden“ der gefährliche Teil ist
Die VM-Grenze ist genau die Stelle, an der das bricht. WAL braucht einen echten Shared Lock: Zwei Prozesse, die dieselbe Datenbank schreiben, müssen denselben Lock-Zustand sehen, damit sie sich abwechseln können, statt einander zu überrollen. Ein Cross-VM-Mount wie virtiofs oder 9p bietet das nicht. Die Host-Seite und die VM-Seite behalten ihre eigenen Caches und ihre eigene Sicht auf die Locks, und beide Seiten glauben, Schreibzugriff zu haben.
Das Ergebnis: Zwei Writer können gleichzeitig in den Schreibpfad eintreten, Schreibvorgänge in dieselbe WAL-Datei verschachteln und einander auf die Seiten treten. Nichts wirft einen Fehler, nichts blockiert, und die Struktur der Hauptdatenbank-Datei bleibt lange legal – bis zu dem Moment, in dem sie es nicht mehr ist, und SQLite beim nächsten Öffnen malformed wirft.
Deshalb wird dieser Fehler so konsequent fehldiagnostiziert. PRAGMA integrity_check liest die Struktur der Hauptdatei so, wie sie gerade jetzt existiert, und sie besteht. Dateiberechtigungen, Speicherplatz und die Host-Sicht sehen ebenfalls gesund aus. Du siehst einen Fehler erst, nachdem der Schaden bereits eingetreten ist. In den Worten der offiziellen Docs können gleichzeitige Writer eine WAL-Datenbank still beschädigen, während die Hauptdatei ihren Integrity Check noch besteht.
Noch etwas, das man wissen sollte: Diese Klassifizierung ist Linux-only. Hermes liest /proc/self/mountinfo im Container, um den Mount-Typ zu bestimmen, ein macOS- oder Windows-Host wird also nie direkt inspiziert – die Prüfung läuft im Linux-Container, in dem Hermes tatsächlich ausgeführt wird, und genau dort entsteht die Korruption.
Was Hermes jetzt tut: ein Startup-Log plus hermes doctor
Seit v2026.9.14 klassifiziert Hermes den Mount, wenn es die Datenbank öffnet, und behandelt zwei Fälle unterschiedlich:
- Eine frische Datenbank (noch keine Datei oder eine leere mit 0 Seiten): Wenn ihr Verzeichnis auf virtiofs oder 9p liegt, legt Hermes sie im
DELETE-Modus an und loggt einmalig eine WARNING. Für dich gibt es nichts zu tun. - Eine Datenbank, die bereits im WAL-Modus ist: Hermes stuft sie nicht live herunter. Die Gateway-, Cron- und Worker-Prozesse halten sie möglicherweise geöffnet, und sie ihnen unter den Füßen auf
DELETEumzustellen würde ihre nicht committeten Schreibvorgänge zerstören. Hermes behält WAL also bei – und sagt es. Genau das fügt PR #111433 hinzu: einmal pro Prozess ein ERROR beim Start, plus eine passende Warnung inhermes doctormit ausgeschriebener Lösung.
Bei einer gesunden Datenbank gibt doctor eine Info-Zeile wie → state.db: WAL journal mode (264.0 KB) aus. Sobald die Datenbank auf einem Cross-VM-Mount liegt, wird diese Zeile zu einer Warnung, die beide Abhilfen wortwörtlich mitbringt:
$ hermes doctor
  ⚠ state.db is in WAL mode on a cross-VM filesystem (virtiofs/9p, 264.0 KB) (WAL can silently
    corrupt across the VM boundary; stop every Hermes process and run a one-time offline
    'PRAGMA journal_mode=DELETE' on the file, then set `database.journal_mode: delete` — or move
    the database onto a native/named volume)
Diese Warnung rangiert über dem WAL-Reset-Hinweis, mit der Begründung, dass aktive Korruption eine latente Bug-Klasse schlägt. Die Deduplizierung ist auf den Datenbankpfad geschlüsselt, sodass ein Gateway, das mehrere Profile bedient, jede betroffene Datenbank meldet und nicht nur die erste.
Fix eins: offline auf DELETE umstellen und festschreiben
Fang damit an, jeden Hermes-Prozess zu stoppen, der diese Datenbank nutzt – Gateway, Cron und interaktive Sessions zählen alle mit. Eine Live-Konvertierung würde die nicht committeten Schreibvorgänge anderer Öffner verwerfen, deshalb weigert sich Hermes bewusst, das für dich zu erledigen.
Führe dann die einmalige Offline-Konvertierung aus. Das veröffentlichte Image bringt libsqlite3 mit, aber keine sqlite3-Shell, also nutze das Python, das schon im Image ist:
docker exec hermes python3 -c "import sqlite3; print(sqlite3.connect('/opt/data/state.db').execute('PRAGMA journal_mode=DELETE').fetchone()[0])"Ein delete in der Ausgabe heißt, dass die Umstellung funktioniert hat. Jetzt schreibe sie in config.yaml fest, sonst schaltet das nächste Öffnen sie gemäß dem Default wieder auf WAL zurück:
database:
  # Default ist wal. Nutze delete auf Cross-VM-Bind-Mounts, NFS oder SMB.
  journal_mode: delete
Der Trade-off ist die Nebenläufigkeit: Der Rollback-Journal-Modus erlaubt nur einen Writer gleichzeitig und lässt Reader und Writer aufeinander warten. Ein Single-User-Agent wird es nicht bemerken. Ein Deployment, das ein Gateway neben mehreren Workern betreibt, wird öfter auf database is locked stoßen.
Fix zwei: die Datenbank auf ein natives oder Named Volume verschieben
Wenn du WALs Nebenläufigkeit lieber behalten möchtest, ersetze den Host-Bind-Mount durch ein Docker Named Volume – docker run -v hermes-data:/opt/data. Ein Named Volume liegt auf dem eigenen ext4-Dateisystem der VM, wo WAL vollkommen sicher ist. Das Problem war nie „WAL in einem Container“; es war ein Verzeichnis, das eine VM-Grenze überspannt.
Cheat Sheet der Mount-Typen
| Mount-Typ | WAL sicher? | Was Hermes tut |
|---|---|---|
Host-Bind-Mount von Docker Desktop / OrbStack (virtiofs) |
Nein | Frische DBs bekommen DELETE; eine bestehende WAL-DB loggt einen ERROR beim Start und doctor markiert sie |
Docker Desktop unter Windows (9p / drvfs) |
Nein | Dasselbe |
Docker Named Volume, natives Verzeichnis (ext4, btrfs, xfs, zfs, tmpfs, overlay) |
Ja | Behält WAL und sagt nichts |
| NFS / SMB / generisches FUSE | Nicht automatisch klassifiziert | Wird gar nicht erkannt; setze database.journal_mode: delete selbst |
Warum Hermes es nicht einfach für dich repariert
Ein paar bewusste Trade-offs sind es wert, gekannt zu werden, weil sie das Verhalten erklären, das du tatsächlich beobachten wirst.
Kein Live-Downgrade. Eine WAL-Datenbank, die andere Prozesse geöffnet halten, auf der Stelle auf DELETE umzustellen bedeutet, ihre nicht committeten Schreibvorgänge wegzuwerfen. Hermes loggt lieber einen Fehler und lässt dich ein Wartungsfenster wählen.
Kein locking_mode=EXCLUSIVE. Es sieht wie die naheliegende Notlösung aus und ist eine schlechte: Ein exklusiver Lock würde das Cross-VM-Lock-Kohärenzproblem umgehen, aber die Gateway-, Cron- und Worker-Prozesse öffnen state.db konstruktionsbedingt gleichzeitig, es würde also gelegentliche Korruption gegen database is locked auf jeder Oberfläche eintauschen.
Keine automatische NFS- oder SMB-Erkennung. Die Autoklassifizierung deckt nur die virtiofs- und 9p-Familien ab; NFS, SMB und generisches FUSE sind nicht dabei. Wenn dein Datenverzeichnis auf NFS oder SMB liegt, setze database.journal_mode: delete selbst.
Diese Fixes kamen als ein Arbeitslauf: #98965 stoppte, dass state.db auf Docker-Desktop-/OrbStack-Bind-Mounts still beschädigt wird, #110544 ließ WAL Geschwister-Schließungen und verirrte Lock-Abbruche überleben, #109541 leitete jeden kleinen Store durch eine einzige open_db-Transaktion mit Plugin-Datenbanken auf demselben WAL-Fallback – und #111433 fügte das Signal für den Operator hinzu, den Startup-Fehler und die doctor-Prüfung.
Wenn deine state.db schon einmal beschädigt wurde, fang mit wie state.db sich selbst heilt an. Ist das Symptom „database is locked“ statt „database is corrupt“, ist das ein anderer Fehler mit anderen Fixes – siehe die state.db Lock-Fixes. Zu den Fallstricken beim Betrieb von mehr als einem Container gegen dasselbe Datenverzeichnis geht der Shared-Container-Leitfaden tiefer. Und die erste Station bei jedem Health Check ist immer die hermes doctor Referenz.