De Onde Vem Realmente o «database is locked»: o Hermes Corrigiu a Contenção de Locks, Escritores Duplicados e um Falso Alarme
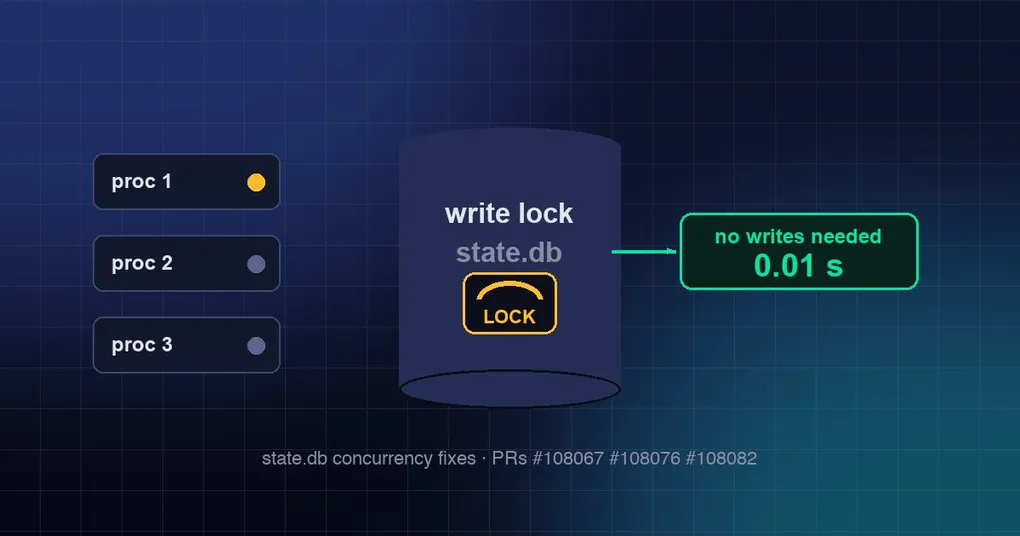
Você agendou um cron job na noite de domingo. Na manhã de segunda você abre um terminal para ler os resultados, e o primeiro comando simplesmente fica parado. Vinte segundos depois ele desiste com database is locked. Você não está rodando duas instâncias do Hermes. Você nunca tocou no banco de dados à mão. Então quem pegou o lock?
Um conjunto de correções mesclado em 11 de setembro responde a isso, e a resposta é contraintuitiva: o lock era o próprio Hermes assumindo autoridade de escrita toda vez que abria o armazenamento de sessões — e vários processos nunca deveriam tocar naquele arquivo em primeiro lugar. A seguir: quem estava pegando o lock, quem estava escrevendo em silêncio e o que foi julgado errado.
1. Abrir o armazenamento exigia um lock de escrita mesmo quando nada precisava ser escrito
Contexto: o Hermes mantém cada sessão em um arquivo SQLite chamado state.db — session_search, hermes sessions, exportações e insights leem dele. A regra de concorrência do SQLite é direta: uma instrução que poderia escrever pega o lock de escrita, mesmo quando não corresponde a nenhuma linha.
Essa era a armadilha. Toda abertura de leitura-escrita do state.db também executava um conjunto de instruções que não mudavam nada em um banco de dados já estabilizado:
- inserir o carimbo de geração (
INSERT OR IGNORE); UPDATE messages SET active=1 WHERE active IS NULL;- fazer upsert do marcador de versão de armazenamento do FTS;
DROP TRIGGER IF EXISTSmaisCREATE TRIGGERpara quatro triggers de exibição.
Então um banco perfeitamente saudável, sem nada pendente, ainda fazia processos irmãos — um tick de cron, uma chamada hermes sessions, uma verificação do doctor — esperar toda a sua transação. Passada a janela de paciência, a abertura falhava de vez com database is locked.
A correção é ler primeiro e escrever apenas quando algo está de fato desatualizado: inserir o carimbo só quando ele está ausente, corrigir active IS NULL só quando existe uma linha NULL, pular o marcador quando o valor armazenado já corresponde, e recriar triggers só quando a definição guardada em sqlite_master.sql difere da desejada.
Os números do pull request deixam o ponto claro:
| Cenário | Antes | Depois |
|---|---|---|
| Banco estabilizado, irmão segura o lock de escrita por 4 s | a abertura levava 4,14 s | 0,01 s |
| O detentor sobrevive à janela de paciência | database is locked após 20,5 s |
abre normalmente |
O travamento nunca foi «outra pessoa está usando o banco de dados». Foi «pedimos permissão de escrita de que não precisávamos».
2. Quem estava agindo em silêncio como um segundo escritor
O mesmo conjunto de correções encontrou quatro papéis tratando o armazenamento principal de sessões como papel de rascunho:
- O armazenamento de coordenação de group-chat entre profiles ficava no
state.dbdo gateway raiz, enquanto todo gateway de profile inicia aquele worker incondicionalmente — o que tornava cada processo de profile um escritor de longa duração no armazenamento mestre de sessões. Agora ele usashared-state.dbsob a raiz de instalação. - O web dashboard agora reconcilia o schema na inicialização por meio de uma abertura somente leitura. Um armazenamento saudável vê zero aberturas graváveis; só um schema realmente quebrado faz a única passagem gravável.
- A guarda de ciclo de vida do cron varria o texto do comando em busca de tokens com aparência de caminho e os lia com um
os.opencru. Um comando que apenas mencionasse ostate.dbdo gateway podia cancelar os locks POSIX do gateway. Essas leituras agora passam pelo registro rastreado de acesso offline a arquivos. hermes doctor --fixagora verifica se há um escritor ativo antes do seu checkpoint de WAL. Sob um gateway em execução, ele pula o checkpoint com uma constatação acionável em vez de entrar no WAL como segunda conexão.
Juntas, essas correções explicam por que database is locked continuava voltando em máquinas reais: não um bug, mas um banco de dados com vários escritores.
3. Um WAL saudável foi declarado morto
A terceira classe é mais sutil. O Hermes tem uma guarda: se os arquivos sidecar de WAL do state.db forem desvinculados, ele cai para o armazenamento JSONL — mais lento, mas seguro. A evidência antiga era o sufixo " (deleted)" nas entradas de /proc/<pid>/fd.
No OpenZFS, um arquivo -wal/-shm vivo e ainda vinculado é reportado exatamente assim (dentry sem hash, nlink=1). Então a guarda disparava permanentemente e o gateway rodava em JSONL para sempre — degradado, e completamente silencioso sobre isso.
A verificação agora compara o (st_dev, st_ino) do descritor de arquivo com o caminho que está sendo observado no momento. Um órfão real mantido vivo por um hard link ainda é capturado, então a guarda continua fail-closed.
Duas condições de corrida da mesma família também foram corrigidas:
- O caminho de escrita executava sua sonda de «sidecars desapareceram» antes de pegar seu próprio lock, enquanto
close()desvincula os sidecars sob aquele lock. Um escritor correndo contra um desligamento limpo marcava a si mesmo com a flag pegajosa «geração de WAL perdida». A sonda agora roda dentro do lock — onze linhas. - Quando a sonda de WAL era indeterminada, o helper retornava
"wal"como o modo presumido, e oSessionDBhabilitava seu pool de leitura sem lock com base nessa presunção. Se o arquivo estivesse de fato em modo DELETE, o pool estava errado. Agora o cabeçalho precisa ser confirmado; quando não é possível, as leituras entram na fila do lock de escrita.
4. Uma linha ruim não deveria destruir a tabela inteira
Deixando o lock de lado, havia um ponto de avalanche: uma única linha ruim podia matar um comando inteiro. As formas vistas na prática incluem um timestamp de lixo em TEXT, JSON malformado em model_config e uma exclusão em massa que ultrapassou o teto de variáveis vinculadas do SQLite.
As vítimas foram hermes sessions list, hermes sessions browse, a exportação de sessões (JSONL / Markdown / HTML), hermes insights e sessions prune.
Agora há guardas dos dois lados:
- As leituras passam por
hermes_cli.timefmt.coerce_epoch(), que converte uma célula armazenada em segundos de epoch dentro de uma janela razoável (de 1970 até cerca de 2103, dentro dotime_tde 32 bits) ou não retorna nada — depois de um WARNING nomeando o id da sessão. A célula ruim é renderizada como?ouN/Ae o comando termina. - As escritas aplicam a mesma janela: um timestamp fora da janela cai para o horário atual, assim o Hermes não pode persistir uma nova linha ruim.
- Os marcadores JSON são protegidos com
json_validem todo lugar ondemodel_configé lido. - O trabalho em massa divide suas listas
INpara evitar «too many SQL variables», e a consulta N+1 do exportador agora hidrata mensagens em lotes de 900 ids.
5. As sessões não visitam mais outros profiles
Se você roda mais de um profile, duas dessas correções são diretamente para você:
- O backend de lançamento do desktop chamava
acquire()sem um caminho, então seu primeiro toque resolviaHERMES_HOMEsob qualquer override de contexto que estivesse ativo naquele instante. Se a janela de override de outro profile estivesse aberta, o handle de tempo de vida do processo apontava para o armazenamento daquele profile para sempre. Agora ele é fixado ao home de lançamento. - A varredura de fallback por id simples no
session_searchacabou. Antes, um erro no seu próprio armazenamento fazia ele abrir o banco de cada profile e retornar a transcrição completa do primeiro dono — sem nomear o profile. Agora um não-encontrado é um não-encontrado, com uma dica para passarprofile=ou@session:<profile>/<id>.
Excluir um profile também fecha os handles compartilhados deste processo antes de remover o diretório, o que corrige a falha WinError 32 (arquivo em uso) no Windows.
6. Um índice de busca danificado não é uma transcrição danificada
Mais uma prática: um índice FTS5 corrompido dentro do state.db era reportado como corrupção do arquivo inteiro, empurrando as pessoas para o caminho pesado de recuperação.
Agora os erros são classificados por proveniência: uma falha levantada das tabelas shadow messages_fts* se torna a causa de persistência fts_index, e a superfície diz «busca degradada, transcrição canônica intacta». Além disso:
hermes doctorresolve tree ids danificados por meio desqlite_master.rootpage, então ele pode dizer se o índice ou as tabelas estruturais estão danificados antes de recomendar recuperação;hermes sessions repair --check-onlysai com código diferente de zero em um armazenamento não saudável, o que o torna scriptável;- a via de recuperação lida com as formas com que bancos de incidentes reais de fato chegam: um cabeçalho da página 1 rasgado, linhas NOT NULL fantasmas, uma borda de rowid danificada, uma família de índices CJK e tabelas shadow órfãs deixadas por
.recover.
O que você deve fazer
Atualize para o build mais recente (hermes update). Para verificar sua própria máquina, três comandos cobrem a maior parte:
hermes sessions list --limit 5   # a lista ainda lê sem problemas?
hermes sessions repair --check-only   # código de saída diferente de zero em um armazenamento não saudável
hermes doctor --fix              # nomeia dano de índice vs estrutural, depois o próximo passo
Se você roda múltiplos profiles, nomeie o profile explicitamente:
hermes -p worker doctor --fixA conclusão
O que une essas correções é que «o lock» nunca foi uma coisa só. Era autoridade de escrita desnecessária, vários processos competindo para ser o único escritor, e um falso alarme que rebaixou o armazenamento em silêncio para sempre. Para os usuários, a mudança mais visível é simples: um banco estabilizado deveria abrir instantaneamente, não fazer você encarar um prompt por vinte segundos.
Para a rodada anterior de autocorreção — detecção, quarentena, reparo — veja o state.db se curando sozinho. Para entender por que sessões de longa duração são o padrão errado e como a memória é projetada em torno das fronteiras de sessão, leia fronteiras de sessão. Os comandos do dia a dia estão na referência do hermes sessions, e este conjunto de correções está em main por enquanto — ele aparecerá nas notas de versão quando a próxima release for publicada.