D'où vient réellement « database is locked » : Hermes corrige la contention de verrou, les writers en double et une fausse alerte
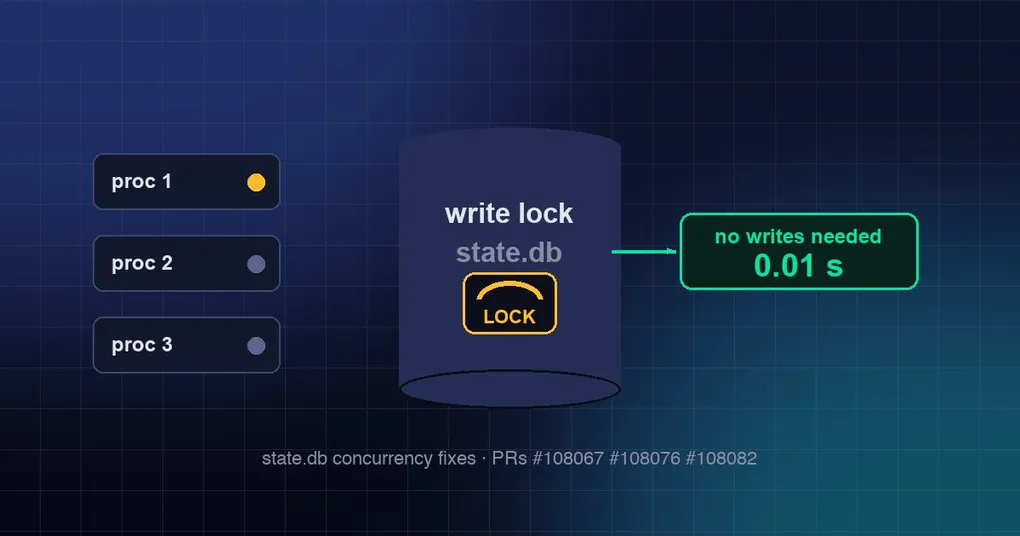
Vous avez mis en place un cron job le dimanche soir. Le lundi matin, vous ouvrez un terminal pour lire les résultats, et la première commande reste simplement bloquée. Vingt secondes plus tard, elle abandonne avec database is locked. Vous n’exécutez pourtant pas deux instances de Hermes. Vous n’avez jamais touché la base de données à la main. Alors qui a pris le verrou ?
Une série de correctifs fusionnés le 11 septembre répond à cette question, et la réponse est contre-intuitive : le verrou venait de Hermes lui-même, qui prenait l’autorité d’écriture à chaque ouverture du stockage de sessions — et une poignée de processus n’auraient jamais dû toucher ce fichier. Ci-dessous : qui prenait le verrou, qui écrivait discrètement, et ce qui a été mal jugé.
1. Ouvrir le stockage prenait un verrou d’écriture même quand rien n’avait besoin d’être écrit
Contexte : Hermes conserve chaque session dans un fichier SQLite appelé state.db — session_search, hermes sessions, les exports et les insights le lisent tous. La règle de concurrence de SQLite est sans détour : une instruction qui pourrait écrire prend le verrou d’écriture, même lorsqu’elle ne correspond à aucune ligne.
C’était le piège. Chaque ouverture en lecture-écriture de state.db exécutait aussi une série d’instructions qui ne changeaient rien sur une base de données au repos :
- l’insertion du cachet de génération (
INSERT OR IGNORE) ; UPDATE messages SET active=1 WHERE active IS NULL;- l’upsert du marqueur de version de stockage FTS ;
DROP TRIGGER IF EXISTSplusCREATE TRIGGERpour quatre triggers d’affichage.
Ainsi, une base de données parfaitement saine, sans rien en attente, obligeait quand même les processus voisins — un tick de cron, un appel hermes sessions, une vérification de doctor — à attendre la fin de toute sa transaction. Au-delà de la fenêtre de patience, l’ouverture échouait purement et simplement avec database is locked.
Le correctif consiste à lire d’abord et à n’écrire que lorsque quelque chose est réellement obsolète : insérer le cachet uniquement s’il est absent, réparer active IS NULL uniquement lorsqu’une ligne NULL existe, ignorer le marqueur lorsque la valeur stockée correspond déjà, et recréer les triggers seulement lorsque la définition enregistrée dans sqlite_master.sql diffère de celle souhaitée.
Les chiffres de la pull request sont éloquents :
| Scénario | Avant | Après |
|---|---|---|
| Base de données au repos, un voisin détient le verrou d’écriture pendant 4 s | l’ouverture prenait 4,14 s | 0,01 s |
| Le détenteur dépasse la fenêtre de patience | database is locked après 20,5 s |
ouverture normale |
Le blocage n’était jamais « quelqu’un d’autre utilise la base de données ». C’était « nous avons demandé une permission d’écriture dont nous n’avions pas besoin ».
2. Qui agissait discrètement comme un second writer
La même série de correctifs a identifié quatre rôles qui traitaient le stockage de sessions principal comme du papier brouillon :
- Le stockage de coordination des group-chats entre profiles vivait sur le
state.dbdu gateway racine, alors que le gateway de chaque profile démarre ce worker sans condition — ce qui faisait de chaque processus de profile un writer de longue durée sur le stockage de sessions maître. Il utilise désormaisshared-state.dbsous la racine d’installation. - Le tableau de bord web réconcilie maintenant le schéma au démarrage via une ouverture en lecture seule. Un stockage sain ne voit aucune ouverture inscriptible ; seul un schéma réellement cassé consomme l’unique passe en écriture.
- Le garde de cycle de vie des crons analysait le texte des commandes à la recherche de jetons ressemblant à des chemins et les lisait avec un
os.openbrut. Une commande qui mentionnait simplement lestate.dbdu gateway pouvait annuler les verrous POSIX de ce dernier. Ces lectures passent désormais par le registre suivi des accès hors ligne aux fichiers. hermes doctor --fixvérifie maintenant qu’aucun writer n’est actif avant son checkpoint WAL. Sous un gateway en cours d’exécution, il saute le checkpoint avec un constat exploitable au lieu de rejoindre le WAL comme seconde connexion.
Pris ensemble, ces éléments expliquent pourquoi database is locked revenait sans cesse sur de vraies machines : non pas un bug unique, mais une base de données avec plusieurs writers.
3. Un WAL sain a été déclaré mort
La troisième catégorie est plus subtile. Hermes dispose d’un garde-fou : si les fichiers sidecar WAL de state.db sont supprimés, il bascule sur le stockage JSONL — plus lent, mais sûr. L’ancienne preuve était le suffixe " (deleted)" dans les entrées de /proc/<pid>/fd.
Sur OpenZFS, un fichier -wal/-shm vivant et toujours lié est rapporté exactement de cette façon (entrée de répertoire non hachée, nlink=1). Le garde-fou se déclenchait donc en permanence et le gateway tournait sur JSONL pour toujours — dégradé, et totalement silencieux à ce sujet.
La vérification compare désormais le (st_dev, st_ino) du descripteur de fichier avec le chemin actuellement surveillé. Un vrai orphelin maintenu en vie par un lien matériel est toujours détecté, si bien que le garde-fou reste fail-closed.
Deux races de la même famille ont également été corrigées :
- Le chemin d’écriture exécutait sa sonde « les sidecars ont disparu » avant de prendre son propre verrou, tandis que
close()supprime les sidecars sous ce verrou. Un writer en course avec un arrêt propre se marquait lui-même du drapeau collant « WAL generation lost ». La sonde s’exécute désormais à l’intérieur du verrou — onze lignes. - Lorsque la sonde WAL était indéterminée, le helper renvoyait
"wal"comme mode présumé, etSessionDBactivait son pool de lecture sans verrou sur cette hypothèse. Si le fichier était en réalité en mode DELETE, le pool était incorrect. L’en-tête doit maintenant être confirmé ; quand il ne peut pas l’être, les lectures se mettent en file sur le verrou d’écriture.
4. Une mauvaise ligne ne devrait pas détruire toute la table
Le verrouillage mis à part, il existait un point d’avalanche : une seule ligne défectueuse pouvait tuer une commande entière. Les formes observées en production incluent un timestamp TEXT corrompu, un JSON model_config malformé et une suppression en masse dépassant le plafond de variables liées de SQLite.
Les victimes étaient hermes sessions list, hermes sessions browse, l’export de sessions (JSONL / Markdown / HTML), hermes insights et sessions prune.
Désormais, des garde-fous existent des deux côtés :
- Les lectures passent par
hermes_cli.timefmt.coerce_epoch(), qui convertit une cellule stockée en secondes epoch dans une fenêtre raisonnable (de 1970 jusqu’à environ 2103, à l’intérieur dutime_t32 bits) ou ne renvoie rien — après un WARNING nommant l’id de session. La cellule défectueuse s’affiche sous la forme?ouN/Aet la commande se termine. - Les écritures appliquent la même fenêtre : un timestamp hors fenêtre retombe sur l’instant présent, si bien que Hermes ne peut pas persister une nouvelle ligne défectueuse.
- Les marqueurs JSON sont protégés par
json_validpartout oùmodel_configest lu. - Le travail en masse découpe ses listes
INpour éviter « too many SQL variables », et la requête N+1 de l’exportateur hydrate désormais les messages par lots de 900 ids.
5. Les sessions ne visitent plus les autres profiles
Si vous exécutez plusieurs profiles, deux de ces correctifs vous concernent directement :
- Le backend de lancement du desktop appelait
acquire()sans chemin, si bien que son premier accès résolvaitHERMES_HOMEsous la substitution de contexte active à cet instant. Si la fenêtre de substitution d’un autre profile était ouverte, le handle de durée de vie du processus pointait vers le stockage de ce profile pour toujours. Il est désormais épinglé au home de lancement. - L’analyse de repli sur id nu dans
session_searcha disparu. Auparavant, une absence dans votre propre stockage le faisait ouvrir la base de données de chaque profile et renvoyer la transcription complète du premier propriétaire — sans nommer le profile. Une absence est désormais une absence, avec une indication d’utiliserprofile=ou@session:<profile>/<id>.
Supprimer un profile ferme aussi les handles partagés de ce processus avant de retirer le répertoire, ce qui corrige l’échec WinError 32 (fichier utilisé) sous Windows.
6. Un index de recherche endommagé n’est pas une transcription endommagée
Un dernier point très concret : un index FTS5 corrompu à l’intérieur de state.db était signalé comme une corruption du fichier entier, ce qui poussait les gens vers le lourd chemin de récupération.
Les erreurs sont désormais classées par provenance : un échec remonté depuis les tables fantômes messages_fts* devient la cause de persistance fts_index, et l’interface indique « search degraded, canonical transcript intact ». En complément :
hermes doctorrésout les ids d’arbre endommagés viasqlite_master.rootpage, ce qui lui permet de vous dire si l’index ou les tables structurelles sont endommagés avant de recommander une récupération ;hermes sessions repair --check-onlysort avec un code non nul sur un stockage en mauvaise santé, ce qui le rend scriptable ;- la voie de récupération gère les formes dans lesquelles arrivent réellement les bases d’incident : un en-tête page-1 déchiré, des lignes fantômes NOT NULL, un bord de rowid endommagé, une famille d’index CJK et des tables fantômes orphelines laissées par
.recover.
Ce que vous devriez faire
Passez à la dernière build (hermes update). Pour vérifier votre propre machine, trois commandes couvrent l’essentiel :
hermes sessions list --limit 5   # la liste se lit-elle encore proprement ?
hermes sessions repair --check-only   # code de sortie non nul sur un stockage en mauvaise santé
hermes doctor --fix              # distingue index et dommage structurel, puis donne l'étape suivante
Si vous exécutez plusieurs profiles, nommez le profile explicitement :
hermes -p worker doctor --fixÀ retenir
Ce qui relie ces correctifs, c’est que « le verrou » n’a jamais été une seule chose. C’était une autorité d’écriture inutile, plusieurs processus en compétition pour être l’unique writer, et une fausse alerte qui a discrètement dégradé le stockage pour toujours. Pour les utilisateurs, le changement le plus visible est simple : une base de données au repos devrait s’ouvrir instantanément, sans vous faire fixer une invite pendant vingt secondes.
Pour la précédente vague d’auto-réparation — détection, quarantaine, réparation — voir state.db se répare tout seul. Pour comprendre pourquoi les sessions de longue durée sont un mauvais choix par défaut et comment la mémoire est conçue autour des frontières de session, lisez les frontières de session. Les commandes du quotidien se trouvent dans la référence hermes sessions, et cette série est pour l’instant sur main — elle apparaîtra dans les notes de version dès que la prochaine version sortira.