Rodando o Hermes Agent no Kubernetes: sem Helm chart oficial, uma réplica só e um contêiner que inicia como root
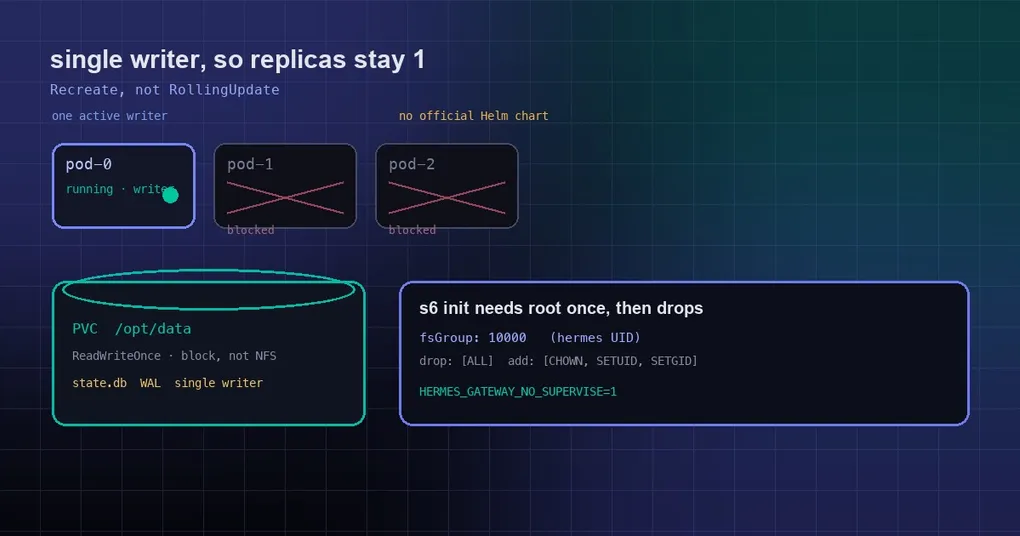
Você deixou o Hermes funcionando que é uma beleza no seu laptop — memória, skills, cron jobs, tudo. Agora você está o movendo para um cluster, então escreve um Deployment perfeitamente razoável: replicas: 3, atualizações rolling, runAsNonRoot: true, dados em NFS. Os pods sobem, e aí começa o comportamento estranho. O histórico de sessão não bate. Os contêineres saem no boot. Você muda um ConfigMap e nada acontece.
O Hermes roda bem no Kubernetes — depois que você aceita que algumas coisas no seu contêiner colidem de frente com os padrões de cluster. A documentação oficial do Docker já descreve essas coisas; o que ela não faz é dizer qual frase importa num contexto de Kubernetes. Aqui vão elas na ordem em que vão realmente te morder.
Regra um: um HERMES_HOME, um writer
Comece pelo fato do qual tudo o resto depende: todo o estado mutável do Hermes vive sob HERMES_HOME — config, arquivos de memória, skills e histórico de sessão num banco SQLite local. Na imagem oficial, esse caminho é /opt/data, que a documentação do Docker chama de fonte única de verdade de todo o estado do Hermes.
A documentação então diz algo direto: nunca rode dois contêineres gateway do Hermes contra o mesmo diretório de dados ao mesmo tempo — arquivos de sessão e stores de memória não foram feitos para escrita concorrente. A mesma página explica por quê: o arquivo PID do gateway e o nome do serviço systemd são ambos delimitados por HERMES_HOME, o que é o próprio sinal da upstream de que essa é a unidade de isolamento.
Traduzindo para termos de Kubernetes:
replicaCountfica em 1 sempre que a persistência está ligada;- a estratégia de update precisa ser
Recreate, nuncaRollingUpdate— um rolling update roda de propósito o pod antigo e o novo ao mesmo tempo, que é exatamente a janela de dois writers que você quer evitar; - prefira
ReadWriteOnceno PVC.RWXnão é automaticamente inseguro — o invariante real é um writer ativo, não um mount — masRWOimpõe isso na camada de storage em vez de confiar no seu manifest.
Precisa de mais de um time? Isso é uma release por tenant, cada uma com o seu próprio volume, não mais réplicas por release.
Regra dois: mantenha o SQLite fora de um filesystem de rede entre VMs
Essa é esquecida com mais frequência do que contagens de réplica, porque falha em silêncio. O Hermes abre o state.db em modo WAL do SQLite por padrão, e o WAL depende de um arquivo de memória compartilhada (state.db-shm) que se mantém coerente entre todo processo que tem o banco aberto. Mounts que cruzam a fronteira de uma VM — virtiofs no macOS, 9p / drvfs no Windows — deixam writers concorrentes corromperem um banco WAL em silêncio, enquanto o arquivo principal ainda passa num integrity check.
Num cluster, o equivalente é uma storage class NFS ou CIFS. Use block storage local ao node (as classes de SSD block da nuvem) para o volume de dados; se não puder, siga a receita deste guia para converter o journal mode para DELETE e fixá-lo. Não trate “o mount funciona” como “o banco está seguro”.
Regra três: o contêiner inicia como root — o agent não
Dizer “a imagem oficial precisa rodar como root” está errado, mas é impreciso de um jeito que importa quando você está discutindo uma isenção de Pod Security Standard com o time de plataforma.
A imagem usa o s6-overlay como init system. Seu /init roda como root para poder dar chown no volume no primeiro boot, e depois desce para o usuário hermes via s6-setuidgid para o programa principal e todo serviço supervisionado. A imagem até traz um shim que detecta chamadas de root em docker exec e re-executa via s6-setuidgid hermes.
Então só o bootstrap é root; o agent não. Isso ainda basta para quebrar um security context restrito: um pod com runAsNonRoot: true ou um runAsUser diferente de zero falha antes mesmo de o agent iniciar, com algo assim:
/package/admin/s6-overlay/libexec/preinit: fatal: /run belongs to uid 0 instead of 1000,
has insecure and/or unworkable permissions, and we're lacking the privileges to fix it.
s6-overlay-suexec: fatal: child failed with exit code 100
Um detalhe que exemplos publicados erram com frequência: o usuário hermes é UID 10000, não 1000. A imagem o cria com useradd -u 10000 -m -d /opt/data hermes e não define nenhuma instrução USER — o contêiner inicia como root de propósito e derruba os privilégios sozinho. Defina fsGroup: 1000 e o seu volume acaba dono do grupo errado.
Um ponto de partida que funciona (trate a lista de capabilities como um checklist, já que as necessidades do s6 mudam entre versões da imagem):
podSecurityContext:
  runAsUser: 0
  runAsNonRoot: false
  fsGroup: 10000
  fsGroupChangePolicy: OnRootMismatch
  seccompProfile:
    type: RuntimeDefault
containers:
  - name: hermes
    securityContext:
      allowPrivilegeEscalation: true
      readOnlyRootFilesystem: false
      runAsNonRoot: false
      capabilities:
        drop: ["ALL"]
        add: ["CHOWN", "SETUID", "SETGID"]
Isso é bem mais estreito que um pod privilegiado: largue tudo e readicione só o que o bootstrap precisa. Se o seu cluster impõe o Pod Security Standard restricted, essa carga precisa de uma isenção de namespace — você não deixou passar nenhuma configuração, a imagem simplesmente não foi feita para iniciar non-root.
Regra quatro: quando a plataforma embrulha o PID 1, a supervisão do s6 fica muda
O entrypoint da imagem é um dispatcher, e o suexec do s6-overlay exige ser PID 1. Quando uma plataforma embrulha o entrypoint sob o seu próprio init, o caminho documentado pela upstream é que o dispatcher roda o bootstrap de stage two diretamente e executa o wrapper principal sem s6. A documentação cita docker run --init e “alguns setups de Nomad/Kubernetes” como os casos que caem nisso.
Duas consequências importam:
- Se algo na sua stack injeta um processo init — um pod com
shareProcessNamespace: true, certos injectors de sidecar, um runtime configurado para adicionar um — você perde a supervisão do s6 em silêncio. O agent continua rodando; só não está mais sendo reiniciado pelo s6. - Isso não é necessariamente ruim. Num cluster, você geralmente quer que a restart policy do Kubernetes seja o supervisor, e não um process manager dentro do contêiner. Mas o modelo de falha muda, então saiba em qual caminho você está. Se você quer o comportamento sem s6 de propósito, peça por ele com
--no-superviseouHERMES_GATEWAY_NO_SUPERVISE=1em vez de contar com um acidente no tratamento do PID 1. Os dois são no-ops fora da imagem s6.
Regra cinco: mudanças de config não têm endpoint HTTP de reload
Essa é a chata para GitOps. O Hermes te dá /reload-mcp (recarrega servidores MCP a partir do config.yaml) e /reload-skills (reescaneia o diretório de skills) dentro de uma conversa, mas o servidor de API expõe nenhum endpoint HTTP equivalente. A solicitação de recurso da comunidade exatamente para isso, a issue #52417, continua aberta com prioridade baixa.
Então quando o seu pipeline atualiza um ConfigMap, não existe hook de reconciliação nativo. As suas opções realistas são acionar o caminho de reload em runtime (rodar o slash command numa sessão) ou reiniciar a carga — e reiniciar te traz de volta à restrição de Recreate, não RollingUpdate.
E sim: não existe Helm chart oficial
A documentação da upstream cobre install.sh, Docker, Docker Compose e pacotes Nix. Kubernetes simplesmente não é um alvo de deploy prometido, e a solicitação de recurso por uma história oficial de empacotamento — Dockerfile, Helm chart, RBAC e smoke tests de uma vez — é a issue #85474, aberta em agosto de 2026 e ainda aberta.
Existem tentativas da comunidade, como ultraworkers/hermes-agent-helm-chart (cerca de 140 stars, último push em abril), além de alguns operators pessoais. Nenhuma delas é mantida pela Nous Research, e as versões de chart avançam independentemente do Hermes. Se você usar uma, leia os templates de ponta a ponta, sobrescreva o security context você mesmo e confira contra as cinco regras acima — qualquer uma delas faltando em silêncio é um risco de corrupção de dados esperando por um rollout ruim.
Checklist de um deployment mínimo
- Uma release, um PVC,
ReadWriteOnce, montado em/opt/data; replicas: 1estrategy.type: Recreate;- o volume de dados em block storage local ao node, nunca NFS;
- aceite root no bootstrap, use
fsGroup: 10000, largue todas as capabilities e readicione apenasCHOWN,SETUID,SETGID; - decida de propósito se você quer a supervisão do s6 e diga isso com
--no-superviseouHERMES_GATEWAY_NO_SUPERVISE=1; - trate mudanças de config como restart-ou-slash-command, nunca como hot reload via HTTP;
- dimensione os recursos a partir da orientação oficial do Docker e deixe folga para automação de browser (Playwright/Chromium), que é a coisa que mais consome recursos no Hermes.
A versão curta
O Hermes roda de forma estável no Kubernetes desde que você o trate como um serviço stateful single-writer, e não como um app stateless doze-fatores. Escreva essas restrições nos seus manifests e na documentação do seu time — writer único, storage local ao node, root no bootstrap, sem reload HTTP — e o resto é como qualquer outra carga stateful.
Se você ainda está num único host Docker, compartilhar um contêiner entre perfis dá menos trabalho. E se você ainda não instalou, comece pelo guia de instalação.