你改好了文件,内核还在跑旧代码:execute_code 现在会当场告诉你
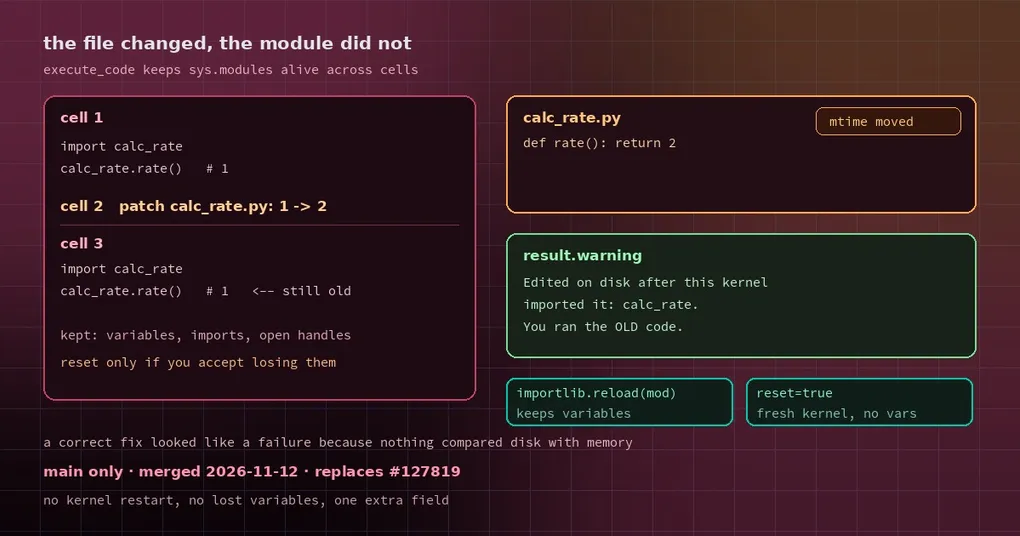
你让 Hermes 去修一个小 bug:calc_rate() 应该返回 2,现在返回 1。它读了文件、改了代码、用 execute_code 跑了一遍验证,输出还是 1。它再读一次文件,确认改动确实写进去了,然后开始道歉——或者更糟,把正确的代码再“改”一遍,或者干脆放弃说“这个 bug 和环境有关”。
真正发生的事很简单:代码确实改对了,但你看到的 1 来自内存里的旧模块。会话内核把 sys.modules 跨越调用保留着,文件在磁盘上变了,它并不知情。结果看起来完全正常,没有任何东西告诉你为什么。
2026 年 11 月 12 日合并的 PR #153665 让这件事变得可见:execute_code 现在会在结果里点名哪些模块是在内核载入之后被改过的。
一句话说清原理:Python 的 import 是一次性的
在普通脚本里这不成问题:每次 python script.py 都是全新进程,import 从头再来一遍。
execute_code 不是这样。为了让你能“上一格定义的变量这一格继续用”,它把一个内核进程留着,多个单元格在同一个进程里跑。代价就是 sys.modules 里的模块对象一直活着——你的 import calc_rate 发生在它被修改之前,那这个对象就永远是旧的那一版。
于是出现一种特别折磨人的错位:文件内容是对的,read_file 读出来是对的,模型推理也是对的,只有执行结果是旧的。模型没有办法从输出里看出这一点,只能胡乱猜测。
改了什么:每个单元格跑完记一次文件的修改时间
内核现在做两件事:
- 每个单元格执行完之后,记录本会话里所有被 import 的项目模块的源码修改时间(mtime)。
- 下一个单元格执行之前,比对一遍:哪些文件的 mtime 变了,就把名字放进结果的
warning里。
标准库和 site-packages / dist-packages 里的模块直接跳过——你不需要知道 pip 包里发生了什么。扫描读的是每个模块自己的字典,遇到读不动的东西(惰性模块、非模块对象)就跳过,绝不会因为 sys.modules 里有个奇怪条目就让整个单元格失败。模块名来自单元格进程,所以主进程只保留合法的点分标识符,并且按 stdout 同样的规则做敏感信息脱敏。
结果长这样(这是真实跑出来的原文,本地内核放在 warning 字段,远程内核放在 kernel.warning):
Edited on disk after this kernel imported it: calc_rate. If this cell used it
without reloading, it ran the OLD code. Run importlib.reload(<module>) (and
re-import any names taken from it), or call again with reset=true to start
from fresh imports.
用 nvidia/nemotron-3.5-super-vl 在 Nous Portal 上跑同一段提示词,两个分支的对比:
| 旧行为 | 新行为 | |
|---|---|---|
| 第三个单元格的输出 | rate 1 | rate 1 |
| 第三个单元格的结果 | 无提示 | warning:点名 calc_rate 并给出两种修法 |
| 模型自己的复述 | “打印了 rate 1,没有警告文字” | “打印了 rate 1,并警告:模块在磁盘上被改过……” |
| 内核状态 | 保留 | 保留 |
最后一行是关键:没有丢掉任何东西。变量、import、打开的文件句柄都还在。只是结果多了一个字段。名字只说一次,已经 reload 或重新 import 过的模块不会再被点名。
两种补救办法,代价不一样
办法一:importlib.reload()。 保留变量,重新载入模块:
import importlib
import calc_rate

importlib.reload(calc_rate)
calc_rate.rate() # 现在跑的是磁盘上的新代码注意一个细节,警告里也写了:from mod import f 拿到的名字绑定的是旧对象,reload 之后 f 还指向旧的。要么重新 import 一次,要么全部用 mod.f() 的方式调用。
办法二:reset=true。 重开一个内核,从干净的 import 开始。代价是这个会话里的变量全没了——如果你刚花十分钟载入了一个大 DataFrame,别这么做。
为什么不是“改文件就重启内核”
有个更早的 PR(#127819)就是这么做的:只要工作目录下有 .py 文件被编辑,就重启整个内核。听上去很干脆,实际很粗暴——变量、载入的数据集全部丢失,而且哪怕你改的那个文件根本没人 import,也照样重启。
现在的做法更小:内核继续活着,只在真的被 import 过的模块上提示,并且说清代价。这个思路上的取舍也体现在不覆盖的场景里,了解边界比了解功能更有用:
- 编译扩展(
.so/.pyd)和没有__file__的模块不监控。 - 同一个单元格里先 import 再改文件,不报告——内核分辨不出这和常见的“先写后 import”有什么区别。
- 同一个单元格里改完再 reload,如果 reload 本身失败了(比如有语法错误),那个单元格的 traceback 里会有错误,但下一个单元格不会再补一条警告。
- 扫描无法判断这个单元格到底有没有用到那个模块,所以措辞是条件式的(“如果这个单元格用了它而没有重载”),而不是断言。
这对日常工作意味着什么
如果你的工作流是“agent 写代码 → 跑一次 → 看到失败 → 再改 → 再跑”,那这个提示会直接省掉几轮瞎猜。看到这个 warning 的时候,正确的动作是 reload 或 reset,而不是继续怀疑自己的修改。
顺带一提,execute_code 还有另一类“看起来像 bug 其实不是”的情况:循环检测器误杀和编辑重发后的重放。命令层面的完整参数(包括 reset)在命令参考里。
上线状态
PR #153665 于 2026 年 11 月 12 日合并进 main,标题里明确写了它取代 #127819。v0.23.1 发布于 11 月 10 日,不含这次改动;要么等下一个版本,要么从 main 装。官方文档 code-execution.md 里新增的 “Edited modules” 段落随代码一起进了仓库。
更新(2026-11-17):这里说的改动已随 v0.23.2 发布(2026-11-16),
hermes update就能拿到。上文「不在 v0.23.1 里」是发布当时的快照。