Du hast die Datei repariert, der Kernel lief weiter den alten Code: execute_code sagt es jetzt
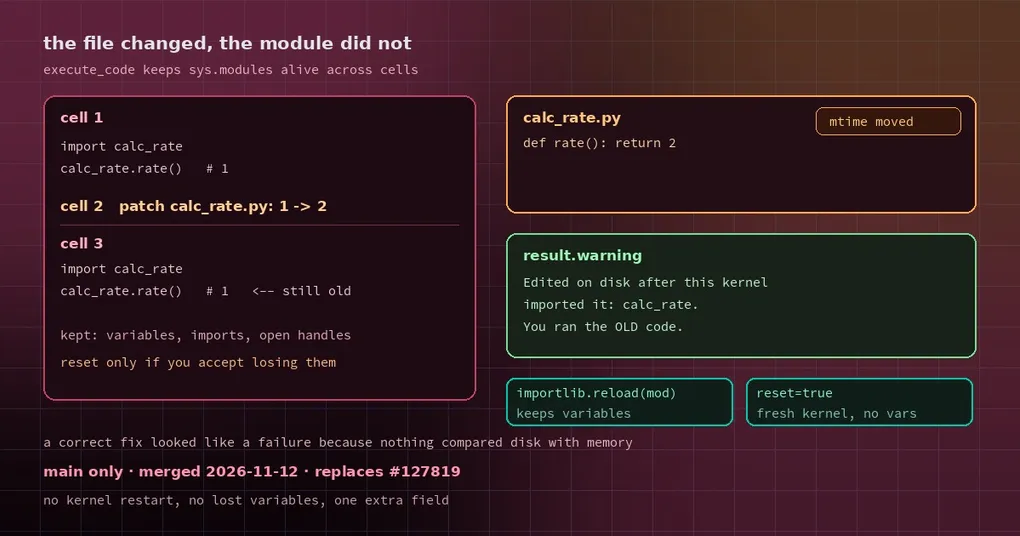
Du bittest Hermes, einen kleinen Bug zu fixen: calc_rate() soll 2 zurückgeben und gibt 1 zurück. Es liest die Datei, ändert den Code, führt ihn über execute_code aus, um zu prüfen — und die Ausgabe ist immer noch 1. Es liest die Datei erneut, bestätigt, dass die Änderung wirklich drin ist, und entschuldigt sich dann. Oder schlimmer: Es „fixt“ den nun korrekten Code ein zweites Mal oder gibt auf und beschuldigt die Umgebung.
Was tatsächlich passiert ist, ist einfach. Der Code war richtig; die 1 kam aus einem veralteten Modul im Speicher. Der Session-Kernel hält sys.modules über Calls hinweg am Leben, die Datei änderte sich auf der Platte, und nichts hat es ihm gesagt. Das Ergebnis sah völlig normal aus — genau deshalb blieb der Fehlgriff unsichtbar.
PR #153665, gemergt am 12. November, macht ihn sichtbar: execute_code nennt jetzt die Module, die bearbeitet wurden, nachdem der Kernel sie geladen hat.
Warum das passiert: Python importiert genau einmal
In einem normalen Skript gibt es kein Problem. Jedes python script.py ist ein frischer Prozess, also beginnen die Imports von vorn.
execute_code ist das nicht. Damit eine in einer Zelle definierte Variable die nächste überlebt, hält es einen Kernel-Prozess am Leben und führt Zellen darin aus. Der Preis: Auch die Modulobjekte in sys.modules bleiben am Leben — wenn dein import calc_rate vor der Bearbeitung passiert ist, ist dieses Objekt für immer die alte Version.
Das erzeugt eine besonders ärgerliche Art von Mismatch: Die Datei ist korrekt, read_file zeigt den korrekten Inhalt, die Schlussfolgerung des Modells ist korrekt, und nur das Ausführungsergebnis ist veraltet. Nichts in der Ausgabe unterscheidet das, also muss das Modell raten.
Was sich geändert hat: ein mtime-Eintrag pro Zelle
Der Kernel tut jetzt zwei Dinge:
- Nach jeder Zelle notiert er die mtime der Quelldatei jedes Projektmoduls, das die Session importiert hat.
- Vor der nächsten Zelle vergleicht er: Jede Datei, deren mtime sich bewegt hat, landet mit ihrem Namen im
warningdes Ergebnisses.
Standardbibliothek und Module aus site-packages / dist-packages werden übersprungen — du musst nicht wissen, was ein pip-Paket getan hat. Der Scan liest das jeweilige dict des Moduls selbst und überspringt alles, was er nicht lesen kann, damit ein seltsamer Eintrag in sys.modules (ein Lazy-Modul, ein Nicht-Modul-Objekt) niemals eine Zelle scheitern lässt. Die Namen kommen aus dem Zellprozess, also behält der Host nur einfache punktierte Identifier und redigiert sie so, wie er stdout redigiert.
Das Ergebnis sieht so aus (wörtlich; lokale Kernel legen es in warning ab, entfernte in kernel.warning):
Edited on disk after this kernel imported it: calc_rate. If this cell used it
without reloading, it ran the OLD code. Run importlib.reload(<module>) (and
re-import any names taken from it), or call again with reset=true to start
from fresh imports.
Gleicher Prompt auf beiden Bäumen, mit nvidia/nemotron-3.5-super-vl auf Nous Portal:
| Vorher | Nachher | |
|---|---|---|
| Ausgabe der dritten Zelle | rate 1 | rate 1 |
| Ergebnis der dritten Zelle | kein Warning | warning mit calc_rate und beiden Auswegen |
| Bericht des Modells selbst | „printed rate 1 and there was no warning text“ | „printed rate 1 and warned: edited on disk after this kernel imported it“ |
| Kernel-Zustand | erhalten | erhalten |
Die letzte Zeile ist die wichtige: Nichts wird verworfen. Variablen, Imports und offene Handles überleben alle. Das Ergebnis bekommt einfach ein Feld dazu. Jede Bearbeitung wird einmal genannt, und ein Modul, das nach der Bearbeitung neu geladen oder neu importiert wurde, wird nicht erneut genannt.
Zwei Auswege, unterschiedliche Kosten
Option eins: importlib.reload(). Variablen behalten, Modul neu laden:
import importlib
import calc_rate

importlib.reload(calc_rate)
calc_rate.rate()   # now runs the new code from disk
Ein Detail, das das Warning ebenfalls erwähnt: from mod import f bindet den Namen an das alte Objekt, und ein Reload ändert das nicht. Also entweder neu importieren oder immer über das Modul aufrufen (mod.f()).
Option zwei: reset=true. Einen frischen Kernel mit sauberen Imports starten. Der Preis: Jede Variable der Session ist weg — wenn du gerade zehn Minuten ins Laden eines großen DataFrame gesteckt hast, lass das.
Warum nicht einfach den Kernel neu starten, sobald sich eine Datei ändert
Ein früherer PR (#127819) tat genau das: Jede .py-Datei, die im Arbeitsordner bearbeitet wurde, startete den ganzen Kernel neu. Grob, aber einfach — außer dass er jede Variable und jedes geladene Dataset wegwarf, selbst wenn die bearbeitete Datei nie importiert worden war.
Der ausgelieferte Ansatz ist enger: Der Kernel bleibt am Leben, nur tatsächlich importierte Module werden gemeldet, und die Meldung nennt den Preis. Die Kompromisse zeigen sich in dem, was bewusst nicht abgedeckt ist — und diese Grenzen zu kennen ist nützlicher, als das Feature zu kennen:
- Kompilierte Extension-Module (
.so,.pyd) und Module ohne.py-__file__werden nicht beobachtet. - Ein Modul, das in derselben Zelle importiert und dann bearbeitet wird, wird nicht gemeldet — der Kernel kann diese Reihenfolge nicht vom üblichen Schreiben-dann-Importieren unterscheiden.
- Eine Bearbeitung, gefolgt von einem Reload, der scheitert (etwa ein
SyntaxError), lässt den alten Code geladen, und keine spätere Zelle warnt erneut; der Traceback steht im Ergebnis dieser Zelle. - Der Scan kann nicht sagen, ob die Zelle das Modul tatsächlich benutzt hat, deshalb ist die Formulierung konditional („if this cell used it without reloading“) statt einer Behauptung.
Was das im Alltag ändert
Wenn dein Loop „Agent schreibt Code → führt ihn aus → sieht einen Fehlschlag → editiert → führt erneut aus“ ist, nimmt dieses Warning mehrere Runden Raten weg. Wenn du es siehst, ist der richtige Schritt ein Reload oder ein Reset — nicht ein weiterer Blick auf die Bearbeitung.
Zwei benachbarte Fälle, die ebenfalls wie Bugs aussehen, aber keine sind: der Loop-Detector, der bei legitimer Arbeit auslöst und Replays nach Edit-and-Resend. Die vollständige Argumentliste für das Tool, reset inklusive, steht in der Befehlsreferenz.
Release-Status
PR #153665 ist am 12. November 2026 in main gemergt, und sein Titel sagt direkt, dass er #127819 ersetzt. v0.23.1 erschien am 10. November und enthält ihn nicht — warte auf das nächste Release oder installiere von main. Der neue Absatz „Edited modules“ in code-execution.md kam im selben Commit.
Update (17.11.2026): Diese Änderungen sind mit v0.23.2 (16. November) erschienen – ein
hermes updatebringt sie. Die Formulierung „nicht in v0.23.1“ oben ist eine Momentaufnahme vom Veröffentlichungstag.