Vous avez corrigé le fichier, le kernel exécutait toujours l'ancien code : execute_code le dit maintenant
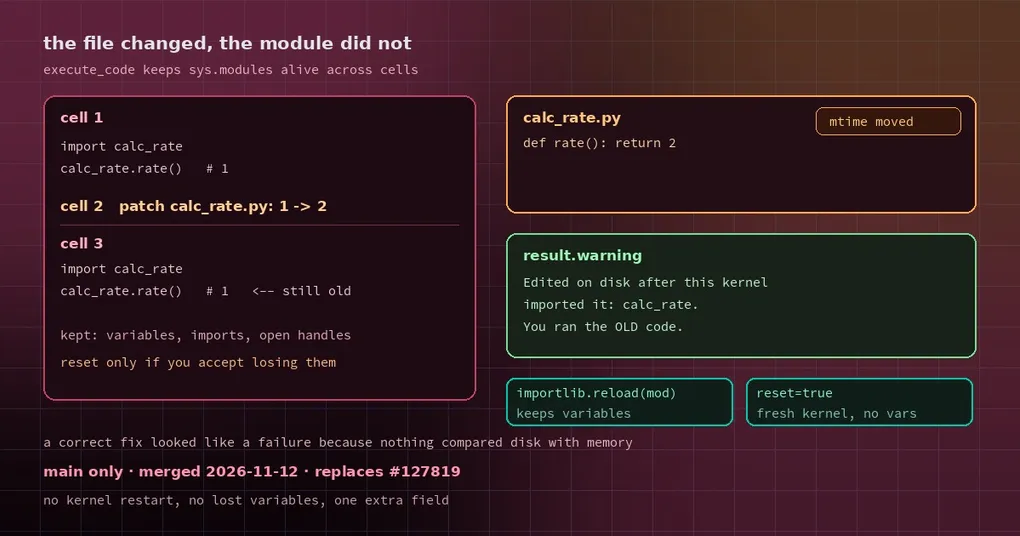
Vous demandez à Hermes de corriger un petit bug : calc_rate() devrait renvoyer 2 et renvoie 1. Il lit le fichier, modifie le code, l’exécute via execute_code pour vérifier — et la sortie affiche toujours 1. Il relit le fichier, confirme que la modification est bien là, puis s’excuse. Ou pire : il « corrige » une seconde fois un code devenu correct, ou abandonne en accusant l’environnement.
Ce qui s’est réellement passé est simple. Le code était bon ; le 1 venait d’un module périmé en mémoire. Le kernel de session garde sys.modules en vie d’un appel à l’autre, le fichier a changé sur le disque, et rien ne l’a signalé. Le résultat semblait parfaitement normal, et c’est précisément pour cela que le raté était invisible.
La PR #153665, fusionnée le 12 novembre, le rend visible : execute_code nomme désormais les modules modifiés après que le kernel les a chargés.
Pourquoi cela arrive : Python n’importe qu’une fois
Dans un script classique, aucun problème. Chaque python script.py est un processus neuf, donc les imports repartent de zéro.
execute_code n’est pas cela. Pour qu’une variable définie dans une cellule survive dans la suivante, il maintient un processus kernel en vie et exécute les cellules à l’intérieur. Le prix à payer : les objets module de sys.modules restent eux aussi en vie — si votre import calc_rate a eu lieu avant la modification, cet objet restera l’ancienne version pour toujours.
Cela produit un type de décalage particulièrement agaçant : le fichier est correct, read_file affiche le bon contenu, le raisonnement du modèle est correct, et seul le résultat d’exécution est périmé. Rien dans la sortie ne permet de le distinguer, donc le modèle doit deviner.
Ce qui change : un relevé des mtime par cellule
Le kernel fait maintenant deux choses :
- Après l’exécution de chaque cellule, il enregistre le mtime — la date de modification de la source — de chaque module du projet importé par la session.
- Avant l’exécution de la cellule suivante, il compare : tout fichier dont le mtime a bougé voit son nom ajouté au champ
warningdu résultat.
Les modules de la bibliothèque standard et de site-packages / dist-packages sont ignorés — vous n’avez pas besoin de savoir ce qu’a fait un paquet pip. Le scan lit le dict propre à chaque module et ignore tout ce qu’il ne peut pas lire, si bien qu’une entrée bizarre dans sys.modules (module paresseux, objet qui n’est pas un module) ne peut jamais faire échouer une cellule. Les noms viennent du processus de la cellule, donc l’hôte ne conserve que de simples identifiants pointés et les expurge comme il expurge stdout.
Le résultat ressemble à ceci (verbatim ; les kernels locaux le placent dans warning, les kernels distants dans kernel.warning) :
Edited on disk after this kernel imported it: calc_rate. If this cell used it
without reloading, it ran the OLD code. Run importlib.reload(<module>) (and
re-import any names taken from it), or call again with reset=true to start
from fresh imports.
Même prompt sur les deux branches, avec nvidia/nemotron-3.5-super-vl sur Nous Portal :
| Avant | Après | |
|---|---|---|
| Sortie de la troisième cellule | rate 1 | rate 1 |
| Résultat de la troisième cellule | aucun warning | warning nommant calc_rate et les deux correctifs |
| Le compte rendu du modèle | “printed rate 1 and there was no warning text” | “printed rate 1 and warned: edited on disk after this kernel imported it” |
| État du kernel | conservé | conservé |
Cette dernière ligne est la plus importante : rien n’est jeté. Les variables, les imports et les handles ouverts survivent tous. Le résultat gagne simplement un champ. Chaque modification est nommée une fois, et un module rechargé ou réimporté après la modification n’est plus nommé.
Deux correctifs, deux coûts
Option un : importlib.reload(). Gardez vos variables, rechargez le module :
import importlib
import calc_rate

importlib.reload(calc_rate)
calc_rate.rate()   # now runs the new code from disk
Un détail que le warning mentionne aussi : from mod import f lie le nom au vieil objet, et un reload ne change pas cela. Soit vous réimportez, soit vous appelez toujours via le module (mod.f()).
Option deux : reset=true. Démarrez un kernel neuf avec des imports propres. Le coût : toutes les variables de la session sont perdues — si vous venez de passer dix minutes à charger un gros DataFrame, ne le faites pas.
Pourquoi ne pas simplement redémarrer le kernel à chaque changement de fichier
Une PR antérieure (#127819) faisait exactement cela : tout fichier .py modifié sous le dossier de travail redémarrait le kernel entier. Brutal mais simple — sauf que cela jetait toutes les variables et tous les jeux de données chargés, même quand le fichier modifié n’avait jamais été importé.
L’approche livrée est plus étroite : le kernel reste en vie, seuls les modules réellement importés par le kernel sont signalés, et le message énonce le coût. Les compromis apparaissent dans ce qu’elle ne couvre délibérément pas, et connaître ces limites est plus utile que connaître la fonctionnalité :
- Les modules d’extension compilés (
.so,.pyd) et les modules sans__file__en.pyne sont pas surveillés. - Un module importé puis modifié dans la même cellule n’est pas signalé — le kernel ne peut pas distinguer cet ordre de l’écriture suivie d’un import habituelle.
- Une modification suivie d’un reload qui échoue (un
SyntaxError, par exemple) laisse l’ancien code chargé, et aucune cellule ultérieure ne réavertit ; la traceback vit dans le résultat de cette cellule. - Le scan ne peut pas savoir si la cellule a réellement utilisé le module, donc la formulation reste conditionnelle — « si cette cellule l’a utilisé sans le recharger » — plutôt qu’une affirmation.
Ce que cela change au quotidien
Si votre boucle est « l’agent écrit du code → l’exécute → voit un échec → modifie → réexécute », ce warning supprime plusieurs tours de devinettes. Quand vous le voyez, la bonne action est un reload ou un reset, pas un nouveau coup d’œil à la modification.
Deux cas voisins qui ressemblent aussi à des bugs sans en être : le détecteur de boucle qui se déclenche sur du travail légitime et les replays après un edit-and-resend. La liste complète des arguments de l’outil, reset compris, se trouve dans la référence des commandes.
Statut de la release
La PR #153665 a été fusionnée dans main le 12 novembre 2026, et son titre dit explicitement qu’elle remplace la #127819. v0.23.1 est sortie le 10 novembre et ne l’inclut pas — attendez la prochaine release ou installez depuis main. Le nouveau paragraphe « Edited modules » de code-execution.md est arrivé dans le même commit.
Mise à jour (17/11/2026) : ces changements sont sortis dans la v0.23.2 (16 novembre) : un
hermes updateles récupère. Le « pas dans la v0.23.1 » ci-dessus est un instantané du jour de publication.