Arreglaste el archivo y el kernel siguió ejecutando el código viejo: ahora execute_code lo dice
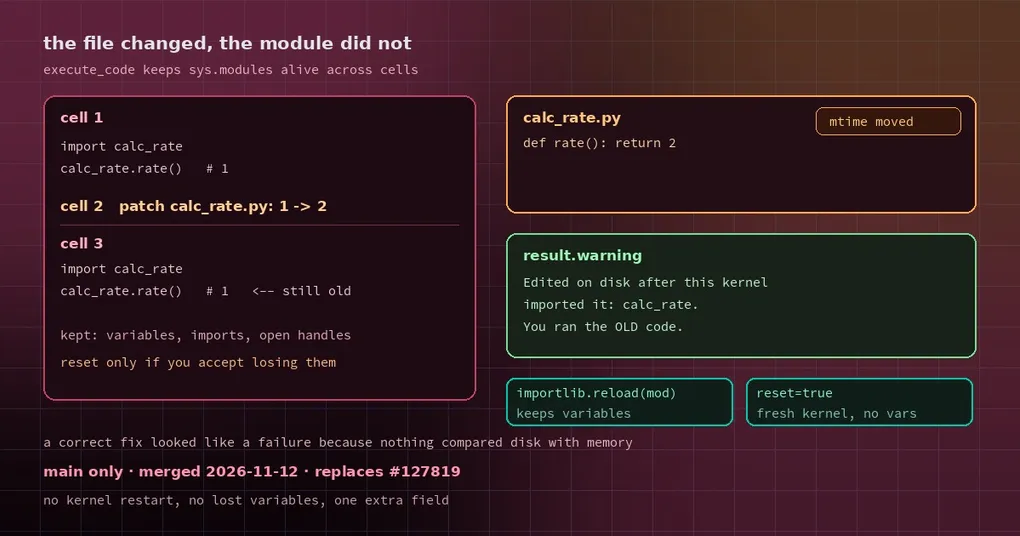
Pides a Hermes que arregle un bug pequeño: calc_rate() debería devolver 2 y devuelve 1. Lee el archivo, edita el código, lo ejecuta con execute_code para comprobarlo y la salida sigue siendo 1. Vuelve a leer el archivo, confirma que el cambio está realmente ahí y se disculpa. O peor: “arregla” el código ya correcto una segunda vez, o se rinde y culpa al entorno.
Lo que pasó en realidad es simple. El código era correcto; el 1 venía de un módulo obsoleto en memoria. El kernel de sesión mantiene sys.modules vivo entre llamadas, el archivo cambió en disco y nada se lo dijo. El resultado parecía completamente normal, y por eso mismo el fallo era invisible.
El PR #153665, fusionado el 12 de noviembre, lo hace visible: execute_code ahora nombra los módulos que se editaron después de que el kernel los cargara.
Por qué pasa esto: Python importa una sola vez
En un script normal no hay problema. Cada python script.py es un proceso nuevo, así que los imports empiezan de cero.
execute_code no es eso. Para que una variable definida en una celda sobreviva a la siguiente, mantiene un proceso kernel vivo y ejecuta las celdas dentro de él. El coste es que los objetos de módulo en sys.modules también siguen vivos: si tu import calc_rate ocurrió antes de la edición, ese objeto es la versión vieja para siempre.
Eso produce un tipo de desajuste especialmente irritante: el archivo es correcto, read_file muestra el contenido correcto, el razonamiento del modelo es correcto y solo el resultado de la ejecución está obsoleto. Nada en la salida lo distingue, así que el modelo tiene que adivinar.
Qué cambió: un registro de mtime por celda
El kernel ahora hace dos cosas:
- Después de ejecutar cada celda, registra el mtime (modification time) del código fuente de cada módulo del proyecto que importó la sesión.
- Antes de ejecutar la siguiente celda, compara: cualquier archivo cuyo mtime se haya movido pasa a aparecer en el campo
warningdel resultado.
Los módulos de la biblioteca estándar y de site-packages / dist-packages se omiten: no necesitas saber qué hizo un paquete de pip. El escaneo lee el dict propio de cada módulo y salta todo lo que no puede leer, así que una entrada rara en sys.modules (un módulo perezoso, un objeto que no es un módulo) nunca puede hacer fallar una celda. Los nombres vienen del proceso de la celda, así que el host solo conserva identificadores con puntos y los redacta igual que redacta stdout.
El resultado se ve así (textual; los kernels locales lo ponen en warning, los remotos en kernel.warning):
Edited on disk after this kernel imported it: calc_rate. If this cell used it
without reloading, it ran the OLD code. Run importlib.reload(<module>) (and
re-import any names taken from it), or call again with reset=true to start
from fresh imports.
Mismo prompt en ambos árboles, con nvidia/nemotron-3.5-super-vl en Nous Portal:
| Antes | Después | |
|---|---|---|
| Salida de la tercera celda | rate 1 | rate 1 |
| Resultado de la tercera celda | sin warning | warning que nombra calc_rate y los dos arreglos |
| Relato del propio modelo | “imprimió rate 1 y no había texto de warning” | “imprimió rate 1 y avisó: editado en disco después de que este kernel lo importara” |
| Estado del kernel | conservado | conservado |
Esa última fila es la importante: no se descarta nada. Las variables, los imports y los handles abiertos sobreviven. El resultado simplemente gana un campo. Cada edición se nombra una vez, y un módulo que se recargó o se reimportó después de la edición no vuelve a nombrarse.
Dos arreglos, costes distintos
Opción uno: importlib.reload(). Conserva tus variables, recarga el módulo:
import importlib
import calc_rate

importlib.reload(calc_rate)
calc_rate.rate()   # now runs the new code from disk
Un detalle que el aviso también menciona: from mod import f vincula el nombre al objeto viejo, y una recarga no cambia eso. O reimportas, o llamas siempre a través del módulo (mod.f()).
Opción dos: reset=true. Arranca un kernel nuevo con imports limpios. El coste es que todas las variables de la sesión desaparecen: si acabas de pasar diez minutos cargando un DataFrame grande, no lo hagas.
Por qué no reiniciar el kernel cada vez que cambia un archivo
Un PR anterior (#127819) hacía exactamente eso: cualquier archivo .py editado dentro de la carpeta de trabajo reiniciaba todo el kernel. Contundente pero simple, salvo que tiraba todas las variables y datasets cargados, incluso cuando el archivo editado nunca se había importado.
El enfoque que se ha implementado es más estrecho: el kernel sigue vivo, solo se reportan los módulos que el kernel importó de verdad y el mensaje declara el coste. Los compromisos se ven en lo que deliberadamente no cubre, y conocer esos límites resulta más útil que conocer la funcionalidad:
- Los módulos de extensión compilados (
.so,.pyd) y los módulos sin__file__de tipo.pyno se vigilan. - Un módulo importado y luego editado dentro de la misma celda no se reporta: el kernel no puede distinguir ese orden del habitual escribir y luego importar.
- Una edición seguida de una recarga que falla (un
SyntaxError, por ejemplo) deja el código viejo cargado y ninguna celda posterior vuelve a avisar; el traceback queda en el resultado de esa celda. - El escaneo no puede saber si la celda usó realmente el módulo, así que el texto es condicional (“si esta celda lo usó sin recargar”) en lugar de una afirmación.
Qué cambia en el día a día
Si tu bucle es “el agente escribe código → lo ejecuta → ve un fallo → edita → vuelve a ejecutar”, este aviso te ahorra varias rondas de adivinación. Cuando lo veas, lo correcto es recargar o resetear, no volver a mirar la edición.
Dos casos vecinos que también parecen bugs y no lo son: el detector de bucles disparándose con trabajo legítimo y los replays tras editar y reenviar. La lista completa de argumentos de la herramienta, reset incluido, está en la referencia de comandos.
Estado del release
El PR #153665 se fusionó en main el 12 de noviembre de 2026, y su título dice directamente que reemplaza a #127819. La v0.23.1 salió el 10 de noviembre y no lo incluye: espera a la próxima release o instala desde main. El nuevo párrafo “Edited modules” de code-execution.md llegó en el mismo commit.
Actualización (17/11/2026): estos cambios salieron en la v0.23.2 (16 de noviembre):
hermes updatelos trae. Lo de «no está en la v0.23.1» es una foto del momento de la publicación.