190 llamadas desperdiciadas sin que ningún guard dijera nada
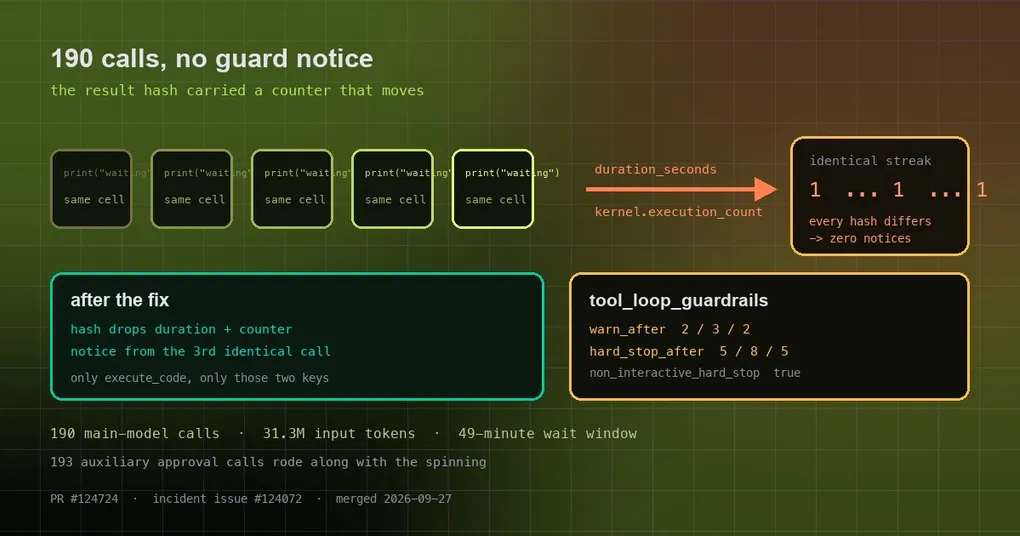
Le pides al agente que lance 10 subagentes en segundo plano y te haga un resumen cuando terminen. En lugar de cerrar el turno y esperar la notificación, mantiene el turno vivo con una llamada sin efecto tras otra: llamadas a execute_code que imprimen algo y no cambian nada. 84 minutos después abortas a mano. Al leer el log a posteriori, no hay ni un solo aviso de «parece que te estás repitiendo». El guard estuvo callado todo el camino.
Eso no es un modelo tonto. Es un detector de bucles que no podía ver este tipo de giro en vacío. El issue #124072 cuantificó todo el incidente, y el PR #124724, fusionado el 2026-09-27, corrigió la parte clave.
El registro del incidente: 84 minutos, 190 llamadas
Las cifras del issue salen de los propios registros de la sesión (la ventana del bucle, 22:31:05–23:20:12):
| Métrica | Valor |
|---|---|
| Llamadas a la API del modelo principal | 190 |
| Tokens de entrada (incl. en caché) | 31,365,131 (de los cuales 31,272,448 eran lecturas de caché) |
| Tokens de salida | 25,896 |
| Suma de la latencia por llamada | 1,869.8 s — el 63% de esa ventana de 49 minutos |
| Llamadas auxiliares al modelo de aprobación | 193 (aproximadamente una por iteración desperdiciada) |
La sesión completa (22:09–23:33) es todavía más clara en la fila principal: 267 llamadas, 40,377,600 tokens de lectura de caché, 73,059 tokens de salida. Dicho de otro modo, el 71% de las llamadas del modelo principal se gastaron dentro de la ventana de espera, y el guard no se disparó ni una sola vez.
Por qué la detección de bucles se quedó callada
El guard de llamadas repetidas de Hermes se basa en una terna: (tool name, arguments, result hash). Las llamadas idénticas tienen que alinearse formando una racha antes de que pueda producirse el aviso de «enésima llamada idéntica» (o la parada dura).
El problema era el propio hash del resultado:
- Los resultados de
execute_codellevan dos campos de contabilidad por llamada que cambian todas y cada una de las veces:duration_seconds(reloj de pared) ykernel.execution_count(un contador monotónico de celdas del kernel). - Por eso las repeticiones idénticas byte a byte generaban hashes distintos cada vez, y la racha de llamadas idénticas se quedaba en 1.
- La segunda mitad del problema es la más afilada:
after_call()retorna antes de tiempo en las herramientas mutadoras, yexecute_codelo es, así que para esta herramienta solo esa vía de guard puede llegar a dispararse. Juntas: cero avisos. El comentario del código recoge «un modelo re-ejecutó una llamada vacía a execute_code 147 veces sin que se marcara»; el cuerpo del PR recoge cero avisos a lo largo de 186 llamadas en el incidente.
La solución: eliminar exactamente esos dos campos, solo para execute_code
El parche es deliberadamente estrecho:
def _without_execute_code_metadata(parsed):
    if not isinstance(parsed, dict):
        return parsed
    cleaned = {k: v for k, v in parsed.items() if k != "duration_seconds"}
    kernel = cleaned.get("kernel")
    if isinstance(kernel, dict):
        cleaned["kernel"] = {k: v for k, v in kernel.items() if k != "execution_count"}
    return cleaned
El comentario explica el alcance: para cualquier otra herramienta esos mismos nombres de clave pueden ser salida real, así que tocarlos corrompería las comparaciones de «idéntico»; los resultados que no son JSON se hashean exactamente igual que antes. Con el cambio, la detección de repeticiones vuelve a funcionar: aparece un aviso a partir de la 3ª llamada idéntica (los umbrales exactos son configurables, más abajo).
Conviene ser precisos: el issue #124072 lista cuatro defectos. Este PR corrige uno de ellos: campos volátiles que ciegan a los detectores de repetición. Los otros tres, incluida la mecánica de esperar a subagentes en segundo plano, quedan fuera del alcance de este artículo.
Las palancas que ya tienes
Estos comportamientos son configurables, y los valores por defecto difieren entre ejecuciones interactivas y desatendidas:
# ~/.hermes/config.yaml
tool_loop_guardrails:
  warnings_enabled: true
  hard_stop_enabled: false                  # las sesiones interactivas avisan por defecto
  non_interactive_hard_stop_enabled: true   # gateway / cron aplican parada dura por defecto
  warn_after:
    exact_failure: 2
    same_tool_failure: 3
    idempotent_no_progress: 2
  hard_stop_after:
    exact_failure: 5
    same_tool_failure: 8
    idempotent_no_progress: 5
  loop_caps:
    max_web_searches: 50    # llamadas a web_search por turno
    max_subagents: 50       # subagentes lanzados por turno
El razonamiento se sigue con facilidad: nadie puede pulsar /stop en una ejecución desatendida, así que esas plataformas aplican la parada dura por defecto, mientras que las sesiones interactivas reciben primero un aviso para que el modelo pueda rescatarse a sí mismo. Los loop_caps son techos por turno que se reinician en cada turno y se aplican con independencia de los umbrales anteriores; docenas de búsquedas o de subagentes en un solo turno ya era patológico.
Para inspeccionar los valores efectivos, hermes config get tool_loop_guardrails funciona; los subcomandos son show|edit|get|set|unset|path|env-path|check|migrate (no hay reload).
Qué significa esto si ejecutas tareas largas
- No esperes girando en vacío. Deja que el turno termine y vuelve con la notificación en segundo plano. Es muchísimo más barato que mantener un turno vivo con sondeos vacíos: este quemó 31M tokens de lectura de caché.
- El bucle cuesta más que un modelo. Esas 193 llamadas auxiliares al modelo de aprobación se corresponden casi una a una con las iteraciones desperdiciadas; pagas dos veces.
- Las paradas duras no son una red de seguridad para todo. Incluso funcionando bien, este guard solo detecta llamadas idénticas. Un modelo que reformule cada llamada vacía se escapa de él, y los techos por turno son lo único que queda. Sobre la maquinaria adyacente, consulta el control de subagentes en vivo y qué pasa cuando se levanta el límite de turnos.
- El significado completo de estas claves está en nuestra referencia de hermes config.
Estado del release
El PR #124724 se fusionó el 2026-09-27, después de la etiqueta de release v0.21.5 (v2026.9.24), así que solo está en main: hermes update lo recogerá.
Conclusión
Una marca de tiempo que cambia en cada llamada normalmente es solo ruido. Solo se vuelve caro cuando se usa para decidir si esta llamada fue igual que la anterior, y en ese momento el guard se queda ciego en toda la herramienta. La corrección no añade otro guard; hace que el hash mire únicamente la parte del resultado que representa de verdad lo que ocurrió. Unas pocas docenas de líneas, a cambio de detener mucho antes la mayoría de esas 190 llamadas.