模型原地转了 190 圈,没有一个守卫发出声音
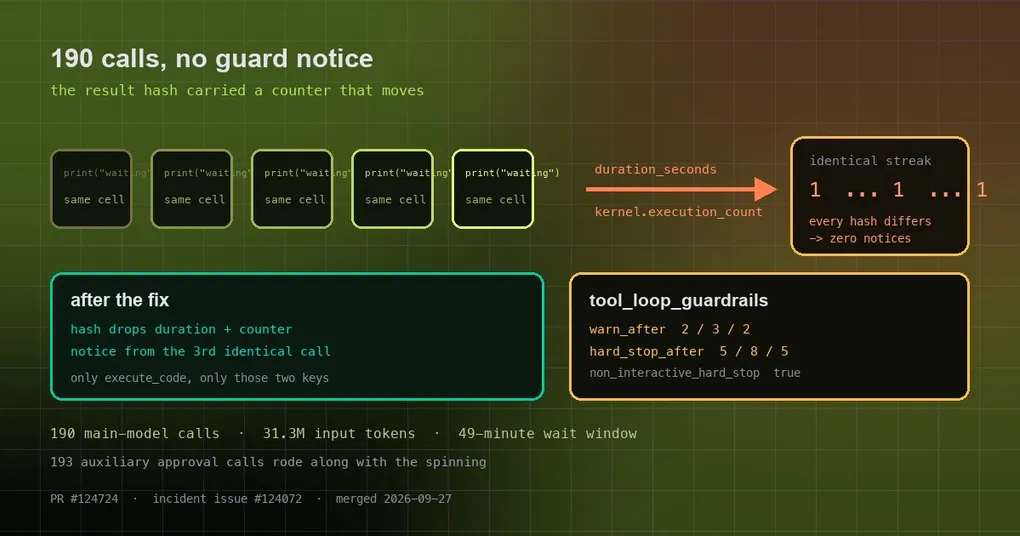
你让 agent 起 10 个后台子代理干活,干完再汇总。它没有结束回合去等通知,而是用一个又一个空操作把回合撑着——反复执行 print("waiting") 这类什么也不改的 execute_code。84 分钟后你手动按了停。回头看日志,没有任何一条“你好像在重复自己”的提示:守护机制全程安静。
这不是模型太笨,而是循环检测当时正好看不见 execute_code 这一类的空转。issue #124072 把整场事故量化得清清楚楚,2026-09-27 合并的 PR #124724 修掉了其中的关键一环。
事故账本:84 分钟,190 次调用
issue 里的数字来自会话自己的记录(23:31:05–23:20:12 的循环窗口):
| 指标 | 数值 |
|---|---|
| 主模型 API 调用 | 190 次 |
| 输入 token(含缓存) | 31,365,131(其中 31,272,448 是缓存读) |
| 输出 token | 25,896 |
| 单次调用延迟之和 | 1,869.8 秒,占那 49 分钟窗口的 63% |
| 辅助审批模型调用 | 193 次(约等于每次白跑一轮配一次) |
整场会话(22:09–23:33)的主模型行更直观:267 次调用、缓存读 40,377,600、输出 73,059。也就是说,71% 的主模型调用花在了等待窗口里,而其中没有一次被守卫拦下。
为什么循环检测完全没反应
Hermes 里负责“同一件事做太多次”的守卫,靠一个三元组做签名:(工具名, 参数, 结果哈希)。相同的调用连成串,才会有“第 N 次相同调用”的提示与硬停。
问题就在“结果哈希”上:
execute_code返回的结果里带着两个每次调用都会变的记账字段——duration_seconds(墙钟耗时)和kernel.execution_count(内核单元计数器,单调递增)。- 于是逐字节相同的空探针,哈希各不相同,那个“相同调用连击”永远停在 1 次。
- 更要命的是第二条:
after_call()对会改状态的(mutating)工具直接返回。而execute_code正属于这一类——也就是说对于它,只有这一条守卫路径能触发。两者叠加,结果是零告警:源码注释里记着“一个模型把同一个空 execute_code 调了 147 次都没被标记”,PR 说明里记的是事发时 186 次调用零提示。
修复:只丢掉 execute_code 自己的两个字段
补丁刻意做得很窄——只对 execute_code 生效,且只丢这两个已知位置:
def _without_execute_code_metadata(parsed):
    if not isinstance(parsed, dict):
        return parsed
    cleaned = {k: v for k, v in parsed.items() if k != "duration_seconds"}
    kernel = cleaned.get("kernel")
    if isinstance(kernel, dict):
        cleaned["kernel"] = {k: v for k, v in kernel.items() if k != "execution_count"}
    return cleaned
理由写在注释里:对别的工具来说,同名键可能就是真输出,动了就会让“相同”判断出错;非 JSON 结果照旧哈希。效果是重放检测恢复工作——从第 3 次相同调用开始就会有提示(警告的门槛取决于下面的配置)。
需要说明的是,issue #124072 一共列了四个缺陷,这次修的是其中一个:易变字段让重放检测失明。其余三处(包括等待后台子代理这件事本身的机制)不在这个 PR 的范围里。
你手上的旋钮
这些行为都由配置控制,默认值对交互式和无人值守场景是分开的:
# ~/.hermes/config.yaml
tool_loop_guardrails:
  warnings_enabled: true
  hard_stop_enabled: false                  # 交互式会话默认只警告
  non_interactive_hard_stop_enabled: true   # gateway / cron 这类无人值守场景默认硬停
  warn_after:
    exact_failure: 2
    same_tool_failure: 3
    idempotent_no_progress: 2
  hard_stop_after:
    exact_failure: 5
    same_tool_failure: 8
    idempotent_no_progress: 5
  loop_caps:
    max_web_searches: 50    # 单回合 web_search 上限
    max_subagents: 50       # 单回合派生子代理上限
设计思路很好理解:无人值守时没人能替你按 /stop,所以默认硬停;交互式会话里,警告先给模型一个自救的机会。loop_caps 是每个回合重置的硬天花板,与上面的阈值无关——一个回合里几十次搜索或几十个子代理,本身就已经不正常了。
如果你想手动看一眼配置,用 hermes config get tool_loop_guardrails(hermes config 的子命令是 show|edit|get|set|unset|path|env-path|check|migrate,没有 reload)。
对跑长任务的人,这件事意味什么
- 等后台工作不要靠空转。 让回合正常结束,用后台任务与通知机制回来接着做,比在一个回合里反复空探针便宜得多——这次光缓存读就是 3100 万 token。
- 循环的代价不止主模型。 那 193 次辅助审批模型调用几乎与白跑的迭代一一对应,账单是两个模型一起付的。
- 硬停不是万能的。 这次守卫就算工作,也只会拦“相同调用”;如果模型每次换个略微不同的说法空转,能拦住它的就只剩回合级的上限了——相关机制可以对照子代理的实时控制和把回合上限放开之后会发生什么两篇一起看。
- 配置项的完整含义见本站的 hermes config 参考。
发布状态
PR #124724 合并于 2026-09-27,晚于 v0.21.5 的发行标签(v2026.9.24),目前只在 main:hermes update 即可拿到。
小结
“结果里有个每次都变的时间戳”这种细节,通常只是让人困惑,不会造成损失;但当它被拿去当“这次调用和上次是否一样”的判据时,守卫就会整体失明。修复的思路不是加更多守卫,而是让哈希只看真正代表结果的那部分内容。代价是几十行代码,收益是那 190 次调用中的绝大部分本来可以早一点停下来。