190 verschwendete Aufrufe und kein Guard sagte ein Wort
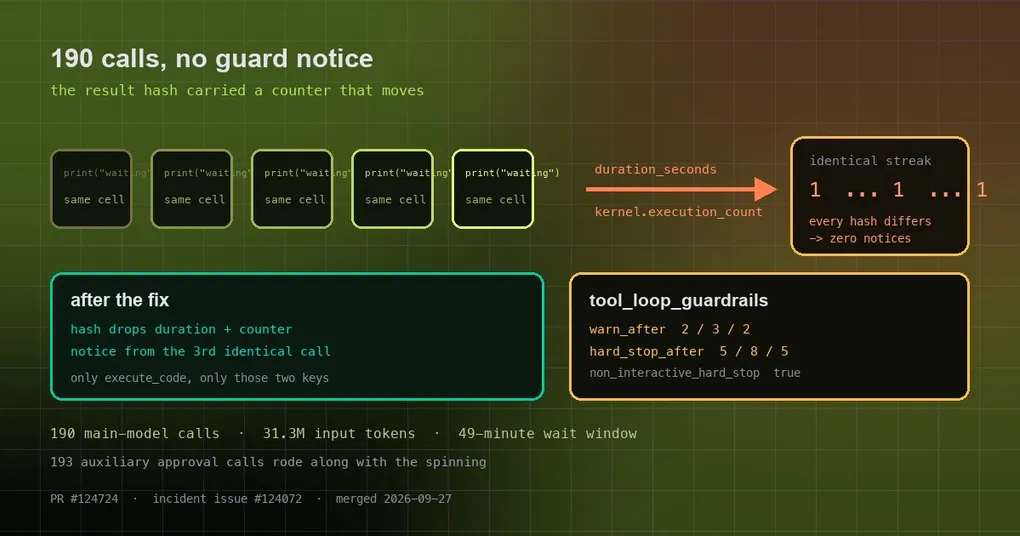
Du bittest den Agent, 10 Subagents im Hintergrund zu starten und zusammenzufassen, wenn sie fertig sind. Statt den Turn zu beenden und auf die Benachrichtigung zu warten, hält er den Turn mit einem No-op nach dem anderen am Leben — execute_code-Aufrufe, die etwas ausgeben und nichts ändern. 84 Minuten später brichst du von Hand ab. Als du das Log danach durchliest: keine einzige Meldung „du scheinst dich zu wiederholen“. Der Guard war die ganze Zeit still.
Das ist kein dummes Modell. Es ist ein Loop-Detektor, der genau diese Art von Drehen nicht sehen konnte. Issue #124072 hat den gesamten Vorfall quantifiziert, und PR #124724, gemergt am 2026-09-27, hat den entscheidenden Teil davon behoben.
Die Bilanz des Vorfalls: 84 Minuten, 190 Aufrufe
Die Zahlen im Issue stammen aus den eigenen Aufzeichnungen der Sitzung (das Loop-Fenster, 22:31:05–23:20:12):
| Metrik | Wert |
|---|---|
| API-Aufrufe des Hauptmodells | 190 |
| Input-Tokens (inkl. gecachter) | 31.365.131 (davon 31.272.448 Cache-Reads) |
| Output-Tokens | 25.896 |
| Summe der Latenz pro Aufruf | 1.869,8 s — 63 % dieses 49-Minuten-Fensters |
| Zusätzliche Aufrufe des Approval-Modells | 193 (etwa einer pro verschwendeter Iteration) |
Die ganze Sitzung (22:09–23:33) ist bei der Hauptzeile noch deutlicher: 267 Aufrufe, 40.377.600 Cache-Read-Tokens, 73.059 Output-Tokens. Anders gesagt: 71 % der Aufrufe des Hauptmodells fielen in das Wartefenster, und der Guard hat kein einziges Mal ausgelöst.
Warum die Loop-Erkennung still blieb
Der Guard von Hermes gegen wiederholte Aufrufe arbeitet mit einem Tripel: (Tool-Name, Argumente, Result-Hash). Identische Aufrufe müssen sich zu einer Serie aufreihen, bevor die Warnung „N-ter identischer Aufruf“ (oder der Hard Stop) kommen kann.
Das Problem war der Result-Hash selbst:
execute_code-Ergebnisse tragen zwei Bookkeeping-Felder pro Aufruf, die sich jedes Mal ändern:duration_seconds(Wall-Clock) undkernel.execution_count(ein monotoner Zähler der Kernel-Zellen).- Byte-identische Wiederholungen wurden daher jedes Mal anders gehasht, und die Serie identischer Aufrufe blieb bei 1 stehen.
- Die zweite Hälfte des Problems ist die schärfere:
after_call()kehrt bei mutierenden Tools früh zurück, undexecute_codeist eines davon — für dieses Tool kann also nur dieser eine Guard-Pfad überhaupt auslösen. Zusammen ergibt das: null Meldungen. Der Code-Kommentar hält fest, „ein Modell hat einen leeren execute_code-Aufruf 147 Mal ungeflaggt erneut ausgeführt“; der PR-Text verzeichnet null Meldungen über 186 Aufrufe im Vorfall.
Der Fix: genau diese zwei Felder entfernen, nur für execute_code
Der Patch ist bewusst eng gefasst:
def _without_execute_code_metadata(parsed):
    if not isinstance(parsed, dict):
        return parsed
    cleaned = {k: v for k, v in parsed.items() if k != "duration_seconds"}
    kernel = cleaned.get("kernel")
    if isinstance(kernel, dict):
        cleaned["kernel"] = {k: v for k, v in kernel.items() if k != "execution_count"}
    return cleaned
Der Kommentar erklärt den Umfang: Bei jedem anderen Tool können dieselben Schlüsselnamen echte Ausgabe sein, ein Eingriff würde also „identische“ Vergleiche verfälschen; Nicht-JSON-Ergebnisse werden genau wie zuvor gehasht. Mit der Änderung funktioniert die Replay-Erkennung wieder — ab dem 3. identischen Aufruf erscheint eine Meldung (die genauen Schwellen sind konfigurierbar, siehe unten).
Der Genauigkeit halber: Issue #124072 listet vier Defekte. Dieser PR behebt einen davon — volatile Felder, die die Replay-Detektoren blind machen. Die anderen drei, darunter die Mechanik des Wartens auf Hintergrund-Subagents, liegen hier außerhalb des Umfangs.
Die Stellschrauben, die du schon hast
Diese Verhaltensweisen sind konfigurierbar, und die Defaults unterscheiden sich zwischen interaktiven und unbeaufsichtigten Läufen:
# ~/.hermes/config.yaml
tool_loop_guardrails:
  warnings_enabled: true
  hard_stop_enabled: false                  # interaktive Sitzungen warnen standardmäßig
  non_interactive_hard_stop_enabled: true   # gateway / cron stoppen standardmäßig hart
  warn_after:
    exact_failure: 2
    same_tool_failure: 3
    idempotent_no_progress: 2
  hard_stop_after:
    exact_failure: 5
    same_tool_failure: 8
    idempotent_no_progress: 5
  loop_caps:
    max_web_searches: 50    # web_search-Aufrufe pro Turn
    max_subagents: 50       # pro Turn gestartete Subagents
Die Begründung ist leicht nachzuvollziehen: Auf einen unbeaufsichtigten Lauf kann niemand /stop drücken, also stoppen diese Plattformen standardmäßig hart, während interaktive Sitzungen zuerst eine Warnung bekommen, damit das Modell sich selbst retten kann. Die loop_caps sind Obergrenzen pro Turn, die bei jedem Turn zurückgesetzt werden und unabhängig von den obigen Schwellen gelten — Dutzende Suchen oder Subagents in einem einzigen Turn waren schon vorher pathologisch.
Um die effektiven Werte zu prüfen, funktioniert hermes config get tool_loop_guardrails; die Subkommandos sind show|edit|get|set|unset|path|env-path|check|migrate (ein reload gibt es nicht).
Was das bedeutet, wenn du lange Aufgaben laufen lässt
- Warte nicht, indem du drehst. Lass den Turn enden und komm über die Hintergrund-Benachrichtigung zurück. Das ist dramatisch günstiger, als einen Turn mit leeren Sonden am Leben zu halten — dieser hier hat 31 Mio. Cache-Read-Tokens verbrannt.
- Die Schleife kostet mehr als ein Modell. Diese 193 zusätzlichen Aufrufe des Approval-Modells entsprechen fast eins zu eins den verschwendeten Iterationen; du zahlst doppelt.
- Hard Stops sind kein Sicherheitsnetz für alles. Selbst wenn er korrekt arbeitet, fängt dieser Guard nur identische Aufrufe. Ein Modell, das jeden leeren Aufruf umformuliert, entkommt ihm, und nur die Obergrenzen pro Turn bleiben übrig. Zur benachbarten Mechanik siehe Live-Steuerung von Subagents und was passiert, wenn die Turn-Obergrenze fällt.
- Die vollständige Bedeutung dieser Keys steht in unserer hermes config-Referenz.
Release-Status
PR #124724 wurde am 2026-09-27 gemergt, nach dem Release-Tag v0.21.5 (v2026.9.24), ist also nur auf main: hermes update holt ihn.
Das Fazit
Ein Zeitstempel, der sich bei jedem Aufruf ändert, ist normalerweise nur Rauschen. Teuer wird er erst, wenn mit ihm entschieden wird, ob dieser Aufruf derselbe war wie der vorige — dann wird der Guard über das ganze Tool hinweg blind. Der Fix fügt keinen weiteren Guard hinzu; er sorgt dafür, dass der Hash nur den Teil des Ergebnisses ansieht, der tatsächlich repräsentiert, was passiert ist. Ein paar Dutzend Zeilen, im Austausch dafür, dass die meisten dieser 190 Aufrufe viel früher gestoppt werden.