190 chamadas desperdiçadas e nenhuma guarda disse nada
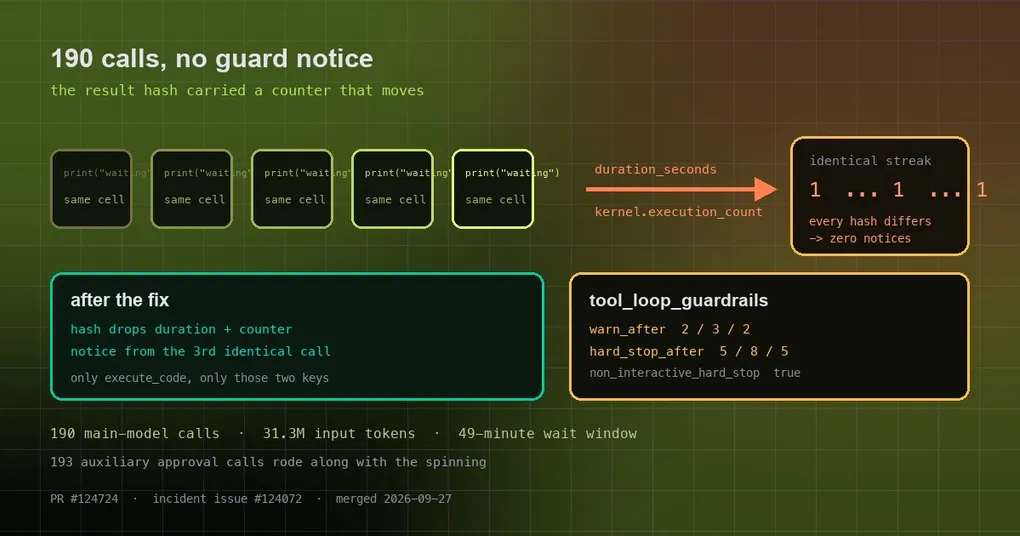
Você pede ao agente que crie 10 subagents em background e resuma quando terminarem. Em vez de encerrar o turno e esperar a notificação, ele mantém o turno vivo com um no-op atrás do outro — chamadas execute_code que imprimem algo e não mudam nada. 84 minutos depois você aborta na mão. Lendo o log em seguida, não existe um único aviso de “você parece estar se repetindo”. A guarda ficou muda o tempo todo.
Isso não é um modelo sendo burro. É um detector de loop que não conseguia ver esse tipo específico de giro. A issue #124072 quantificou o incidente inteiro, e o PR #124724, mesclado em 2026-09-27, corrigiu a parte principal dele.
O balanço do incidente: 84 minutos, 190 chamadas
Os números da issue vêm dos próprios registros da sessão (a janela do loop, 22:31:05–23:20:12):
| Métrica | Valor |
|---|---|
| Chamadas da API do modelo principal | 190 |
| Tokens de entrada (incl. cache) | 31.365.131 (dos quais 31.272.448 eram leituras de cache) |
| Tokens de saída | 25.896 |
| Soma da latência por chamada | 1.869,8 s — 63% daquela janela de 49 minutos |
| Chamadas auxiliares do modelo de aprovação | 193 (mais ou menos uma por iteração desperdiçada) |
A sessão inteira (22:09–23:33) é ainda mais clara na linha principal: 267 chamadas, 40.377.600 tokens de leitura de cache, 73.059 tokens de saída. Em outras palavras, 71% das chamadas do modelo principal foram gastas dentro da janela de espera, e a guarda nunca disparou uma única vez.
Por que a detecção de loop ficou quieta
A guarda de chamadas repetidas do Hermes se apoia numa tripla: (tool name, arguments, result hash). Chamadas idênticas precisam se alinhar numa sequência antes que o aviso de “enésima chamada idêntica” (ou o hard stop) possa acontecer.
O problema era o próprio hash do resultado:
- Resultados de
execute_codecarregam dois campos de contabilidade por chamada que mudam toda vez:duration_seconds(tempo de relógio) ekernel.execution_count(um contador monotônico de células do kernel). - Repetições byte a byte idênticas, portanto, geravam hashes diferentes a cada vez, e a sequência de chamadas idênticas continuava em 1.
- A segunda metade do problema é a mais afiada:
after_call()retorna cedo para ferramentas que mutam estado, eexecute_codeé uma delas — então, para essa ferramenta, só esse caminho de guarda pode disparar. Somando tudo: zero avisos. O comentário no código registra “um modelo reexecutou uma chamada execute_code vazia 147 vezes sem sinalização”; o corpo do PR registra zero avisos em 186 chamadas no incidente.
A correção: remover exatamente esses dois campos, só para o execute_code
O patch é deliberadamente restrito:
def _without_execute_code_metadata(parsed):
    if not isinstance(parsed, dict):
        return parsed
    cleaned = {k: v for k, v in parsed.items() if k != "duration_seconds"}
    kernel = cleaned.get("kernel")
    if isinstance(kernel, dict):
        cleaned["kernel"] = {k: v for k, v in kernel.items() if k != "execution_count"}
    return cleaned
O comentário explica o escopo: para qualquer outra ferramenta esses mesmos nomes de chave podem ser saída real, então mexer neles corromperia comparações de “idêntico”; resultados não-JSON geram hash exatamente como antes. Com a mudança, a detecção de repetição volta a funcionar — um aviso aparece a partir da 3ª chamada idêntica (os limiares exatos são configuráveis, abaixo).
Vale ser preciso: a issue #124072 lista quatro defeitos. Este PR corrige um deles — campos voláteis cegando os detectores de repetição. Os outros três, incluindo a mecânica de esperar por subagents em background, ficam fora do escopo aqui.
Os botões que você já tem
Esses comportamentos são configuráveis, e os padrões diferem entre execuções interativas e não assistidas:
# ~/.hermes/config.yaml
tool_loop_guardrails:
  warnings_enabled: true
  hard_stop_enabled: false                  # sessões interativas apenas avisam por padrão
  non_interactive_hard_stop_enabled: true   # gateway / cron param de forma dura por padrão
  warn_after:
    exact_failure: 2
    same_tool_failure: 3
    idempotent_no_progress: 2
  hard_stop_after:
    exact_failure: 5
    same_tool_failure: 8
    idempotent_no_progress: 5
  loop_caps:
    max_web_searches: 50    # chamadas de web_search por turno
    max_subagents: 50       # subagents criados por turno
O raciocínio é fácil de acompanhar: ninguém consegue apertar /stop numa execução não assistida, então essas plataformas param de forma dura por padrão, enquanto sessões interativas recebem um aviso primeiro para que o modelo possa se salvar. Os loop_caps são tetos por turno que se redefinem a cada turno e valem independentemente dos limiares acima — dezenas de buscas ou subagents num único turno já era patológico.
Para inspecionar os valores efetivos, hermes config get tool_loop_guardrails funciona; os subcomandos são show|edit|get|set|unset|path|env-path|check|migrate (não existe reload).
O que isso significa se você roda tarefas longas
- Não espere girando. Deixe o turno terminar e volte com a notificação em background. É dramaticamente mais barato do que manter um turno vivo com sondagens vazias — este aqui queimou 31M de tokens de leitura de cache.
- O loop custa mais de um modelo. Essas 193 chamadas auxiliares do modelo de aprovação se alinham quase uma a uma com as iterações desperdiçadas; você paga duas vezes.
- Hard stops não são rede de segurança para tudo. Mesmo funcionando corretamente, essa guarda só pega chamadas idênticas. Um modelo que reescreve cada chamada vazia escapa dela, e os tetos por turno são tudo o que resta. Sobre a mecânica vizinha, veja controle de subagent ao vivo e o que acontece quando o limite de turnos é removido.
- O significado completo dessas chaves está na nossa referência de configuração do hermes.
Status de release
O PR #124724 foi mesclado em 2026-09-27, depois da tag de release v0.21.5 (v2026.9.24), então está só na main: o hermes update vai pegá-lo.
A lição
Um timestamp que muda a cada chamada normalmente é só ruído. Ele só fica caro quando é usado para decidir se esta chamada foi igual à anterior — e aí a guarda fica cega em toda a ferramenta. A correção não adiciona outra guarda; ela faz o hash olhar apenas a parte do resultado que de fato representa o que aconteceu. Algumas dezenas de linhas, em troca de barrar a maioria daquelas 190 chamadas bem mais cedo.