Você corrigiu o arquivo, o kernel continuou rodando o código antigo: agora o execute_code avisa
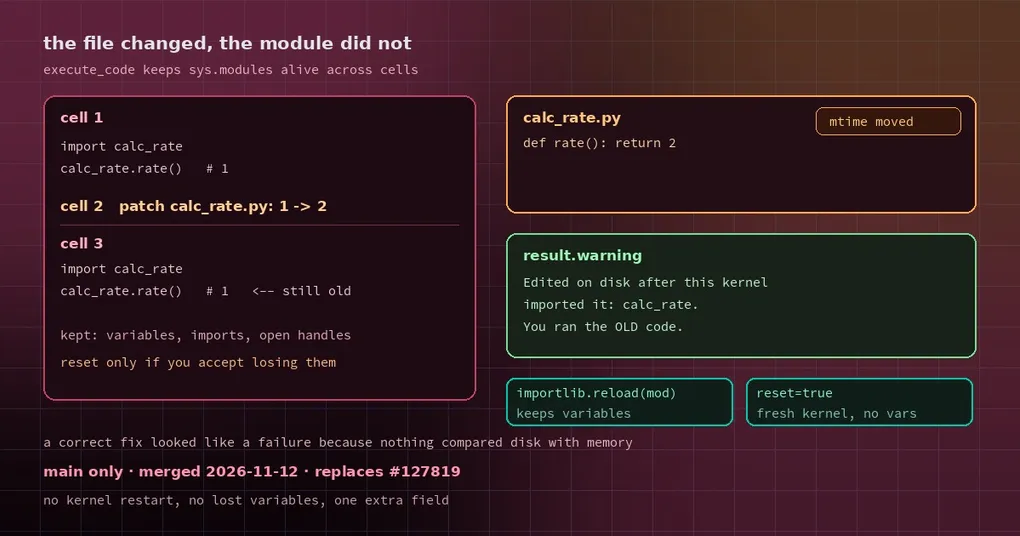
Você pede ao Hermes para corrigir um bug pequeno: calc_rate() deveria retornar 2 e retorna 1. Ele lê o arquivo, edita o código, roda via execute_code para conferir — e a saída continua 1. Ele lê o arquivo de novo, confirma que a mudança está mesmo lá, e então pede desculpas. Ou pior: “corrige” o código agora correto uma segunda vez, ou desiste e culpa o ambiente.
O que aconteceu de fato é simples. O código estava certo; o 1 vinha de um módulo stale em memória. O kernel da sessão mantém sys.modules vivo entre chamadas, o arquivo mudou em disco e nada avisou. O resultado parecia completamente normal, e é exatamente por isso que o erro era invisível.
O PR #153665, mergeado em 12 de novembro, torna isso visível: o execute_code agora nomeia os módulos que foram editados depois que o kernel os carregou.
Por que isso acontece: o Python importa uma vez
Num script comum não há problema. Cada python script.py é um processo novo, então os imports começam do zero.
O execute_code não é isso. Para deixar uma variável definida numa célula sobreviver para a próxima, ele mantém um processo de kernel vivo e roda as células dentro dele. O custo é que os objetos de módulo em sys.modules também continuam vivos — se o seu import calc_rate aconteceu antes da edição, aquele objeto é a versão antiga para sempre.
Isso gera um tipo de inconsistência especialmente irritante: o arquivo está correto, o read_file mostra o conteúdo correto, o raciocínio do modelo está correto, e só o resultado da execução está stale. Nada na saída distingue o caso, então o modelo tem que adivinhar.
O que mudou: um registro de mtime por célula
O kernel agora faz duas coisas:
- Depois que cada célula roda, ele registra o mtime da fonte de todo módulo do projeto que a sessão importou.
- Antes de rodar a célula seguinte, ele compara: qualquer arquivo cujo mtime mudou tem seu nome colocado no
warningdo resultado.
Módulos da biblioteca padrão e de site-packages / dist-packages são ignorados — você não precisa saber o que um pacote pip fez. A varredura lê o dict de cada módulo e ignora o que não consegue ler, então uma entrada estranha em sys.modules (um módulo lazy, um objeto que não é módulo) nunca faz uma célula falhar. Os nomes vêm do processo da célula, então o host guarda apenas identificadores pontuados simples e os redige do mesmo jeito que redige o stdout.
O resultado fica assim (verbatim; kernels locais colocam em warning, kernels remotos em kernel.warning):
Edited on disk after this kernel imported it: calc_rate. If this cell used it
without reloading, it ran the OLD code. Run importlib.reload(<module>) (and
re-import any names taken from it), or call again with reset=true to start
from fresh imports.
O mesmo prompt nas duas árvores, com nvidia/nemotron-3.5-super-vl no Nous Portal:
| Antes | Depois | |
|---|---|---|
| Saída da terceira célula | rate 1 | rate 1 |
| Resultado da terceira célula | sem warning | warning nomeando calc_rate e as duas correções |
| Relato do próprio modelo | “printed rate 1 and there was no warning text” | “printed rate 1 and warned: edited on disk after this kernel imported it” |
| Estado do kernel | mantido | mantido |
Essa última linha é a importante: nada é descartado. Variáveis, imports e handles abertos sobrevivem todos. O resultado apenas ganha um campo. Cada edição é nomeada uma vez, e um módulo que foi recarregado ou reimportado depois da edição não é nomeado de novo.
Duas correções, custos diferentes
Opção um: importlib.reload(). Mantenha suas variáveis, recarregue o módulo:
import importlib
import calc_rate

importlib.reload(calc_rate)
calc_rate.rate()   # now runs the new code from disk
Um detalhe que o warning também menciona: from mod import f liga o nome ao objeto antigo, e um reload não muda isso. Ou reimporte, ou sempre chame pelo módulo (mod.f()).
Opção dois: reset=true. Comece um kernel novo com imports limpos. O custo é que toda variável da sessão se vai — se você acabou de gastar dez minutos carregando um DataFrame grande, não faça isso.
Por que não simplesmente reiniciar o kernel a cada mudança de arquivo
Um PR anterior (#127819) fazia exatamente isso: qualquer arquivo .py editado sob a pasta de trabalho reiniciava o kernel inteiro. Grosseiro, mas simples — exceto que jogava fora toda variável e todo dataset carregado, mesmo quando o arquivo editado nunca tinha sido importado.
A abordagem que entrou é mais estreita: o kernel continua vivo, só módulos que o kernel realmente importou são reportados, e a mensagem declara o custo. Os trade-offs aparecem no que ela deliberadamente não cobre, e conhecer esses limites é mais útil do que conhecer a feature:
- Módulos de extensão compilada (
.so,.pyd) e módulos sem um__file__.pynão são observados. - Um módulo importado e depois editado dentro da mesma célula não é reportado — o kernel não consegue distinguir essa ordem do usual escrever-e-importar.
- Uma edição seguida de um reload que falha (um
SyntaxError, por exemplo) deixa o código antigo carregado, e nenhuma célula posterior avisa de novo; o traceback fica no resultado daquela célula. - A varredura não consegue dizer se a célula realmente usou o módulo, então o texto é condicional (“se esta célula o usou sem recarregar”) em vez de uma afirmação.
O que isso muda no dia a dia
Se o seu loop é “o agente escreve código → roda → vê uma falha → edita → roda de novo”, este warning elimina várias rodadas de adivinhação. Quando você o vê, o movimento certo é um reload ou um reset, não outra olhada na edição.
Dois casos vizinhos que também parecem bugs mas não são: o detector de loop disparando em trabalho legítimo e replays depois de editar e reenviar. A lista completa de argumentos da ferramenta, incluindo reset, está na referência de comandos.
Status de release
O PR #153665 entrou em main em 12 de novembro de 2026, e o título dele diz abertamente que substitui o #127819. A v0.23.1 saiu em 10 de novembro e não o inclui — espere o próximo release ou instale a partir de main. O novo parágrafo “Edited modules” em code-execution.md entrou no mesmo commit.
Atualização (17/11/2026): essas mudanças saíram na v0.23.2 (16 de novembro): um
hermes updateas traz. O « não está na v0.23.1 » acima é um retrato da data de publicação.