Seu prompt cache expira em silêncio. Agora o Hermes mostra quando
Sexta à noite você deixa uma sessão longa de refactoring aberta. Cada turno daquela tarde saiu barato: o mesmo system prompt de 40.000 tokens e o mesmo contexto de arquivos subiram uma vez, e o provider cobrou uma fração do preço para enviá-los de novo. Segunda de manhã você retoma a sessão, manda um follow-up pequeno, e a fatura daquele único turno parece a de uma conversa do zero. Nada mudou na sua configuração. Você simplesmente não tem ideia se o cache expirou no fim de semana, se a troca de modelo que testou na sexta o resetou, ou se uma compaction de contexto reescreveu em silêncio o prefixo que o cache estava segurando.
É sobre essa incerteza que esta mudança trata. Não é um cache novo, não é um recurso novo de provider — é um relógio que registra o que de fato aconteceu com o seu prompt cache, e uma única linha no /context que diz por quanto tempo você ainda pode contar com ele.
Prompt caching é um desconto com prazo de validade
A ideia é simples. Os providers permitem marcar parte de um request como reutilizável. Eles mantêm o prefixo já processado do lado deles por um tempo, e quando o próximo request começa com o mesmo prefixo, cobram a parte cacheada a uma taxa bem menor em vez de processar tudo de novo. Numa sessão longa de agent, com um system prompt grande, schemas de tools estáveis e uma transcrição que cresce, esse desconto é a maior parte da sua conta.
O problema está no “por um tempo”. Cada provider escreve isso de um jeito:
- O cache da Anthropic tem cinco minutos por padrão e pode ser pedido com uma camada de uma hora. Uma leitura de cache reinicia o relógio.
- Os modelos mais novos da OpenAI aceitam um
prompt_cache_options.ttlexplícito — 30 minutos por padrão, 12 horas sob pedido. Uma leitura mantém o piso de 30 minutos, mas não reinicia uma janela de 12 horas. - Rotas antigas da OpenAI e caches implícitos não têm mínimo publicado nenhum. Podem manter entradas por mais tempo do que o pedido; ninguém promete uma expiração exata.
Repare no que nada disso entrega: um timestamp de expiração. O que eles dão é uma retenção mínima. “Cinco minutos” significa “pelo menos cinco minutos”, não “sumiu aos cinco minutos e um segundo”. Qualquer código que trate isso como expiração está adivinhando — e o Hermes fazia essa adivinhação de forma independente em cada lugar que se importava com o assunto.
O que estava errado de fato
Dois problemas distintos se escondiam atrás da mesma ideia vaga de “o cache provavelmente está quente”.
O primeiro era adivinhação duplicada. Partes diferentes do agent derivavam um TTL por conta própria. Quando duas delas discordam, a mais barata vence por acidente: você toma uma decisão assumindo um calor que outro pedaço de código teria chamado de frio.
O segundo era pior, e custava dinheiro de verdade. No Nous Portal, o Hermes pedia a camada de cache de uma hora. O Portal guarda o cache por cerca de cinco minutos e o descarta. Ou seja: o Hermes pagava a taxa mais alta de escrita de cache por uma entrada de uma hora, e a entrada já não existia antes do turno seguinte. O request dizia “1h” no fio; a realidade era “5m”.
O PR #156101 corrige os dois ao transformar a janela de cache em um fato registrado, em vez de um palpite recalculado.
Um só relógio, registrado a cada tentativa
O módulo novo é agent/prompt_cache_clock.py. Para cada tentativa de modelo bem-sucedida que tocou o cache, ele registra um evento:
- a rota completa (provider, base URL normalizada, modelo),
- a camada efetivamente enviada no fio — lida do payload, não da config: o ttl de
cache_controlda Anthropic, oprompt_cache_options.ttlda OpenAI, oprompt_cache_retentionantigo, - o horário de envio,
- as contagens de tokens de leitura e de escrita,
- a camada ou camadas que a resposta comprovou (contadores ephemeral 5m/1h da Anthropic, contadores ttl_30m/ttl_12h da OpenAI),
- e a cobertura resultante: um deadline por camada que o prefixo cacheado sustenta.
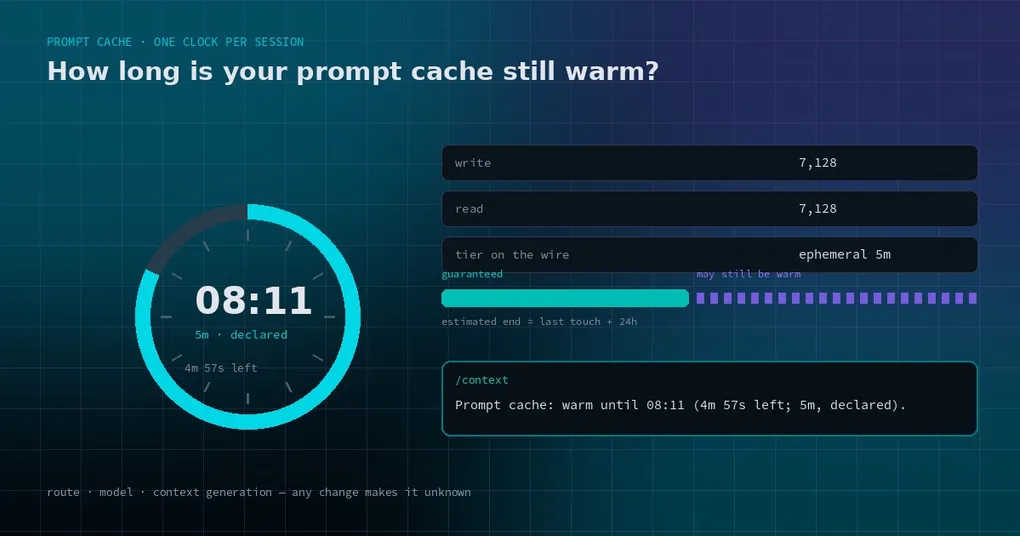
Essa última parte é a que importa. O relógio não guarda “TTL = 300 segundos”. Ele guarda “este prefixo cacheado está coberto até 08:11, porque uma camada de 5 minutos foi escrita às 08:06 e a resposta confirmou isso”. Um deadline é algo que você pode comparar com o horário atual; um TTL é algo que você precisa derivar de novo, e toda rederivação é uma chance de errar.
Como o evento está amarrado ao id da sessão, à rota completa e à geração de contexto durável da sessão, ele também consegue dizer unknown com honestidade. Troque de modelo, caia para outro provider ou rode uma compaction que arquiva linhas, e o deadline antigo deixa de descrever o prompt que você está prestes a enviar. O Hermes rebaixa a janela para unknown em vez de fingir.
As regras de renovação mudam por provider, então elas são dados
Um deadline de cache não é “horário de escrita mais TTL”. Ele depende do que uma leitura faz com a janela, e os providers discordam:
| Classe de rota | Numa leitura de cache | Regra do deadline |
|---|---|---|
| Anthropic (nativo, OpenRouter Claude, gateways no protocolo da Anthropic) | reinicia a camada | horário da leitura + camada |
| OpenAI GPT-5.6 e mais novos, camada de 30 m | renova o piso | max(existente, leitura + 30 m) |
| OpenAI GPT-5.6 e mais novos, camada de 12 h | não reinicia | horário da escrita + 12 h, fixo |
| Todo o resto | nenhuma garantia publicada | sem deadline garantido, só fim estimado |
É por isso que o módulo mantém um dict de handlers por rota em vez de uma fórmula única. A regra da Anthropic e a da OpenAI são comportamentos genuinamente diferentes, e uma regra única de “soma o TTL da última atividade” estaria errada para pelo menos uma delas. Na rota de 12 horas ela estaria muito errada: uma conversa longa ficaria parecendo quente para sempre, porque toda leitura empurraria o deadline para frente.
Duas pontas de uma mesma janela, porque um mínimo não é uma expiração
Aqui está a decisão de design que torna a linha do /context honesta. Toda janela tem duas pontas:
guaranteed_until— o deadline de cobertura mais cedo. Se uma resposta escreveu tanto uma camada de 5 minutos quanto uma de uma hora, o prefixo só está garantido por cinco minutos, então esse é o número.Nonesignifica nenhuma garantia.estimated_until— o ponto depois do qual a entrada certamente se foi. Para as camadas da Anthropic isso é exato, porque a camada é exata. Para a OpenAI é o último toque mais 24 horas, porque a OpenAI diz que as entradas podem ser retidas além do mínimo pedido e mantém o estado do cache por no máximo um dia. Para o modoin_memoryantigo, é até uma hora.
Entre as duas, a resposta honesta é “may still be warm”. É uma resposta real, não uma fuga: ela diz que um miss é possível e que um hit é possível, e evita que você planeje em cima de uma garantia que não existe. Os consumidores perguntam cache_certainly_warm ou cache_certainly_cold, e tudo que é desconhecido não é nem uma coisa nem outra.
O que o /context mostra agora
Quatro formatos, todos em uma linha:
Prompt cache: warm until 08:11 (4m 57s left; 5m, declared).
Prompt cache: may still be warm until 08:36 (29m 57s left; 30m, proven).
Prompt cache: expired 12m ago (5m, proven).
Prompt cache: unknown — the route changed since this cache was written.
O rótulo no fim é um nível de confiança, e ele importa:
- proven — a própria resposta nomeou a camada que manteve. É a evidência mais forte disponível.
- declared — o Hermes enviou aquela camada numa rota conhecida por honrá-la, e nada a invalidou.
- assumed — nenhuma garantia publicada; trate como palpite.
- unknown — o cache mudou de lugar (troca de rota, fallback, compaction, rotação de sessão), não há retenção publicada, ou o evento gravado não pôde ser lido.
Mais um detalhe que vale saber: ler o relógio é advisory. Se a leitura no SQLite falhar, ou se o RPC do dono de um worker estiver indisponível, a janela vira unknown com um motivo. Ele nunca levanta exceção para dentro do turno que produziu a sua resposta. Um recurso de relatório de custo não deveria ser capaz de quebrar uma conversa.
Os números da execução real
O autor do PR rodou o mesmo cenário de dois turnos em três rotas — o turno um escreve o cache, o turno dois retoma a conversa em um processo novo com --resume, então a prova salva precisa sobreviver a um restart:
| Rota | Antes | Depois |
|---|---|---|
Nous Portal via custom, cache_ttl: 1h |
o fio dizia ttl: 1h, nenhuma linha de cache no /context |
o fio diz ephemeral (5 m); 7.128 tokens escritos; warm until 08:11 (4m 57s left; 5m, declared) |
OpenAI gpt-5.6-luna, Responses, 30 m padrão |
nenhuma linha de cache, detalhes de tokens de escrita descartados | 6.662 escritos; warm until 08:36 (29m 57s left; 30m, proven), fim estimado +24 h |
OpenAI gpt-5.6-luna, ttl: 12h via extra_body |
n/a | 6.664 escritos; warm until 20:06 (11h 59m left; 12h, proven); a leitura retomada deixou o deadline inalterado |
As estimativas de cobrança, com os preços do próprio Hermes: cerca de US$ 0,029 para a execução no Nous e US$ 0,009 para a execução de 30 minutos na OpenAI. A execução de 12 horas passou por uma rota custom que o Hermes não precifica, então aparece US$ 0,00. Esses valores são pequenos porque os prompts têm uns 6,7 mil tokens — o ponto é o formato da diferença, não os centavos.
Como usar isso hoje
Você não precisa configurar nada para ter a linha no /context; ela aparece assim que um turno ler ou escrever o cache numa rota que o Hermes sabe classificar. Dois knobs valem a pena:
1. Pare de pedir uma camada que o provider não mantém. Se você fixou um cache de uma hora numa rota que descarta entradas depois de cinco minutos, o Hermes agora envia o que a rota realmente honra. No Nous Portal, isso é a camada de 5 minutos.
2. Peça uma camada mais longa onde ela é de fato suportada. Os modelos mais novos da OpenAI aceitam um TTL maior via prompt_cache_options. Configure por custom provider:
custom_providers:
  - name: openai-long-cache
    base_url: https://api.openai.com/v1
    api_key_env: OPENAI_API_KEY
    model: gpt-5.6-luna
    extra_body:
      prompt_cache_options:
        ttl: 12h
Depois confira o /context após o primeiro turno. Se a linha disser 12h, proven, você tem uma janela real de 12 horas. Se disser unknown, a rota não confirmou a camada — volte a tratá-la como palpite.
O que ainda não faz
Seja preciso sobre o escopo. Esta mudança registra e reporta; ela ainda não age sobre a janela. A docstring do módulo nomeia os consumidores futuros pretendidos: pings de keep-alive antes de guaranteed_until, poda de cache frio e compaction ociosa que evita jogar fora um prefixo que você está prestes a reutilizar. Nada disso entra aqui.
Ela também está só na main, não na v0.23.1 (marcada em 9 de novembro de 2026). Se você roda uma release estável, o /context ainda não tem linha de cache. E três rotas não foram exercitadas ao vivo porque as chaves não estavam disponíveis: OpenRouter Claude com a camada de uma hora, a prova ephemeral_1h nativa da Anthropic, e escritas mistas de 5 m e 1 h. Elas são cobertas por testes unitários, o que é evidência mais fraca que uma execução real, então trate essas afirmações específicas de acordo.
Atualização (17/11/2026): essas mudanças saíram na v0.23.2 (16 de novembro): um
hermes updateas traz. O « não está na v0.23.1 » acima é um retrato da data de publicação.
Um checklist curto para manter o cache quente
O relógio, sobretudo, torna visível um problema de custo que já existia. Quando você consegue ver a linha, os hábitos vêm atrás:
- Não troque de modelo no meio da tarefa se a economia de cache importa para você. Trocar de modelo muda a rota, e a janela vira
unknownpor design. - Fique de olho nas compactions. Uma compaction arquiva linhas, muda a geração de contexto e invalida a janela registrada — mesmo que o novo prefixo por acaso pareça parecido.
- Mantenha o começo do prompt estável. System prompt, schemas de tools e o contexto inicial de arquivos são o que fica cacheado. Reordenar tools ou editar o system prompt no turno 30 joga fora o desconto de tudo o que vem depois.
- Leia o rótulo de confiança, não só o horário.
provené evidência;declaredé intenção;assumedé palpite. Planejar uma execução autônoma longa em cima de uma janelaassumedé exatamente como você leva uma fatura surpresa.
Se você vinha tratando “o cache provavelmente ainda está quente” como fato, esta é a primeira vez que o Hermes consegue te dizer se está ou não. Para a visão pelo lado dos tokens do mesmo problema, nossos posts anteriores sobre prompt caching em subagentes irmãos e sobre medição de janela no Claude cobrem o que mais mexe na conta; a referência de configuração mostra onde essas chaves ficam.