提示词缓存悄悄过期了:Hermes 现在直接告诉你还剩多久
周五晚上你留着一个很长的重构会话没关。那个下午每次对话都很便宜:四万 token 的系统提示词和文件上下文只上传了一次,后面再发送时服务商只收零头的钱。周一早上你恢复这个会话,只补了一句小问题,账单却像开了一个全新对话。你的配置一点没动,只是你根本不知道:缓存是周末过期了?还是周五试的那个模型切换把它重置了?又或者是一次上下文压缩悄悄改写了缓存持有的那段前缀?
这次改动解决的就是这种“说不清”。它不是新缓存,也不是新的服务商能力,而是一个时钟——记录你的提示词缓存实际发生了什么,并在 /context 里用一行字告诉你还能依赖它多久。
提示词缓存是打折,而且有保质期
原理不复杂。服务商允许你把请求里的一部分标记为“可复用”。他们把处理过的前缀在自己那边留一段时间,下一次请求如果开头完全相同,这部分就按很低的折扣价计费,不用重新处理。对一个会话很长、系统提示词很大、工具定义稳定的 Agent 来说,这个折扣基本就是账单的大头。
问题出在“留一段时间”上,每家说法还不一样:
- Anthropic 的缓存默认 5 分钟,也可以申请 1 小时档。发生一次缓存读取,计时会重新开始。
- OpenAI 较新的模型接受显式的
prompt_cache_options.ttl,默认 30 分钟,也可以要 12 小时。读取会把 30 分钟的下限往后推,但不会重新启动 12 小时窗口。 - 更老的 OpenAI 路由和隐式缓存根本不公布下限。它们可能比申请的时间留得更久,但没人承诺准确的过期时刻。
注意,这些说法里都没有给你“过期时间戳”,只给了最短保留时间。“5 分钟”的意思是“至少 5 分钟”,不是“到 5 分零 1 秒就没了”。任何把它当成过期时间的代码都是在猜——Hermes 以前就在每个关心缓存的地方,各自猜了一遍。
原来到底哪里错了
同一个模糊的“缓存应该还热着”,背后藏着两个不同的问题。
第一个是重复猜测。Agent 的不同部分各自推算 TTL。两边结论不一致时,往往是不那么保守的那个悄悄胜出:你基于“还热”做了决定,而另一段代码会判定为“已经冷了”。
第二个更糟,而且是真金白银。在 Nous Portal 上,Hermes 申请的是 1 小时缓存档,而 Portal 大约 5 分钟后就把缓存丢掉。结果是:Hermes 按更高的“写缓存”费率,为一个只活 5 分钟的条目付了 1 小时档的钱。请求线上写的是 1h,现实是 5m。
PR #156101 把这两件事一起修了:缓存窗口从“每次重新推算”变成“写入记录的事实”。
一个时钟,每次请求都记下来
新模块是 agent/prompt_cache_clock.py。对每一次成功且读写过缓存的模型请求,它记录一个事件:
- 完整路由(服务商、归一化后的 base URL、模型);
- 线上真正发出去的档位——从发送的 payload 里读,不是从配置里读:Anthropic 的
cache_controlttl、OpenAI 的prompt_cache_options.ttl、老路由的prompt_cache_retention; - 发送时间;
- 读、写 token 数;
- 响应证明了哪些档位(Anthropic 的 ephemeral 5m/1h 计数、OpenAI 的 ttl_30m/ttl_12h 计数);
- 由此得到的覆盖范围:这个缓存前缀持有的每个档位,各有一个截止时间。
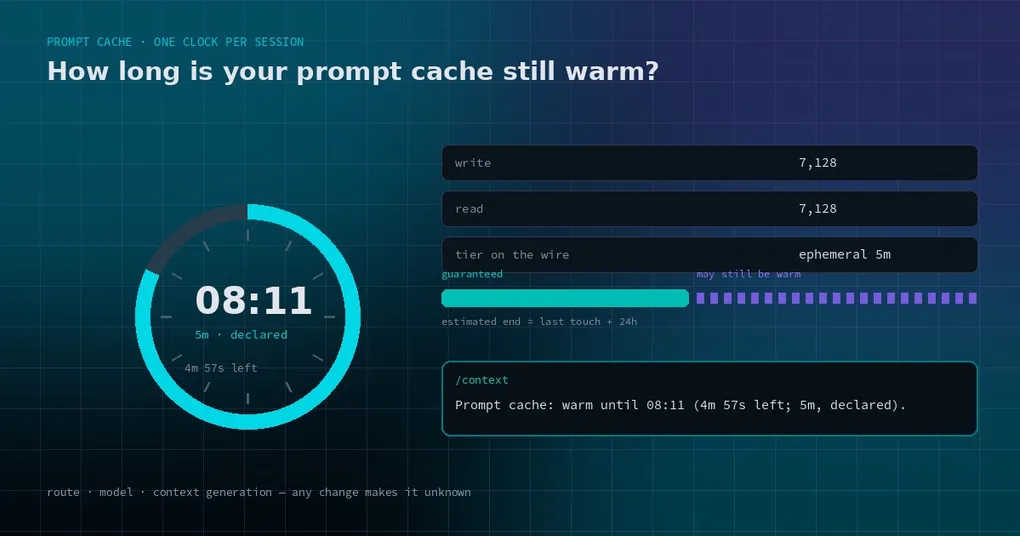
最后这条是真正有用的部分。时钟存的不是“TTL = 300 秒”,而是“这段缓存前缀在 08:11 之前有效,因为 08:06 写入了一个 5 分钟档,并且响应确认了它”。截止时间可以直接和当前时间比较;TTL 每次都要重新推算,而每一次推算都是一次出错的机会。
因为这些事件绑定了会话 id、完整路由,以及会话那个持久化的“上下文代次”(compaction 或 prune 归档了多少行,重启后依然有效、只增不减),所以它也能诚实地回答“不知道”。你换了模型、回退到别的服务商、或者跑了一次会归档行的压缩,旧截止时间就不再描述你即将发送的那段提示词了。Hermes 会把窗口置为 unknown,而不是假装还有效。
刷新规则按服务商区分,所以写成了数据
缓存截止时间不是简单的“写入时间加 TTL”。它取决于一次读取会把窗口怎么样,而各家行为不同:
| 路由类型 | 发生缓存读取时 | 截止时间规则 |
|---|---|---|
| Anthropic(原生、OpenRouter Claude、Anthropic 协议网关) | 重新开始该档位 | 读取时间 + 档位时长 |
| OpenAI GPT-5.6 及更新,30 分钟档 | 刷新下限 | 取“原截止”和“读取 + 30 分钟”的较大值 |
| OpenAI GPT-5.6 及更新,12 小时档 | 不重新开始 | 写入时间 + 12 小时,固定 |
| 其他 | 没有公开保证 | 只有估算终点,没有保证截止 |
这就是模块里为每种路由保留一个处理函数、而不是套一个公式的原因。Anthropic 和 OpenAI 的规则是两种真实存在、彼此不同的行为;只用“最后活动时间加 TTL”,至少会错一家。在 12 小时那条路上会错得很厉害:长对话每次读取都会把截止时间往后推,于是缓存看起来永远是热的。
一个窗口有两个端点,因为“最短保留”不等于“过期”
这是让 /context 那行字变诚实的关键设计。每个窗口都有两端:
guaranteed_until:最早的覆盖截止时间。如果一次响应同时写了 5 分钟和 1 小时两个档,前缀只保证 5 分钟,那就取 5 分钟。None表示没有任何保证。estimated_until:过了这个点,条目一定不在了。Anthropic 的档位是精确的,所以它就是最晚的覆盖截止;OpenAI 说条目“可能比申请的最短时间留得更久”、缓存状态最多保留 24 小时,所以取最后触达时间加 24 小时;老的in_memory模式最多 1 小时。
两端之间,诚实的答案是“可能还热”。这不是踢皮球:它明确告诉你“可能命中、也可能没有”,同时阻止你基于一个并不存在的保证去做计划。消费方调用 cache_certainly_warm 或 cache_certainly_cold,而任何“未知”都不属于两者。
/context 现在长什么样
四种形态,都是一行:
Prompt cache: warm until 08:11 (4m 57s left; 5m, declared).
Prompt cache: may still be warm until 08:36 (29m 57s left; 30m, proven).
Prompt cache: expired 12m ago (5m, proven).
Prompt cache: unknown — the route changed since this cache was written.
结尾那个标签是置信度,很重要:
- proven:响应本身点名了它保留的档位,这是能拿到的最强证据。
- declared:Hermes 在一个已知遵守该档位的路由上发出了这个档位,且之后没有失效事件。
- assumed:没有公开保证,请当成猜测。
- unknown:缓存已经“移动”(换了路由、回退、压缩、会话轮换),或者该路由没有公开保留策略,或者存下来的事件读不出来。
还有一个细节值得知道:读取这个时钟是旁路查询。如果 SQLite 读失败,或者 worker 的 owner RPC 不可用,窗口会变成 unknown 并给出原因,绝不会把异常抛进产生这次回复的回合里。一个成本统计功能,不该有能力弄坏一次对话。
实测跑出来的数字
PR 作者在三条路由上跑了同样的两回合场景:第一回合写缓存,第二回合用 --resume 在新进程里恢复会话,这样“保存下来的证据”必须能扛过重启:
| 路由 | 改动前 | 改动后 |
|---|---|---|
Nous Portal 走 custom,cache_ttl: 1h |
线上是 ttl: 1h,/context 没有缓存行 |
线上变成 ephemeral(5 分钟);写入 7,128 token;显示 warm until 08:11 (4m 57s left; 5m, declared) |
OpenAI gpt-5.6-luna,Responses,默认 30 分钟 |
没有缓存行,写 token 明细被丢弃 | 写入 6,662;显示 warm until 08:36 (29m 57s left; 30m, proven),估算终点加 24 小时 |
OpenAI gpt-5.6-luna,通过 extra_body 设 ttl: 12h |
无 | 写入 6,664;显示 warm until 20:06 (11h 59m left; 12h, proven);恢复后的读取没有改动截止时间 |
按 Hermes 自己的价格估算:Nous 那次约 $0.029,30 分钟的 OpenAI 那次约 $0.009。12 小时那次走的是 Hermes 不报价的 custom 路由,所以显示 $0.00。数字小是因为提示词只有约 6.7k token——重点在差异的形态,不在那几分钱。
今天怎么用
/context 那行字不需要任何配置:只要某个回合在 Hermes 认得的路由上读写过缓存,它就会出现。有两个开关值得知道:
1. 别再申请服务商根本不保留的档位。 如果你在一个 5 分钟就丢条目的路由上钉了 1 小时缓存,Hermes 现在发的是这条路由真正遵守的档位。Nous Portal 上就是 5 分钟档。
2. 在确实支持的地方申请更长的档。 OpenAI 较新的模型可以通过 prompt_cache_options 要更长的 TTL,按自定义服务商配置:
custom_providers:
  - name: openai-long-cache
    base_url: https://api.openai.com/v1
    api_key_env: OPENAI_API_KEY
    model: gpt-5.6-luna
    extra_body:
      prompt_cache_options:
        ttl: 12h
第一回合结束后看一眼 /context。如果写着 12h, proven,你手里是真正的 12 小时窗口;如果写着 unknown,说明这条路由没有确认档位,那就继续把它当猜测。
它现在还不做什么
范围要说清楚。这次改动是记录和报告,还没有根据窗口采取行动。模块文档里点名了未来的消费方:在 guaranteed_until 之前做保活、冷缓存清理、以及在空闲压缩时避免扔掉你马上要复用的前缀。这些都还没随本次改动上线。
另外它只在 main 上,不在 v0.23.1(2026 年 11 月 9 日打的 tag)里。你跑稳定版的话,/context 暂时没有缓存行。还有三条路由因为拿不到 key 没有实测:OpenRouter 的 Claude 1 小时档、原生 Anthropic 的 ephemeral_1h 证明、以及 5 分钟与 1 小时混合写入。它们有单元测试覆盖,但单元测试的证据强度低于实跑,这几条请按“未实测”看待。
更新(2026-11-17):这里说的改动已随 v0.23.2 发布(2026-11-16),
hermes update就能拿到。上文「不在 v0.23.1 里」是发布当时的快照。
让缓存保持温热的几条习惯
这个时钟主要是把原本看不见的成本问题变得可见。一旦你能看到那行字,习惯自然就有了:
- 别在任务中途换模型(如果你在意缓存成本)。换模型就是换路由,窗口会按设计变成
unknown。 - 留意压缩。 compaction 会归档行、改变上下文代次,从而让记录下来的窗口失效——哪怕新前缀看起来差不多。
- 保持提示词头部稳定。 系统提示词、工具 schema、早期的文件上下文才是被缓存的部分。第 30 回合突然重排工具或改系统提示词,等于把后面所有折扣都丢了。
- 看置信度,不只看时间。
proven是证据,declared是意图,assumed是猜测。围绕一个assumed窗口去规划长时间自主运行,就是账单惊喜的来源。
如果你一直把“缓存应该还热着”当成事实,这是 Hermes 第一次能告诉你它到底热不热。同一个账单问题的 token 视角,可以看我们之前写的子代理提示词缓存和 Claude 窗口计量;这些键放在哪里,见配置参考。